摘要
像 ChatGPT 这样的大型语言模型最近在自然语言理解和生成方面展示了令人印象深刻的能力,支持各种应用程序,包括翻译、论文写作和聊天。但是,有人担心它们可能会被滥用于恶意目的,例如欺诈或拒绝服务。因此,开发检测参与对话的一方是机器人还是人类的方法至关重要。在本文中,我们提出了一个名为 FLAIR 的框架,通过单一查询和R发现大型语言模型的真实性响应,以在线方式检测会话机器人。具体来说,我们针对可以有效区分人类用户和机器人的单个问题场景。这些问题分为两类:一类是人类容易但机器人很难的问题(例如,计数、替换、定位、噪声过滤和 ASCII 艺术),另一类是机器人容易但人类很难的问题(例如,记忆和计算)。我们的方法显示了这些问题在有效性方面的不同优势,为在线服务提供商提供了一种新方法来保护自己免受恶意活动的侵害,并确保他们为真实用户提供服务。我们在https://github.com/hongwang600/FLAIR上开源了我们的数据集,并欢迎社区贡献以丰富此类检测数据集。
1 介绍
最近,GPT-3 、PaLM 和 ChatGPT等大型语言模型 (LLM) 的发展 为自然语言处理带来了显着进步,在语言理解等下游任务中实现了卓越的性能,问答系统和对话系统。这些模型在理解和生成类人语言方面表现出了非凡的能力,为医疗、教育、金融和娱乐等各个领域带来了好处。凭借从海量数据中学习的能力,这些模型不断改进并变得更加通用,为令人兴奋的新应用铺平了道路。
然而,随着这些模型的激增,人们开始担心它们可能被用于恶意目的。最严重的威胁之一是使用大型语言模型来冒充人类用户并从事恶意活动,例如欺诈、垃圾邮件或拒绝服务攻击。例如,ChatGPT 代理可以被黑客用来占领各种公司的所有客户服务渠道,例如电子商务、航空公司和银行。此外,在文本转语音(TTS)技术的帮助下,机器生成的语音甚至可以占用公共服务热线,如 911,导致严重的公共危机。这些攻击可能会对在线服务提供商及其用户造成重大伤害,削弱在线交互的信任和完整性。
区分人类用户和恶意机器人是业界和学术界长期关注的话题。传统技术,例如使用验证码 ( captcha ), 已开发用于确定用户是人类还是机器人,以防止机器人垃圾邮件和攻击。一种常用的验证码方法涉及要求用户识别扭曲的字母和数字。然而,在检测仅涉及文本和语音的聊天机器人时,这些方法面临着重大挑战。这就是 GPT-3 和 ChatGPT 等大型语言模型的出现使聊天机器人检测问题进一步复杂化的地方,因为它们能够生成高质量的类人文本并在相当程度上模仿人类行为。尽管 DetectGPT 等最近的研究提出了分类文本是否由 ChatGPT 生成的方法,但它们主要关注离线设置。最近的一项研究表明这些检测器在释义攻击下不可靠,其中在生成文本模型之上应用轻释义器。这一限制突出表明需要更强大和准确的方法来区分大型语言模型和人类用户,并检测他们在在线聊天交互中的存在。
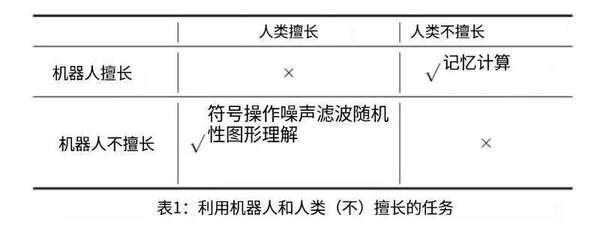
在本文中,我们提出了一个名为FLAIR的新框架,即通过单一查询和响应查找 LLM 真实性,以充分利用 LLM 的优势和劣势进行基于 LLM 的对话机器人检测。具体来说,我们介绍了一组精心设计的问题,这些问题会引起机器人和人类之间的不同反应。这些问题是为利用机器人和人类处理和生成语言的方式的差异而量身定制的。如表1所示,符号操作、噪声过滤和图形理解领域的某些问题对机器人来说很难,但对人类来说相对容易。示例包括计数、替换、定位、噪声注入和 ASCII 艺术。另一方面,记忆和计算对机器人来说相对容易,但对人类来说却很困难。具体来说,计数要求用户计算特定字符在字符串中出现的次数。替换涉及根据给定规则替换随机字符串的字符。在定位中,要求用户识别k- 之后的第一个字符j-给定角色的第次出现C在随机字符串中。随机编辑涉及对随机生成的字符串执行随机操作,例如删除、插入、交换和替换字符,并生成三个不同的输出。噪声注入提出了用附加字符修改的常识性问题。ASCII 艺术要求用户识别 ASCII 字符所描绘的内容。记忆提出的问题需要列举一个类别或特定领域的知识中的项目,这些知识对人类回忆起来具有挑战性。计算要求用户提供复杂数学问题的答案,例如计算两个随机抽取的四位数的乘积。我们的实验结果表明,FLAIR在实践中是有效的,并为传统的验证码提供了一个可行的替代方案。所提出的方法显示出有望开发更强大和准确的方法来快速检测机器人并保护在线交互。
本文的其余部分安排如下:
第2节展示了该领域的一些相关工作;
第3节和第 4节介绍了我们提出的通过分别利用其弱点和优势来检测 LLM 的方法;
第5节显示了实验结果;
最后,第6节总结了本文。
2 相关工作
2.1 验证码
CAPTCHA 是一种常用技术,用于阻止字典攻击、电子邮件垃圾邮件、网络爬虫、网络钓鱼攻击等恶意应用程序,有不同类型的 CAPTCHA。基于文本的验证码要求用户识别变形形式的字母和数字(baffletext;gimpy;msn-captcha),而基于图像的验证码 (image-captcha)要求用户选择具有相似属性的图像,例如交通灯。基于视频的验证码 ( video-captcha )要求用户选择描述视频的三个词,而基于音频的验证码 (audio-captcha )要求用户收听音频并提交提到的词 ( captcha-review )。Puzzle CAPTCHAs ( captchat-survey2014 )要求用户组合片段以形成完整的图片。这些技术用于区分人类用户和机器人,防止恶意活动。
2.2 大型语言模型
大型语言模型的出现显着推进了 NLP 任务和基准的最新技术水平 (SOTA)。在大规模自我监督预训练和特定任务调优范式的支持下,早期的 LLM (bert;roberta;bart;gpt;gpt2;t5)在解决文本分类、自然语言等多个下游任务方面表现出令人难以置信的能力推理、机器翻译、阅读理解等。此外,通过将表格、图像和图形等多模态知识融合到语言建模过程中,LLMs 被赋予了处理文本以外的多模态任务的能力,包括实体类型 ( erine )、节点分类 ( graph-bert )、视觉问答 ( vlbert )、多模态常识推理 ( valm )等。此外,通过扩大模型参数和上下文长度,像 GPT-3 ( gpt3 ) 这样的 LLM )甚至可以作为少数学习者工作,并通过多次演示的上下文学习来解决看不见的任务。然后,为了进一步促进 LLM 遵循用户的意图,InstructGPT ( insgpt )建议通过对人类反馈的深度强化学习使 LLM 与人类意图指令保持一致。后来,ChatGPT (chatgpt)和GPT-4 (gpt4)作为InstructGPT的最新变种,点燃了AI-Generated-Content(AIGC)的热情。通过与矢量数据库和插件工具 ( chatgpt-plugins )的协作,GPT-4 目前支持数千个下游应用程序。
2.3 CHATGPT离线检测
自推出以来,ChatGPT 已得到广泛使用,并引发了公众对潜在滥用的担忧。例如,学生可能会使用 ChatGPT 完成书面作业,这使得教师很难准确评估学生的学习情况。因此,越来越需要检测一段文本是否由 ChatGPT 编写。为了解决这个问题,DetectGPT 通过将原始段落的对数概率与同一段落的扰动概率进行比较,提出了一个解决方案。该方法背后的假设是,与原始样本相比,对模型生成的文本进行较小的重写可能会导致对数概率较低,而对人类编写的文本进行较小的重写可能会导致对数概率更高或更低。另一行研究将该问题建模为二元分类问题,并使用监督数据( detect_anton )微调另一个模型 。最近,mitrovic2023chatgpt微调了一个基于 Transformer 的模型并使用它进行预测,然后使用 SHAP 进行解释。 另一个研究领域侧重于为 AI 生成的文本添加水印以促进其识别,这涉及在文本上印上特定图案以使其更易于检测 ( invisible_watermarking )。软水印,如soft_watermark所提议的那样,涉及将令牌划分为绿色和红色列表以创建这些模式。在生成文本时,带有水印的 LLM 更有可能从绿色列表中选择一个标记,该标记由前缀标记确定。这些水印通常很微妙,人类很难注意到。
但是,如question_on_detection中所示,一系列检测方法,包括水印方案、基于神经网络的检测器和零样本分类器,可以很容易地被释义攻击击败。这些攻击涉及将轻量解释器应用于语言模型生成的文本。此外,理论分析表明,在处理足够好的语言模型时,即使是最好的检测器也只能比随机分类器表现好一点点。这凸显了离线检测由高级语言模型生成的文本的根本挑战,这些文本可以生成与人类编写的文本几乎无法区分的文本。因此,将重点转移到用户与系统进行实时聊天交互的在线检测设置上更有意义也更重要。
在下面的讨论中,我们将展示我们的FLAIR框架,用于在用户与系统进行实时对话的在线环境中检测大型语言模型,例如 ChatGPT。我们的方法涉及向用户提问,并根据答案的正确性将机器人与人类区分开来。我们将FLAIR分为两种类型。第一类包括对 LLM 来说很难但对人类来说很容易的问题。这些类型的问题通常需要符号操作、噪声过滤和图形理解等技能,这些都不是 LLM 的强项qian2022limitations. 可以通过使用失败的测试用例微调 LLM 或使用特定例程的插件来绕过这些测试。我们认为这些测试显示了 LLM 内部的根本弱点。第二种类型包括对 LLM 很容易但对人类很难的问题。这些问题通常需要记忆和计算,这不是人类的强项。在以下部分中,我们将详细讨论它们中的每一个。
3 利用LLM的弱点
3.1 计数
最先进的 LLM 无法准确计算字符串中的字符数,而人类可以轻松做到。LLM 的这种局限性启发了计数FLAIR的设计,以区分人类和 LLM。要求参与者计算特定字符在给定字符串中出现的次数。为了增加问题的难度,在字符串中显式地增加了字符的出现。生成的问题用作 LLM ( gpt3 ; insgpt )的提示。这是一个示例问答提示以及 GPT-3、ChatGPT 和人类生成的结果:
问:请数出 eeooeotetto 中的 t 数量
GPT-3:eeooeotetto 中有 5 个 t。
ChatGPT:字符串“eeooeotetto”中共有5个t。
人类:3
从例子中我们可以看出,GPT-3 和 ChatGPT 都无法准确计算给定字符在字符串中出现的次数,而人类可以轻松给出正确答案。
3.2 代换
众所周知,LLM 经常输出与上下文不一致的内容 (inconsistency1;inconsistency2)。这是当前 LLM 的共同弱点。我们要求LLM根据给定的替换规则拼写一个随机单词,测试他们是否能够始终如一地遵守规则。随机词的长度在五到十个字符之间,是从字典中随机抽取的。下面是一个用于测试 LLM 和人类的例子:
问:用 m 代替 p,a 代替 e,n 代替 a,g 代替 c,o 代替 h,如何在此规则下拼?
GPT-3:mogno
ChatGPT:使用给定的规则替换字母,“peach”将拼写为“enmog”。
人类:芒果
尽管 LLM 在预训练期间已经接受过学习“替换”规则的训练,但他们仍然难以像在上述替换任务中那样始终如一地反复应用该规则。该测试概念可以进一步推广到基于规则转换字符串的加密方案。
3.3 定位
继LLM为什么不能算的猜测之后,我们进一步探讨了LLM是否具备定位能力。对于每个问题,都会根据 2.1 小节中描述的相同规则生成一个随机字符串。LLM应该输出k- 之后字符串中的第一个字符j-给定角色的第次出现C, 在哪里k和j是随机整数和C是从字符串中的字符集中选择的随机字符。下面的问题是一个例子:
问:请输出字符串 rjsjuubrjjsjsucuj 中第二个 s 之后的第 4 个字符
GPT-3: u
ChatGPT: 字符串“rjsjuubrjjsjsucuj”中的第二个“s”位于索引 6(从0),所以它之后的第 4 个字符位于索引 10。因此,输出是字母“j”。
人类:c
在这个例子中,ChatGPT 和 GPT3 都无法正确定位角色,ChatGPT 未能找到第二个 s 的位置。
3.4 随机编辑
随机编辑是一种用于评估自然语言处理模型对嘈杂输入的鲁棒性的技术。该技术涉及向模型呈现一串字符(从[0,1个]) 并随机删除、插入、交换或替换某些字符。为了验证模型是否能够执行这些随机操作,需要在相同条件下生成三个不同的输出。通过确保三个输出不同,我们可以确认模型正在应用随机操作。
对于随机丢弃,模型被要求随机删除k给定字符的出现C来自字符串,其中k是一个随机数并且C是出现在字符串中的随机字符。对于随机插入,要求模型随机插入k给定字符的出现C在随机位置进入字符串。对于随机交换,要求模型随机交换k字符对C和d在字符串中,其中C和d是字符串中出现的不同字符。最后,对于随机替换,要求模型随机替换k字符的出现C与另一个角色d在字符串中。下面我们展示了 LLM 和人类在随机丢弃任务上的输出示例:
问:随机丢弃两个1个来自字符串:0110010011,给我三个不同的输出。
GPT-3: 0111010011, 0110001011, 0110011011
ChatGPT: 010010011, 011000011, 0010010011
Human: 00010011, 01000011, 01100001
从上面的例子我们可以看出,GPT-3而 ChatGPT 在这个任务上失败了,而人类可以轻松解决这个问题.
3.5 噪声注入
我们首先使用 ChatGPT 模型生成一组常识性问题,提示如下:问 100 个常识性问题并回答,答案应该是一个单词。以下是 ChatGPT 生成的示例问答:
问:水是湿的还是干的?
答:湿
为了在问题中引入噪音,我们在每个单词后附加了某些大写字母,创建了由破折号分隔的新单词。尽管这些大写字母可能很容易被人类忽略,但它们可能会使依赖子词标记的大型语言模型 (LLM) 感到困惑。例如,我们将原来的问题“水是湿的还是干的?”转化为“是-LAND water-MELON wet-TER 还是-DER dry-YAD?”,下面是 GPT-3 和 ChatGPT 对此的提示和输出task:
Q: is-LAND water-MELON wet-TER or-DER dry-YAD?
GPT-3: A: Is-LAND water-MELON wet-TER or-DER dry-YAD?
No, 这个短语确实没有意义。
ChatGPT:对不起,我无法理解“LAND water-MELON wet-TER or-DER dry-YAD”这句话的含义。他们似乎没有形成一个连贯的句子或问题。您能否提供更多背景信息或澄清您的问题?
人:湿。
我们生成的示例问题展示了我们的方法中增加的噪音所造成的混乱。这种噪音涉及在每个单词上附加大写字母,会显着影响大型语言模型 (LLM) 的判断,因此可用于针对当前的 LLM 构建FLAIR。
3.6 ASCII 艺术
理解 ASCII 艺术需要视觉抽象能力,这是语言模型所缺乏的。我们从 ASCII Art Archive 1收集了 ASCII 艺术, 以下是 ASCII 艺术的几个示例:
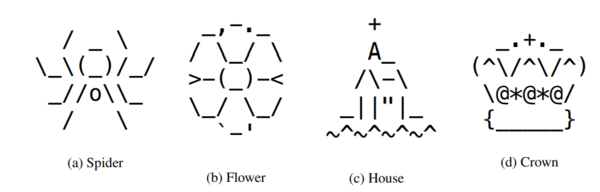
我们将与图所示格式相同的 ASCII 艺术输入 GPT-3、ChatGPT 和人类,以下是答案:
GPT-3:未知
ChatGPT:ASCII 艺术描绘了一个盘腿坐着的人以冥想或瑜伽姿势将手臂举过头顶。正斜杠代表人抬起的腿,下划线代表人的躯干,反斜杠代表人的手臂。括号和字母“o”分别代表人的手和头。总的来说,ASCII 艺术传达了一种和平与宁静的感觉。
人类:蜘蛛
图形理解仍然是LLM的挑战。尽管 ChatGPT 提供了大量分析来尝试理解 ASCII 艺术,但它无法全局处理字符以给出正确答案。ChatGPT 提供的所有分析都是基于定位字符组。
4 利用 LLM 的力量
在本节中,我们将讨论利用 LLM 优势的方法。这些问题通常对人类来说具有挑战性,但对于 LLM 来说相对容易,因为他们能够记住大量信息或执行复杂的计算,这要归功于他们的大量参数和大量语料库的预训练。另一方面,记忆和复杂的计算通常不是人类的强项。
4.1 背诵
这类问题背后的主要思想是要求用户列举给定类别中的项目。下面是来自 GPT-3 的问题和答案示例(我们只列出了输出中的一些项目):
问:列出美国所有州的首府:
GPT-3:1. 阿拉巴马州蒙哥马利 2. 朱诺, 阿拉斯加 3. 亚利桑那州菲尼克斯…… 48. 西弗吉尼亚州查尔斯顿 49. 威斯康星州麦迪逊 50. 怀俄明州夏安
对于人类来说,这类问题并不容易,因为它需要很好的记忆。设计枚举题时有多种选择。第一个选项是包含许多项目以增加人类记忆的难度,例如世界上所有的国家。第二个选项是包含人们可能没有遇到过的相对较旧的信息,例如 70 年代的所有电影。第三个选项是人们不太可能知道的特定领域信息,例如所有 Intel CPU 系列的名称。我们可以通过验证给定答案和基本事实之间的重叠来确定答案来自机器人的可能性。如果重叠大于阈值,则答案更有可能来自机器人。
除了枚举给定类别中所有项目的问题外,我们还提出了日常生活中可能不会遇到的特定领域的问题。人类可能没有强烈的动机来记住此类信息,而 LLM 已经在可能包含此类长尾和不常用信息的大型语料库上进行了预训练。以下是 GPT-3 生成的两个示例问题和答案:
π的前 50 位是什么?
GPT-3:前50位数字π是 3.1415926535897932384626433832795028841971693993751。
典型的波音 737 的客舱容积是多少?
GPT-3:典型的波音 737 客舱容积为 1,858 立方英尺。
GPT3 为所提供的问题生成的答案非常准确和精确,表明 LLM 有能力回答日常生活中不常见或遇到的长尾问题。另一方面,人类可能不具备记住此类特定信息所需的知识或动机,这可能使他们难以准确回答此类问题。因此,合并需要人类不常掌握的专业知识的问题可能是区分 LLM 和人类的有效策略。
4.2 计算
由于回忆中间步骤的挑战,在没有计算机或外部笔记的帮助下执行复杂的计算(例如乘法)对人类来说是困难的。相比之下,LLM擅长记住常见方程的结果,例如π,下面是 GPT-3 生成的示例问题和答案:
π的平方是多少?
GPT-3:π的平方是π ,等于 9.8696。
此外,通过使用 Wolfram 等外部工具,ChatGPT 插件甚至可以解决更复杂的问题,包括代数。然而,对于不常见的方程式,GPT-3 可能会产生错误的答案,正如它对问题 :
3256*354 的结果是什么
GPT-3:1153664
它提供的地方1153664而不是真正的答案1152624. 可以利用这种行为来区分 LLM 和人类,因为人类不太可能编造答案,并且通常会通过承认他们不知道解决方案来做出回应。
5 实验结果
在本节中,我们将介绍我们提出的用于区分人类和 LLM 的单个问题的实验结果。我们为每一类提出的问题整理了一个数据集,用于评估人类和法学硕士的表现。通过对比响应的准确性,我们旨在区分两者。在随后的小节中,我们描述了构建数据集的过程并报告了我们的发现。
5.1 数据集
为了评估 LLM 和人类的表现,我们为每一类问题构建了一个数据集,并将其开源在https://github.com/hongwang600/FLAIR上。
计数
我们使用整个字母表集作为候选字符集。首先,我们随机选择一个字符作为目标进行统计。然后我们随机抽取目标计数k从区间[10,20]。我们将字符串的总长度设置为 30,包括k目标字符和30−k从其余部分采样的字符。对于生成的字符串,真实答案是k.
代换
为了创建我们的数据集,我们首先收集顶部1500来自 Talk English 网站的名词22个网址: https: //www.talkenglish.com/vocabulary/top-1500-nouns.aspx. 然后,我们过滤了这些词,使其仅包含长度在 5 到 10 个字符之间的词。接下来,我们随机生成了 100 对单词,每对单词都有对应的替换映射,可以将一个单词转换为另一个单词。为了确保我们对的有效性,我们排除了任何需要将一个字符映射到多个字符的情况,这会导致冲突。向参与者提出的问题包括替换规则和原始单词,答案需要通过替换产生的另一个单词。
定位
我们使用完整的字母集作为候选字符集,我们随机生成一串长度30来自这个集合和两个随机位置索引j和k。此外,我们随机抽取另一个字符C. 向参与者提出的问题是“什么是k- 之后的第一个字符j-角色的出现C在字符串中”。这个问题的基本事实可以通过一个程序来计算,我们保证j和k是可行区间内的随机整数,例如,字符C至少出现过j次。
随机编辑
对于随机编辑,我们支持四种不同的操作,包括删除、插入、交换和替换,如第3.4节所述。对于每个操作,我们生成一个随机长度的字符串20来自[0,1个]设置以使其更易于阅读。我们随机抽取感兴趣的字符和操作次数等参数。然后要求参与者在随机操作后给出三种不同的输出。为了检查输出的正确性,我们将首先通过从左到右比较输出与原始输出来检查每个输出的正确性。然后我们将检查三个输出是否彼此不同。只有当每个单独的输出都正确且三个输出不同时,答案才算正确。
噪声注入
我们构建了一个数据集80使用 ChatGPT 的常识性问题,提示如下:Ask80常识性问题并回答它们,答案应该是一个单词。为了增加难度并增加问题的噪音,我们在每个单词上附加了一些大写字母以构成一个新单词。为了做到这一点,我们使用给定的词作为前缀,并在字典中用这个前缀定位另一个词,然后使用除前缀之外的其余字符附加到给定的词。每个嘈杂问题的真实答案与原始问题的答案相同。
ASCII 艺术
我们策划了一个数据集50来自 ASCII Art Archive 网站的 ASCII 艺术。每个 ASCII 艺术都被分配了一个基本事实标签。向参与者展示了一幅 ASCII 艺术作品,并要求他们提供相应的标签作为答案。
背诵
我们使用了一组要求用户具有良好记忆力的问题。此类别下有两种类型的问题,包括枚举问题和特定领域的问题。对于枚举,要求用户列出给定类别中的项目。我们手动收集100类别包含超过50在 ChatGPT 的帮助下,人类难以知道的项目或项目。该问题要求用户列出给定类别中的项目,我们计算了响应对基本事实的覆盖率。如果覆盖率超过阈值95%,我们认为答案是由 LLM 生成的。对于特定领域的问题,我们手动收集了一组100人们难以回忆或获取答案的问题,例如“世界上最重的柠檬的重量是多少克?”。尽管这些问题对人类来说可能难以回答,但由于大型语言模型 (LLM) 在包含这些问题的大型语料库上进行了预训练,因此它们相对容易回答。
计算
为了创建计算数据集,我们选择了四位数乘法的问题。具体来说,我们随机抽样100一对四位数,并将它们的乘积计算为基本事实。参与者被要求解决这些乘法问题,如果他们的答案与基本事实之间的绝对差异在范围内,则被认为是正确的10%. 对于人类来说,如果没有笔记或计算器的帮助,很难准确地计算出这些乘法,导致他们经常回答“我不知道”。相比之下,大型语言模型 (LLM) 在预训练期间已经看到许多类似的方程式,并且往往会提供一个通常接近或与基本事实相同的猜测。该测试可以进一步扩展到任何复杂的计算,如除法、指数等。
5.2 主要结果
我们使用各种 OpenAI 模型进行了实验,包括 GPT-3 和 ChatGPT。此外,我们还评估了最近的开源模型,例如 LLaMA 、Alpaca 和 Vicuna 。对于每个模型,我们评估了它在每个提议的问题类别上的表现并记录了它的准确性。此外,我们要求一组人工回答问题并报告他们的准确性(他们需要在 10 秒内回答每个问题)。
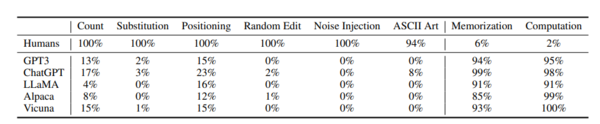
表 2: LLM 和人类在不同FLAIR上的比较。左边部分是对人类来说容易而对LLM来说很难的问题。右边的部分是对人类来说很难而对LLM来说很容易的问题。
结果如表2所示。在左侧部分,我们比较了人类和 LLM 在人类认为容易但 LLM 困难的问题上的表现。结果表明,人类取得了满分(100%) 除了 ASCII Art 之外的所有任务,它们的准确性是94%。另一方面,大多数 LLM 在替换、随机编辑、噪声注入和 ASCII 艺术等任务上有困难,其准确率接近0%。然而,LLM 在计数和定位任务上表现更好,因为与其他任务相比,这些问题的解决方案空间要小得多,使模型更容易猜出正确答案。
在右侧部分,我们比较了人类与 LLM 在人类难以但 LLM 容易的问题上的表现。结果表明,人类在这些问题上表现不佳,因为它们需要良好的记忆或计算能力。相比之下,LLMs 的表现非常出色,一些模型几乎达到了100%准确性。
6 结论
总之,本文提出了一个名为FLAIR的新框架,用于检测在线环境中的对话机器人。所提出的方法针对单个问题场景,该场景可以通过使用对人类容易但对机器人困难的问题来有效地区分人类用户和机器人,反之亦然。我们的实验证明了这种方法的有效性,并展示了不同类型问题的优势。该框架为在线服务提供商提供了一种保护自己免受欺诈活动并确保他们为真实用户服务的新方法。此外,我们在 GitHub 上开源了我们的数据集,欢迎进一步贡献以扩大检测数据集。
