摘要
量子机器学习(QML)展示了它如何保持相对于机器学习方法的某些显著优势。现在表明,混合量子方法有很大的部署和优化空间,并为未来的工业带来希望。作为一个弱点,量子计算没有足够的量子比特来证明其潜力。本课题在改进量子编码方面取得了令人鼓舞的成果,数据预处理是本研究的重点,我们采用LDA和PCA两种降维技术,将它们应用于混合方式的量子支持向量分类器(QSVC)和变分量子分类器(VQC)对糖尿病进行分类。
1.引言
机器学习是解决具有明确结果的问题的最佳方法。图像识别,在缺失数据中找到模式,理解清晰明确的语言,这些都是人工智能可以做到的。它还通常用于发现金融交易中的差异,根据过去数据(如股票市场)的模式进行预测,并确定某人何时发送垃圾邮件并将其标记。
在此前提下,随着量子计算机的进步,一个新的学习和研究领域开始出现,称为量子机器学习(QML)。量子技术的目标是展示其与经典机器学习相比的潜力,但这反过来又显示了量子比特的限制和逻辑门的连续操作等弱点。
虽然一些公司已经在他们的研究和研究项目中探索了量子机器学习的使用,但在其业务运营中广泛使用量子机器学习的公司仍然很少见。 一些提到使用量子机器学习或进行过该领域研究的公司包括:
Google:这家科技公司已经对在路线优化和金融数据分析等任务中使用量子机器学习进行了研究。
IBM:这家科技公司开发了一个名为 IBM Q 的量子机器学习平台,用于研究量子机器学习如何提高图像分类和自然语言处理等任务的性能。
Microsoft:这家科技公司已经研究使用量子机器学习来提高数据中心的能源效率并优化电网中的配电。
D-Wave:这家量子技术公司开发了一个名为 D-Wave Leap 的量子机器学习平台,用于研究量子机器学习如何改善各行业的决策。
在本文中,我们将降维应用于数据集的结构,并展示线性判别分析(LDA)。 与主成分分析(PCA)相比,在监督预处理中显示出显著优势。
我们的目的是比较经典和量子分类方法——量子支持向量分类器(QSVC)和变分量子分类器(VQC)。Qiskit机器学习被用于构建基本的计算构建块,例如量子内核和量子神经网络,我们将其用于糖尿病的分类。
2.数据集
本研究数据选择的目的是对糖尿病患者进行分类。我们使用CSV文件来存储检索到的Kaggle数据集。
表1变量Pima描述
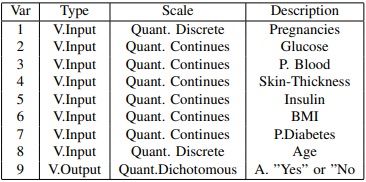
皮马印第安人糖尿病数据库:https://www.kaggle.com/datasets/nancyalaswad90/review
数据集的目的是根据数据集中提供的特定诊断参数来确定患者是否患有糖尿病。从更广泛的数据集中选择这些实例有许多限制。由于选择了一组符合至少 21 岁的皮马妇女描述的患者作为患者,因此实施了一些限制。
3.方法应用
A.降维
降维,也称为主成分分析(PCA),是一种用于降低数据集的维数的数据处理技术。主成分分析是基于寻找一组主成分的思想,这些主成分可以解释数据中的大部分可变性。
目标是将大型数据集(大量特征)转换为包含数据重要信息的紧凑表示(正交投影)。尺寸减小意味着精度的损失,但是PCA使用特征值抑制过程来转换涉及到该过程的协方差矩阵。组件是不同对象的线性组合,用于创建新的未分配对象。第一个元素将包含最多的信息,然后是第二个元素的其余部分,依此类推。 PCA 的几何表示是表示最大变化方向(旋转)的分量。
线性判别分析(LDA)类似于PCA,这些都是线性变换来降低数据集的维数(特征值分离)。PCA使方差最大化,LDA使分类分离轴最大化。LDA将从原始数据的n维空间中创建一个k维子空间,其中 。子空间的计算考虑了标签,以最大限度地实现阶级隔离。
B. 指标
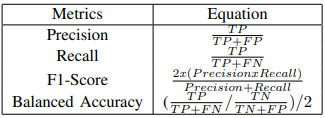
计算各种分类器及其对应表达式的基础知识。FN、TN、FP、TP分别为假阳性、真阴性、假阳性、真阳性。
表2
C.后端
当需要对庞大的数据集进行快速迭代时,很难在后端和量子计算机模拟之间做出选择。 在进入生产或实际生产之前,机器学习模型通常需要进行多次修改和迭代(修复)。 QML 的困难是一样的,但硬件生态系统是不同的。 在真实设备和模拟器(嘈杂和拥挤的量子计算机模拟)上,都可以使用量子算法。
(1)模拟器:在本研究中,只使用了Qiskit Aer模拟器和标准Pennylane量子比特模拟器。
Qiskit Aer是IBM开发的量子机器模拟器,用于模拟经典计算机上量子机器的行为。Qiskit Aer是一个开源工具,可以用来研究和开发量子算法和程序,而不需要访问真正的量子机器。
PennyLane是一个用于量子计算和量子机器学习的开源框架。PennyLane可用于在不同的量子后端上模拟和运行量子算法和程序,包括Qiskit Aer和真实量子机等量子机模拟器。
4.算法
A.机器学习模型
由于监督学习涉及分类困难,我们使用了这一机器学习领域的许多经典方法来比较组合量子经典方法。
(1)Regresion logistica:这种解决二元分类问题的方法是最简单的方法之一。 该模型经过训练以整体学习线性方程的参数:
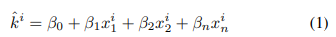
其中 为线性回归系数 , -假阳性,分别为样本特征。由于线性回归无法成功实现分类目标,将回归公式引入logistic函数中,如式(1)所示,以确定概率
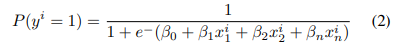
是样本ii 的标签yy 与数字 1 相关联的概率。概率阈值设置为 0.5 以在计算每个样本(搜索模型)的概率后更改二进制输出。 ) 。 如果P(yi=1)<0.5P(y^i=1)<0.5 ,则相应的标签为 0,如果P(yi=1)≥0.51P(y^i=1)\ge0.51 则为标签。 逻辑回归方法需要足够数量的稳定样本才能成功估计参数βn\beta_n 。
(2)分类和回归树:决策树,也称为分类和回归树(CART),是一种二叉图模型,在这种模型中,你对上一个子树所做的选择将决定你对下一个子树所做的决定。树的根作为起点,从这里开始出现两个分支,分为“是”和“否”两类。直到最终的选择被称为叶子,树结构是通过一系列的决策建立起来的。虽然这种方法很简单,但很容易出现过拟合。这些都是强大的算法,可以成功地适应复杂的数据集。学习过程使用熵或基尼准则(公式(2))。
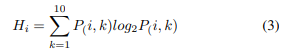
其中ii 是第ii 个节点,P(i,k)P(i,k) 是第kk 个类别的概率。
(3)朴素贝叶斯:朴素贝叶斯算法,有时被称为NB,是贝叶斯定理(等式3)的一个简单版本
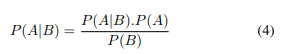
(4)k-Nearest Neighbors:最简单的基于距离的无参数算法称为k-nearest neighbors (kNN)。 假设在n维空间中对应的点就是密度。 使用距离计算(例如欧几里德距离),将对点进行编码和放置。 然后,该算法通过查看最近的 K 个点、对类别进行平均并预测下一个新点的适当类别来确定要应用于新点的类别。
其中A和B是事件,P(A|B)表示当B为真时A发生的概率,P(B|A)表示当A为真时B发生的概率,P(A)和P(B)分别是事件A和事件B的独立概率。概率与分类器DS是条件独立的。他大大简化了数学,使它成为一个容易解决的问题。
B.量子机器学习模型
量子机器学习是机器学习的一个子领域,它使用量子计算机来执行机器学习任务。量子机器学习算法可用于解决使用经典机器学习算法难以或不可能解决的问题。这些问题包括在大型数据集中寻找模式、优化复杂函数以及对数据进行分类。
量子机器学习有几种方法,包括:
量子支持向量机:这是支持向量机的量子版本,是一种线性分类器。
量子主成分分析:这是主成分分析算法的量子版本,用于降低数据的维度。
(1)量子核:量子核是一个函数,用于定义量子机器学习算法中两个量子状态之间的相似性。量子核是经典核函数的推广,常用在核方法中,核方法是一种通过将数据映射到高维特征空间进行操作的机器学习算法。
在量子机器学习中,量子核被用来定义特征空间中两个量子态之间的相似度。这使得量子机器学习算法可以根据量子状态的相似性进行比较和分类。
(2)量子编码:从传统数据到规范表示的过程称为规范编码。 有几种方法可以处理基本数据并提供有用的表示。 在这项研究中,我们分别采用了狡猾的特征图(Qiskit ZZFeatureMap)和角度编码(Pennylane)QSVC 和 VQC。
(3)角度编码:传统的旋转编码信息的过程称为角度编码。传统信息由适当端口上的旋转箭头表示,可以写成如下公式:
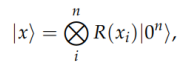
其中R是旋转门,如Rx、Ry和RzR_x、R_y和R_z 。当特征向量xx 的宽度等于量子比特的数量时,就使用角编码。
(4)工作流程:本文介绍了本研究中用于比较所选算法(经典算法和计算算法)的工作流程。对这些数据应用了一系列算法。使用降维技术创建的渲染。该工作流程包括4个步骤:
1.收集数据后进行探索性数据分析。为了为降维方法准备数据,必须对数据进行清洗和规范化,使其具有良好的格式。
2.降维:LDA和PCA用于减少压缩二维函数的数量。 PCA 方法使用两个组件。 在另一个数据集中,使用了 LDA。 所有媒体部分都使用 LDA 组件按比例缩小。
3.量子编码:使用 cuanic 特征图,将传统数据编码为 cuanic 表示。只有计算算法使用此步骤。
4.使用的模型:将所选算法(ML 和 QML)的组合应用于数据编码(量子或经典)并使用相同的指标进行评估(详见表 1)。
5.结果
本节将展示LR、CART、KNN和NB等传统分类模型的分类结果,并与QVC和QSVC等机器学习统计模型用于糖尿病分类的结果进行比较。
表3:将经典模型(LR, KNN, CART, NB)和计算模型(QSVC, VQC)通过PCA降维应用于整个糖尿病数据集。
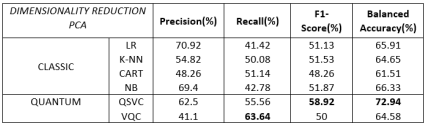
表4:将经典模型(LR, KNN, CART, NB)和计算模型(QSVC, VQC)通过LDA降维应用于整个糖尿病数据集。
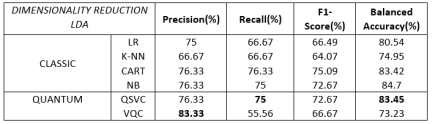
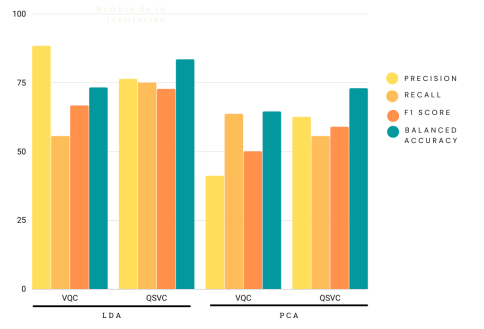
图 1. 使用 PCA 和 LDA 对糖尿病分类的 QSVC 和 VQC 测量进行比较。
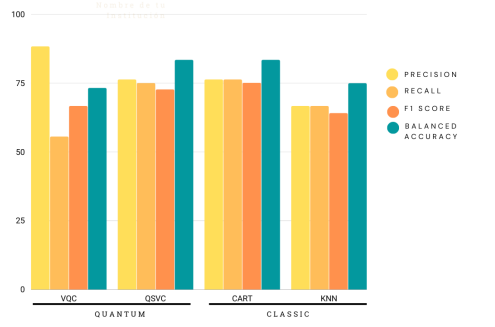
图 2.将 LDA 用于糖尿病分类时 QSVC 和 VQC 的指标与 CART 和 KNN(最好的传统算法)进行了比较。
6.讨论与结论
我们展示了量子计算机如何使用仅通过一部分测量获得的分类结果从经典数据中提取更有用的信息。 用于。竞争优势不一定是通过其超越标准机器学习模型的能力来衡量的,但它可以被认为是信息提取的最佳方法。 量子机器学习的一些潜在好处包括:
更快的速度:由于量子计算机的速度更高,量子机器学习可以比经典机器学习更快地进行计算。例如,一项研究表明,量子机器学习算法可以比经典机器学习算法更快地对数据进行分类。
更高的精度:由于量子计算机的精度更高,量子机器学习可以产生比经典机器学习更准确的结果。例如,一项研究表明,量子机器学习算法可以比经典机器学习算法更准确地对数据进行分类。
更高的学习能力:由于量子计算机具有更高的处理能力和精度,量子机器学习可以比经典机器学习更快、更准确地学习。例如,一项研究表明,量子机器学习算法可以比经典机器学习算法学习得更快、更准确。
处理能力提升:由于量子计算机处理能力的提升,量子机器学习可以同时处理更大的数据量。例如,一项研究表明,量子机器学习算法可以比经典机器学习算法更快地处理大量数据。
对于计算机监督机器学习任务,LDA显示出最有希望的结果。为了了解LDA如何为量子比特编码提供更好的数据表示,本文尚未探索LDA在PCA中的流行情况,但未来将考虑。
LDA和PCA的比较:
方法:LDA专注于最大化不同类别数据之间的分离,而PCA专注于最大化数据的方差。根据一项研究,“LDA是一种监督方法,用于降低数据的维度,同时保持尽可能多的类别信息。另一方面,PCA是一种无监督方法,用于在降低数据维度的同时保持尽可能多的方差”。
成分数:LDA 产生的成分数等于类数减一,而 PCA 产生的成分数等于变量数减一。 根据一项研究,“LDA 总是生成等于类数减一的组件数,而 PCA 生成等于变量数减一的组件数。 因此,LDA更适合分析类数较少的数据,而PCA更适合分析变量较多的数据”。
数据要求:LDA要求数据是正态分布的,并且类具有相等的协方差矩阵,而PCA不具备这些要求。根据一项研究,“LDA要求数据是正态分布的,并且类具有相等的协方差矩阵。另一方面,PCA没有这些要求。因此,LDA比PCA对这些假设的违反更敏感”。
原文链接:https://arxiv.org/pdf/2301.00109.pdf
---煤油灯科技victorlamp.com翻译整理---
