摘要
GPT-3(Generative Pre-trained Transformer 3)是由OpenAI开发的大规模自回归语言模型,在广泛的自然语言处理(NLP)任务上表现出令人印象深刻的小样本性能。因此,一个直观的应用程序是将其用于数据注释。在本文中,我们研究了GPT-3是否可以用作NLP任务的良好数据注释器。数据注释是标记数据的过程,可用于训练机器学习模型,这是NLP系统开发中至关重要的一步,因为它允许模型学习输入数据和期望输出之间的关系。鉴于GPT-3令人印象深刻的语言能力,人们很自然地想知道它是否可以用于为NLP任务有效地注释数据。在本文中,我们通过将GPT-3与传统的数据注释方法进行比较,并分析其在一系列任务中的输出,来评估GPT-3作为数据注释器的性能。通过这一分析,我们的目标是深入了解GPT-3作为NLP中通用数据注释器的潜力。
1.介绍
大型语言模型,如GPT-3,在多个NLP任务中表现出令人印象深刻的性能。然而,在生产环境中直接使用GPT-3进行推理是不实际的,因为它的大小很大,导致推理速度缓慢,并且由于其成本高而在扩展方面存在挑战。此外,这种大型语言模型通常缺乏本地部署的灵活性,因为它们的参数通常不是公开可用的。因此,在生产环境中使用较小的语言模型模型(如BERTBASE )通常更可行。
尽管近年来基于大型语言模型的快速学习吸引了越来越多人的兴趣,但在人工注释数据上训练/微调基本大小或更小的模型仍然是生产实践中最流行的方法。数据注释是对数据进行标记的过程,以帮助机器学习模型更好地理解任何给定任务的目的,识别模式并做出预测。有许多不同的数据注释方法,包括为数据实例分配数值值,将数据分类为预定义的类,提供关于数据的附加上下文或信息等等。注释数据在广泛的下游任务中发挥着关键作用,包括自然语言处理,图像和视频识别和自动驾驶汽车。通过提供高质量的注释数据,研究人员和开发人员可以帮助机器学习模型做出更准确和可靠的预测。
然而,数据注释可能是一项昂贵的工作,特别是对于个人或中小型企业(sme)。数据注释的成本通常包括与标记过程相关的人工成本,以及雇用、培训和管理注释人员所需的时间和资源。此外,支持注释过程所需的注释工具和基础设施可能会产生成本,个人或中小企业用于数据注释的资源/预算可能有限,这可能会使投资于必要的劳动力和技术具有挑战性。
GPT-3是OpenAI开发的一个功能强大的大型语言模型,它的知识可以通过知识蒸馏转移到下游任务。评估结果表明,GPT-3通过对海量语料库的预训练,获得了令人惊讶的广泛领域知识。同时,由于为自动回归生成设计的模型架构和预训练任务,GPT-3能够生成类似人类的文本,并执行广泛的NLP任务,如机器翻译、摘要和问答。因此,我们希望探索使用GPT-3为个人和中小企业普及人工智能(AI)的潜力。GPT-3可能帮助个人或中小企业的一种方式是使他们能够为机器学习模型训练注释数据,而不需要专门的领域知识。这可以使更多的个人或中小企业受益于人工智能的进步。此外,GPT-3可以帮助大大减少数据注释所需的时间和资源,这可以让个人或中小企业更多地关注关键业务问题。通过GPT -3等大型语言模型的开发使人工智能民主化可以为个人或中小企业创造公平的竞争环境,使他们有机会利用人工智能的力量来推动他们的业务发展。
在本论文中,我们进行了大量的实验,以评估3种不同的基于GPT-3的数据注释方法对文本和令牌级NLP任务的性能、时间和成本效益。我们的主要贡献可以总结如下:
- 据我们所知,我们是第一个对利用GPT-3进行数据注释的可行性进行全面分析的机构。
- 我们研究了3种不同的基于GPT-3的数据注释方法,然后对文本和标记级NLP任务进行了广泛的实验,以评估其性能。
- 我们发现,与直接注释未标记的数据相比,基于生成的方法使用GPT-3更具成本效益。
2.相关工作
大型语言模型。大型语言模型(LLMs)近年来在自然语言处理任务方面取得了重大进展。这些模型在大型一般性语料库上进行自我监督训练,并在众多任务中表现出色。LLMs拥有通过少量学习在上下文中学习的能力。它们的能力随着规模的扩大而扩大,最近的研究强调了它们在适当的提示策略下进行更大规模推理的能力。
即时学习。即时学习,也被称为提示,提供了对自然语言处理(NLP)未来可能是什么样子的洞察。通过模仿预训练的过程,提示学习直观地将预训练和模型调优联系起来。在实践中,这种范式已被证明在低数据制度中非常有效。例如,使用适当的模板,零次提示学习甚至可以优于32次微调。快速学习的另一个有前景的特点是它有可能激发大规模的预训练语言模型(PLMs)。当应用于10B模型时,单独优化提示(同时保持模型参数固定)可以产生与全参数微调相当的性能。这些实践研究表明,提示可以更有效地从PLM中提取知识,从而更深入地理解其机制的基本原则。
数据增强。在自然语言处理(NLP)社区中,对使用有限的标记数据进行各种任务的学习进行了大量研究,包括无监督的预训练,多任务学习、半监督学习和少样本学习。解决标记数据需求的一种方法是通过数据增强,这涉及到通过使用基于问题结构先验知识的转换来修改现有数据点来生成新数据。增强数据可以从标记数据中生成,并直接用于监督学习或通过一致性正则化用于对未标记数据的半监督学习。
3.研究方法
我们研究了3种不同的方法来利用GPT-3进行数据注释:
(1)提示引导的未标注数据标注;
(2)提示引导的训练数据生成;
(3)词典辅助训练数据生成。
3.1提示引导的未标记数据标注(PGDA)
第一种方法涉及创建提示引导GPT-3注释未标记的数据。为此,设计了特定于任务的提示,以便从GPT-3中引出一组给定的未标记数据的标签,这些数据集是通过删除现有标签从人工标记的数据集中派生出来的。如果GPT-3对相同的未标记数据产生不同的标签,则通过基于人工标记标准的投票来解决标记过程。然后,得到的GPT -3标记的数据用于训练局部模型,以预测人类标记的测试数据,并评估该模型的性能。为了便于比较,对这种方法的成本进行监控。
3.2提示引导训练数据生成(PGDG)
第二种方法是利用GPT-3为指定的任务自动生成标记数据。该方法包括创建提示,引导GPT-3自行生成标记数据,随后用于训练局部模型,以预测人类标记的测试数据,以评估性能。为了进行公平的比较,还监测了这种方法的费用。
3.3词典辅助训练数据生成(DADG)
第三种方法与第二种方法相似,主要区别在于将维基数据纳入指导GPT-3在相应领域内生成标记数据,然后使用维基数据引导的GPT -3生成的数据来训练局部模型,以预测人类标记的测试数据,以评估性能。与前面的方法一样,也监测这种方法的成本,以便进行公平的比较。
4.实验
4.1实验设置
在这项研究中,我们对两个关键任务进行了深入的实验:文本分类(句子级任务)和命名实体识别(标记级任务)。对于文本分类任务,我们选择了SST2数据集,这是一个由电影评论组成的著名数据集。对于命名实体识别,我们选择了从CrossNER数据集中分割的AI域,这是数据集中最困难的域,它的14种实体类型更接近于反映现实场景。为了模拟在生产环境中使用GPT-3注释训练数据的真实场景,我们假设用户可以访问现成的GPT-3 API。在我们所有的实验中,我们都使用了最新的GPT-3模型:text-davinci-003。此外,我们假设用户使用BERTBASE进行生产,并且可以访问每个任务的一些数据点和维基数据。在评估不同方法的性能时,我们分别对SST2任务和CrossNER任务进行了BERTBASE的微调,分别对SST2任务和CrossNER任务进行了BERTBASE的微调,分别对SST2任务和CrossNER任务进行了BERTBASE的微调。在对模型进行微调后,我们在每个任务的人工标记黄金测试数据上评估模型,以评估不同方法产生的注释数据的质量。
4.2句子级任务
本文利用SST2数据集进行句子级文本分类实验,未来的研究将扩展到更多的句子级任务。
PGDA 从SST2数据集的训练集中随机选择10个金数据点的子集来构建提示模板,如图2所示。然后利用提示来指导GPT-3模型为未标记的数据生成情感标签,这些情感标签被附加到提示的底部,随后进行后处理,重新格式化GPT-3生成的标记数据,转换为SST2格式,然后使用结果数据对BERTBASE模型进行微调。
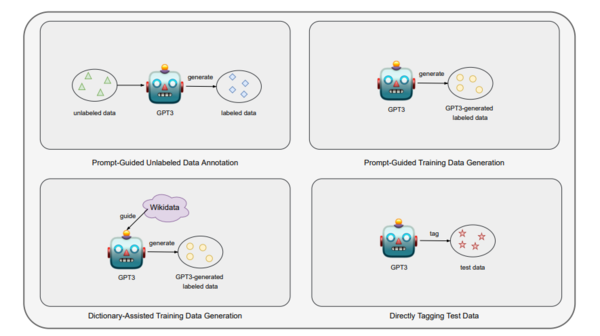
图1:提示的不同方法的说明
从正面和负面中选择给定文本的情绪
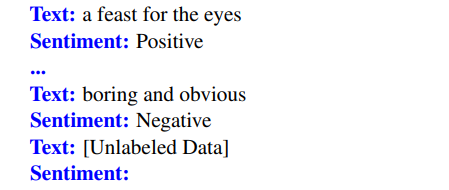
图2:SST2的提示引导的无标记数据注释示例
PGDG 在本研究中,探索了利用PGDG对SST2数据集进行处理。GPT-3执行零提示生成的能力是通过为模型提供一个简单的提示来生成具有特定情感的句子来测试的,如图3所示。与PGDA一样,在用于优化BERTBASE模型之前,对结果数据进行后处理并将其重新格式化为SST2格式。
用不超过20个字的篇幅写10篇不同的正面影评
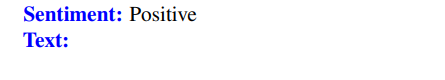
图3:SST2的提示引导数据生成示例
DADG 在本研究中,将探讨如何利用DADG对SST2数据集进行处理。GPT-3执行Wikidata引导的零提示生成的能力是通过在Wikidata中提供来自电影领域的几个实体和一个简单的提示来让模型生成带有特定情感的句子来测试的,如图2所示。与PGDA一样,结果数据在用于优化BERTBASE模型之前经过后处理并重新格式化为SST2格式。
4.3词条级任务
在本文中,利用CrossNER数据集中的AI域分割进行标记级任务实验,未来的研究将扩展到更多的词条级任务。人工智能领域划分有14种实体类型,即产品、领域、任务、研究人员、大学、编程语言、算法、杂项、指标、组织、会议、国家、位置、人员。
PGDA 为了设计每种实体类型的提示,我们使用了图5中描述的方法。对于每个实体类型,我们启动GPT-3来生成它的定义,并在提示符中提供一个数据选择(不超过10个),其中的实体属于指定的实体类型,以帮助GPT-3识别未标记数据中属于同一类的实体。为了获得未标记的数据,我们从CrossNER数据集中AI域分割的gold train数据中去除所有标签。可以观察到,同一实体可以用不同的提示符标记为不同的实体类型。因此,我们还包括了一个额外的提示符,如图6所示,以确定每个标识的实体的最终实体类型。结果数据经过后期处理并重新格式化为CrossNER格式,然后再用于优化BERTBASE模型。
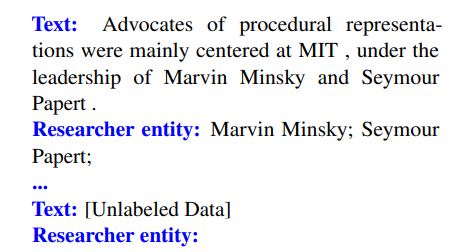
图5:CrossNER的提示引导的未标记数据注释示例
从文本上下文中给定实体的候选列表中选择正确的实体类型
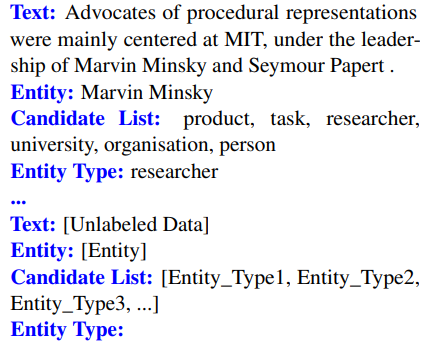
图6:确定实体的实体类型的提示示例
PGDG 使用PGDG生成CrossNER训练数据的过程包括两个步骤:第一步包括提示GPT-3为每个实体类型生成实体,如图7所示。请注意,在我们的实验中,每种实体类型使用的实体不超过200个。第二步涉及使用GPT-3在特定领域内使用这些生成的实体生成句子,如图8所示。在生成句子的过程中,我们为每个句子从生成的实体中随机选择几个实体。在此过程之后,对结果数据进行后处理并格式化为CrossNER格式,然后使用该格式对BERTBASE模型进行微调。
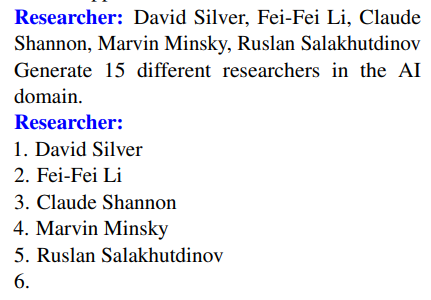
图7:提示GPT-3为“研究员”类型生成实体的示例
DADG 与PGDG类似,使用DADG为CrossNER生成训练数据的过程包括两个步骤:第一步涉及查询Wikidata以获得每种实体类型的实体。与PGDG类似,我们在实验中为每种实体类型使用不超过200个实体。第二步涉及使用GPT-3在特定领域内使用这些生成的实体生成句子,如图8所示。在生成句子的过程中,我们从每个句子的所有实体中随机选择几个实体。在此过程之后,对结果数据进行后处理并格式化为CrossNER格式,然后使用该格式对BERTBASE模型进行微调。
在AI域中生成所有给定实体的文本
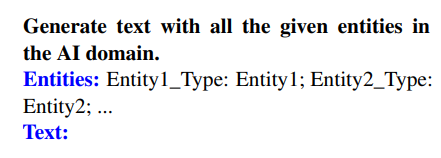
图8:SST2的提示引导数据生成示例
5.结果与讨论
5.1句子级别任务
表1给出了三种不同方法的结果。总体而言,PGDA标记方法在三种选择中表现出最高水平的性能,通过标记相同的3000个数据点,PGDA获得了87.75分,仅比人工标记数据的得分低0.72分。然而,PGDA所需的成本和时间明显低于人工标记。使用PGDA方法注释6,000个数据点比人工标记3,000个数据点的性能更好,而成本大约是人工标记成本的5%。另一方面,由于缺乏上下文内学习,零提示PGDG方法的表现不如PGDA或人类标记的数据。此外,涉及使用域内实体生成数据的DADG方法并没有带来更好的性能,这是因为实体在情感分类任务中通常不是关键因素,因为大多数实体是中性的,不提供与情感相关的额外信息。此外,由于SST2中的大部分数据不包含任何实体,使用DADG生成的句子与SST2中的测试数据不符合相同的分布,导致性能较差。为了便于比较,文中还介绍了用GPT-3直接标记试验数据的结果。建议,对于小规模应用,使用GPT-3直接标记未标记的数据是可行的。
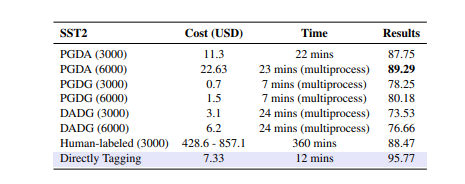
表1:SST2的成本、时间花费和结果,' multiprocess '意味着多线程
5.2 词条级别任务
表2给出了三种不同方法的结果。结果发现,使用PGDA的训练数据标注方法是三种方法中性能最低的,也是该任务中成本最高的选项。值得注意的是,在CrossNER数据集中的AI域分割中只有100个黄金训练数据点,而这100个数据点是使用PGDA标记的。然而,标记这100个数据点的成本高于使用生成方法生成3000个数据点的成本。据观察,GPT-3在识别文本中的实体方面是有效的,但它也可能识别不属于指定实体类型的实体,从而导致不正确的标记。此外,GPT-3可能无法准确识别实体的边界。这两个缺点使得在生产环境中使用PGDA为命名实体识别(NER)标记数据变得不切实际,特别是在存在多种实体类型的情况下。
PGDG方法能够以较低的成本获得与100个人类标记的黄金训练数据相当的结果。在使用Wikidata时,DADG方法能够获得比PGDG更高的结果,这可能是因为它能够利用从Wikidata中提取的更多唯一实体和域内实体。这表明访问域内实体的能力对于为NER创建高质量的训练数据至关重要。
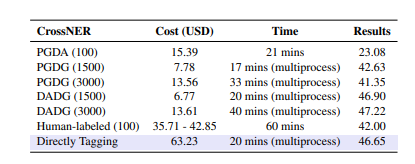
表2:CrossNER的成本、时间花费和结果,' multiprocess '意味着多线程。
6.结论
在这项研究中,我们使用三种主要方法评估了GPT-3作为文本分类和命名实体识别任务的数据注释器的有效性。我们的研究结果表明,由于GPT-3进行了大规模的预训练,因此在直接标记测试数据时,它在文本分类任务上表现最好,但在更复杂的任务(如NER)上可能表现不佳。对于这些任务,提示引导或词典辅助的训练数据生成可能更有效且成本更低。
在未来的研究中,我们计划分析影响GPT-3数据标注质量的因素,并探索是否有更多通用的方法可以应用。我们还打算扩大我们的研究范围,包括更有挑战性的任务,如关系提取、自然语言推理和问题回答,并可能研究在自然语言生成任务和低资源语言中使用GPT-3进行数据注释。另一个潜在的方向是比较ChatGPT和GPT-3之间的注释能力。我们的总体目标是更好地理解使用LLM(如GPT-3)进行数据注释的能力和局限性,并确定该领域中需要改进的潜在领域。
论文链接:https://arxiv-export1.library.cornell.edu/abs/2212.10450
