随着深度学习的快速发展和机器学习跨应用领域的指数级增长,人工智能(AI)加速变得至关重要。IBM Research一直在构建一个AI硬件加速器管道,来满足这一需求。在2018年超大规模集成电路研讨会上,我们就展示了一款多万亿次加速器核心构建模块,可以跨广泛的AI硬件系统进行扩展。这种数字AI核心采用并行架构,可确保非常高的利用率和高效计算引擎,而这些引擎能谨慎地利用降低的精度。
近似计算(Approximate computing)是我们“AI物理学”方法的核心原则,通过专门构建的架构实现了高能效的计算增益。其中,最初使用的是数字计算,后来还包括了模拟和内存计算。
历史上,计算依赖于高精度64位和32位浮点运算。这种方法提供精确到小数点后第n位的计算,这种精确度对于模拟人类心脏或计算航天飞机轨迹等科学计算任务至关重要。但是对于常见的深度学习任务,我们需要这种程度的准确性吗?我们的大脑需要高分辨率的图像来识别一个家庭成员,或者一只猫吗?当我们输入一个文本线索进行搜索时,我们是否需要第50,002个最有用回复与第50,003个最有用回复的相对排名的精确性?答案是,包括这些例子在内的许多任务都可以通过近似计算来完成。
由于常见的深度学习工作负载很少需要全精度,因此降低精度是一个自然的方向。具有16位精度引擎的计算构建块比具有32位精度的可比块小4倍;这种面积效率的提高对于AI训练和推理的工作负载来说,都是性能和能效的提升。简而言之,在近似计算中,我们可以用数值精度来换取计算效率,前提是我们还要改进算法以保持模型的准确性。这种方法还补充了其他近似计算技术,包括最近描述了新的训练压缩方法以减少通信开销的工作,导致比现有方法快40-200倍。
我们在2018年VLSI电路研讨会上展示了我们的数字AI核心的实验结果。我们新内核的设计遵循四个目标:
(1)端到端性能:并行计算、高利用率、高数据带宽.
(2)深度学习模型准确性:与高精度实现一样准确。
(3)电源效率:应用电源应该由计算元素控制。
(4)灵活性和可编程性:允许调整当前的算法,以及未来深度学习算法和模型的开发。
我们的新架构不仅针对往往主导深度学习计算的矩阵乘法和卷积核(convolutional kernel)进行了优化,还针对作为深度学习计算工作负载一部分的一系列激活函数进行了优化。此外,我们的架构支持原生卷积运算,允许在内核上以极高的效率运行对图像和语音数据的深度学习训练和推理任务。
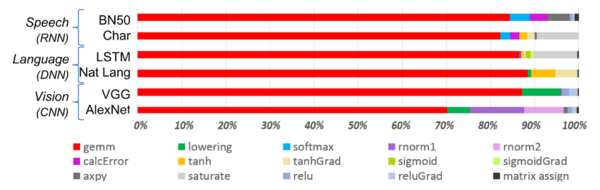
图1. 深度学习算法由一系列运算组成。虽然矩阵乘法占主导地位,但在保持精度的同时优化性能效率需要核心架构有效支持所有辅助功能。
为了说明核心架构如何针对各种深度学习功能进行优化,图1显示了深度学习算法中跨一系列应用领域的细分操作类型。通过使用图2和图3中所示的处理元件的定制数据流组织,在核心架构中计算主导矩阵乘法分量,其中可以有效地利用降低精度的计算,而剩余的向量函数(图1中的所有非红色条)在图3或图4中所示的处理元件或特殊功能单元中执行,这取决于特定功能的精度需求。
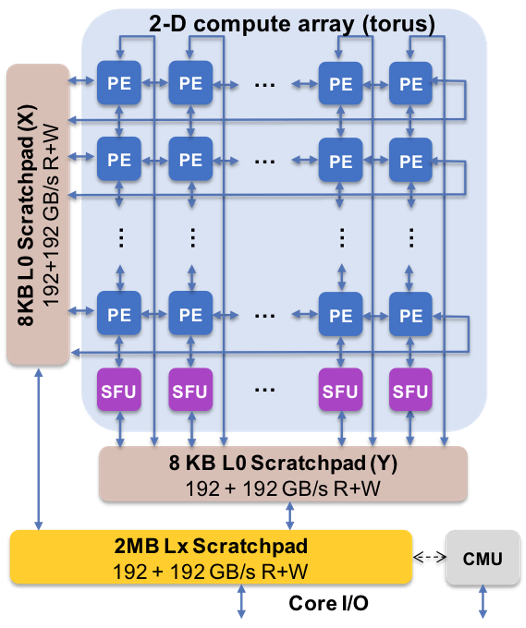
图2. 核心架构通过便笺式分层结构捕获定制的数据流。处理单元(PE)对矩阵乘法运算和一些激活函数采用降低的精度,而特殊功能单元(SFU)对剩余的向量运算保持32位浮点精度。
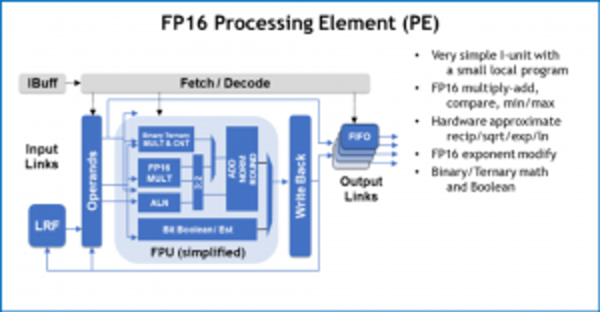
图3. 具有16位浮点(FP16)功能的处理元件(PE),用于矩阵乘法运算、二进制和三进制数学、激活函数和布尔运算。
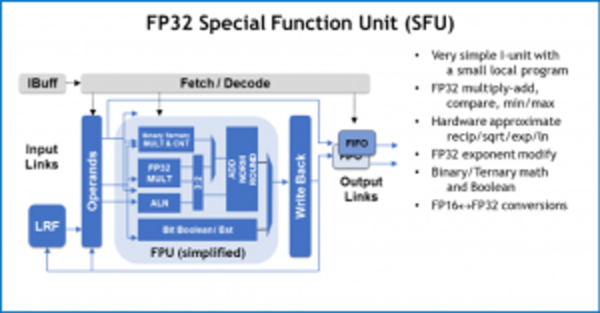
图4. 具有32位浮点(FP32)的特殊功能单元(SFU),用于某些向量计算。
在研讨会上,我们展示了硬件结果,证实了这种单一架构方法能够进行训练和推理,并支持多个领域的模型(例如,语音、视觉、自然语言处理)。虽然其他团队指出他们的专业AI芯片具有“峰值性能”,但性能水平只保持在峰值的一小部分,但我们一直专注于最大限度地提高持续性能和利用率,因为持续性能直接转化为用户体验和响应时间。
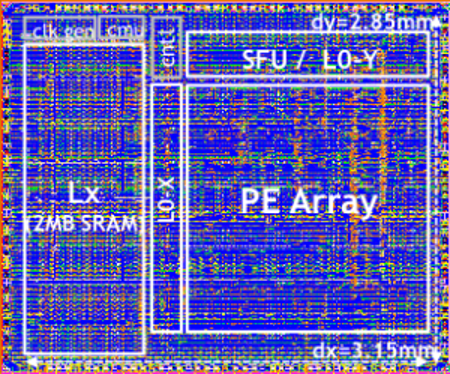
图5. 基于14LPP技术的数字AI核心测试芯片,包括5.75M门、1.00个触发器、16KB L0和16KB PE本地寄存器。该芯片用于演示广泛AI工作负载的训练和推理。
我们的测试芯片如图5所示。使用这个内置于14LPP技术的测试芯片,我们已经成功地在一个广泛的深度学习库中演示了训练和推理,练习了深度学习任务中常用的所有操作,包括矩阵乘法、卷积和各种非线性激活函数。
我们在VLSI论文中强调了数字AI内核的灵活性和多用途能力以及对多数据流的本机支持,但这种方法是完全模块化的。这个AI核心可以集成到SOC、CPU或MCU中,用于训练、推理或两者兼而有之。使用该内核的芯片可以部署在数据中心或边缘。
在IBM Research对深度学习算法的基本理解的推动下,我们预计训练和推理的精度要求将继续扩大——这将推动AI所需的硬件架构的量子效率提高。
原文链接:https://www.ibm.com/blogs/research/2018/06/approximate-computing-ai-acceleration/
