摘要
晶圆级处理器(Waferscale processor)系统可以提供当今高度并行工作负载所需的大量内核和内存带宽。构建晶片级系统的一种方法是使用基于小芯片的架构,其中预先测试的小芯片集成在无源硅互连晶片上。这项技术允许异构集成,并且可以提供显著的性能和成本优势。然而,设计这样一个系统有几个挑战,如电力供应、时钟分配、晶圆级网络设计、可测性设计和容错。本文将讨论这些挑战以及一个包含2048个芯片、14,336个内核的处理器系统的完整设计解决方案。
I. 介绍
图形处理、数据分析和机器学习等高度并行工作负载的激增推动了对具有大量处理内核、大容量内存和高内存带宽的大规模并行高性能系统的需求。这些工作负载通常运行于由许多分立封装的处理器组成的系统上,这些处理器使用传统的封装外(off-package)通信链路连接。与片上链路相比,这些封装外链路的带宽和能效较低,并且与硅芯片相比,其可扩展性较差。结果是,包间通信(inter-package)的开销以惊人的速度增长。
晶圆级集成可以通过在一个大晶圆上紧密互连大量处理器内核来缓解这种通信瓶颈。最近的多项工作表明,与传统系统相比,晶圆级处理可以提供非常大的性能和能效优势。最近,Cerebras已经成功地将晶圆级计算引擎商业化。类似地,BrainScaleS/FACETS项目建造了一个晶圆级大脑仿真引擎。这些方法依赖于构建一个具有定制光罩(cross-reticle)互连的大型单片晶圆级芯片。
然而,单片晶圆级芯片是同质的,无法集成来自不同技术(如DRAM或其他高密度存储技术)的组件。而且,为了获得良好的良率,需要在晶圆级芯片上预留冗余核心和网络链路。
构建晶圆级系统的另一种方法是在晶圆级互连基板上集成预先测试过的已知良好的小芯片(在本文中,我们称未封装裸片/裸片为小芯片)。硅互连结构(Si-IF)是一种候选技术,它允许我们在高密度互连晶片上紧密集成许多小芯片。Si-IF技术提供基于细间距铜柱(10μm间距)的I/O,其密度至少是基于内插器的系统中使用的传统μ级凸点(μ-bump)的16倍。
因此,它为小芯片间互连提供了全局性的片上布线特性。此外,在基于小芯片的晶圆级系统中,小芯片可以以异构技术制造,并可能提供更好的性价比权衡。例如,可以获得每100秒数TB级内存容量以及PFLOPs计算吞吐量,适用于HPC和ML/AI应用中的大数据工作负载。
然而,基于大规模小芯片组件的系统设计有其独特的挑战,包括从底层集成技术到电路设计和硬件架构等问题,以及它们对软件的影响。这项工作首次尝试构建基于细粒度小芯片的晶圆级处理器原型。该系统包括一个由1024个瓦片组成的阵列,其中每个瓦片由两个小芯片组成,总共有2048个小芯片和大约15,000mm2的总面积。
这个原型系统的规模迫使我们重新思考设计流程的几个方面。因为这是第一次尝试建造这样的系统,所以在制造和组装过程中有一些未知因素。因此,容错和弹性是我们设计决策的主要驱动因素之一。我们还要确保设计决策不会太复杂,以便由3-4名研究生组成的小团队可以在合理的时间内可靠地完成。我们在构建和设计该系统时面临的几个挑战如下:
(1)如何向晶圆上所有以倒装芯片方式键合的小芯片供电?
(2)如何在如此大的区域内可靠地分配时钟?
(3)当每个小芯片需要支持大量基于细间距铜柱I/O时,我们如何设计面积高效的I/O?如何实现非常高的整体小芯片组装和键合良率?
(4)什么是芯片间网络架构,如果一些小芯片出现故障,我们如何实现弹出?
(5)当I/O焊盘尺寸较小时,测试策略是什么?我们如何确保测试方案的可扩展性?
(6)在制造工艺的不确定性和约束条件下,我们如何设计小芯片和基板?
本文中,我们解释了构建基于外延小芯片组装系统所面临的挑战和可能解决方案(包括我们原型系统的设计决策)。据我们所知,这是有史以来最大的基于小芯片组件的系统。就有效面积而言,我们的原型系统比NVIDIA/AMD等基于单个小芯片的系统大10倍左右,比NVIDIA的64芯片Simba(研究)系统大100倍左右。
II. 晶圆级处理器系统概述
为了了解使用基于小芯片的晶圆级处理器系统的设计和实施挑战以及机遇,我们构建并设计了一个基于2048个小芯片的14,336核处理器系统。这里,我们首先简要概述整个系统的架构、小芯片以及小芯片内和小芯片间网络。
(1)系统架构:
采用基于瓦片的扩展架构,可以扩展到32×32瓦片阵列(见图1),总共1024个瓦片。每个瓦片由两个小芯片组成,一个计算小芯片和一个存储小芯片。系统总共包含14个独立可编程处理器内核和512KB全局共享内存。我们将该系统设计为一个统一的内存系统,其中任何瓦片上的任何内核都可以使用晶圆级互连网络,直接访问整个晶圆级系统的全局共享内存。
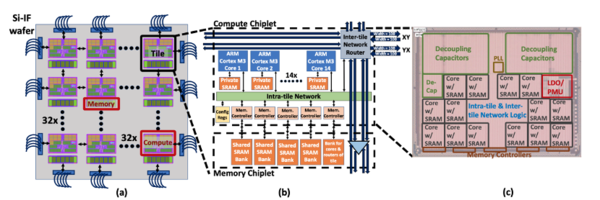
图1:(a)示出32×32瓦片阵列的晶圆级处理器系统概况,其中每个瓦片包括计算小芯片和存储小芯片。(b)计算和存储小芯片的具体情况。(c)计算小芯片的显微照片。
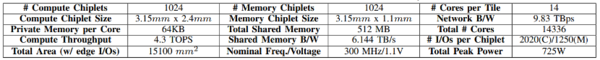
表1:晶圆级处理器系统的显著特征
让包含14,336个内核的网络具有扩展性极具挑战。因此,我们设计了一个分层网络方案,包括片内交叉网络和片间网状网络。表1列出了该系统的显著特点。
小芯片采用TSMC 40nm-LP工艺设计和制造,终止于顶部铜金属层,在此处构建了细间距I/O焊盘。晶圆级基板采用无源基板,含有小芯片和铜柱之间的互连布线,以连接到小芯片I/O。如图2所示,小芯片通过倒装芯片工艺键合到晶圆级基板上,并使用边缘连接器将整个晶圆级系统连接到电源和外部控制器。
(2)计算小芯片:
如图1所示,计算小芯片包含14个ARM CORTEX-M3内核及其专用SRAMs(每个64KB)、存储器控制器(用于访问存储器小芯片中的存储体)、用于片间网络的网络路由基础设施,以及连接所有这些组件的小芯片级片内交叉互连(使用ARM BusMatrix IP实现)。电力输送相关组件也包含在计算小芯片内。网络路由基础设施是围绕开源BSG IPs构建的,但包括支持两个独立网络所需的其他定制单元,用于瓦片内网络通信以及支持各种内存映射功能的适配器。
(3)存储器小芯片:
存储器小芯片包括5个128KB SRAM存储体。这些存储体中的4个可使用全局共享存储器地址空间寻址,而一个存储体只能由同一瓦片上的核心和网络路由器访问。所有这些内存条通过计算小芯片上的存储器控制器连接到片内网络。存储器小芯片还为南北互连链路和两组去耦电容器提供缓冲馈通。注意,尽管瓦片中的两个小芯片在架构上是异构的,但为了设计方便,我们把它们以同一技术节点来实施。
然而,该小芯片可以容易地在更新或更密集的存储技术中实现,以获得更高的存储容量和/或面积节省。
(4)晶圆级基底的特征:
晶圆级基底采用Si-IF技术制造。我们在原型中使用的I/O(即铜柱)间距为10μm(该技术提供的最小值)。互连布线间距为5μm(目前提供的最小间距为4μm)。使用两层信号,我们实现的边缘互连密度为400线/毫米。
我们通过在FPGA平台上仿真一个缩小尺寸的多瓦片系统,验证了本文讨论的系统设计和架构(由于规模原因,无法进行完整的晶圆级系统仿真)。我们成功地在这个系统上运行了各种包括图形应用在内的工作负载,如广度优先搜索(BFS)、单源最短路径(SSSP)等。
III. 晶圆级电力输送和调节
如何可靠地向倒装键合到15000mm2晶圆级互连基板上的所有小芯片供电?与单片晶圆级系统不同,在单片晶圆级系统中,电源可以直接提供给最顶层的金属层(正面),小芯片是倒装键合到厚晶片级基板上。因此,可以使用晶圆通孔(twv)技术从晶片背面输送功率,这是一个全厚度晶圆片上深度为的700μm通孔,也可以在晶片边缘输送功率。由于TWV技术在Si-IF晶片中的集成仍在开发中,尚未准备好投入使用,我们选择在原型系统中使用边缘供电。
在1.21V(fast-fast corner)电压工作时,每个瓦片的峰值功率约为350mW。因此,大约290A的电流需要通过晶片传递给小芯片。为了最大化产量,衬底中金属层的数量被限制为4层。由于两个金属层专用于芯片间信号传输,两层可用于配电。Si-IF技术中金属层的最大厚度为2μm,如果需要输送的电流非常大,配电网络的电阻将导致大的电压下降。因此,我们考虑了两种不同的供电策略:
(1)在边缘提供高电压(比如12V)供电,并在小芯片附近使用下变频(基于降压或开关电容的转换器),这将使通过电源层提供的电流降低12倍。
(2)在边缘提供高电压供电(比如2.5V),并在小芯片中使用基于低压差(LDO)的调节,这意味着需要通过PDN层的电流量更大,因此电源层中的损耗也更大。
在小芯片附近使用下变频的第一种选择具有很高的面积开销,因为诸如电感器和电容器之类的大体积片外组件需要放置在晶片上。我们估计这些组件将占据大约25-30%的面积。此外,在晶片上集成这些组件将导致小芯片阵列的规则结构被破坏,并增加小芯片间的距离,这将减少细间距互连的好处。这种方案会导致设计复杂性的增加。
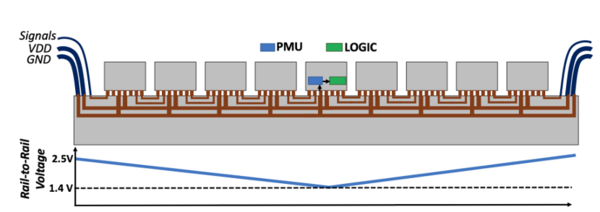
图2:电力从边缘输送。晶片边缘的小芯片接收2.5V的功率。随着我们向晶片中心移动,电压下降,而中心的小芯片接收1.4V的功率
由于该原型是一个亚千瓦系统,我们选择避免这种复杂性。在我们的方案中,靠近边缘的小芯片将在高得多的电压(2.5V)下接收功率,而远离边缘的小芯片将在较低的电压下接收功率,这是由于与电阻功率损耗相关的电压下降。我们的估计显示,在峰值功率汲取期间,位于中心的小芯片将从所有小芯片接收大约1.4V的功率。然而,这使得LDO设计具有挑战性,因为它必须为逻辑器件产生1.1V(标称)的稳定电压,而DC电源电压可以根据小芯片在晶片上的放置位置在1.4V和2.5V之间变化。我们构建了一个定制LDO,可跟踪这个宽的输入电压范围。
另一个挑战是,LDO调节器必须支持高达350mW的峰值功率,同时在几个周期内维持高达200mA的电流需求波动(最坏情况)。为了在这些工作条件下实现良好的调节,LDO调节器的输出端需要足够的去耦电容。这种大电容需求通常使用片外分立去耦电容来满足。然而,在我们的晶圆级系统中,片外电容只能放置在阵列边缘。
因此,阵列中心的小芯片距离最近的电容器最远可达70毫米。我们设计了一个定制的片内去耦电容,并将瓦片总面积的35%专用于去耦电容,每个瓦片约20nF。最终的设计可确保整个工艺/电压/温度范围内的调节电压始终在1.0V至1.2V之间。为了简洁起见,我们省略了电路级细节。
IV. 晶圆级时钟产生和分配
接下来,我们如何为超过15,000mm2晶圆级基板上的所有小芯片提供时钟?
我们在计算小芯片中包括一个锁相环(PLL),它可以接收频率在10到133MHz之间的输入时钟,并产生频率高达400MHz的输出时钟。因此,一种选择是使用构建在Si-IF上的无源时钟分配网络(clock distribution networ,CDN)向整个晶圆上分配慢速时钟。然而,在该方案中有两个挑战。
首先,面积约为15,100mm2、具有1024个汇点的无源CDN的寄生效应非常大(>450pF和>120nH)。因此,时钟分配只能在亚MHz频率下进行。此外,要获得一款能够驱动大容性负载、同时确保绝对抖动性能低于100皮秒的良好晶体振荡器也很难。
其次,我们使用的PLL IP需要稳定的基准电压才能可靠工作。
然而,远离小芯片边缘的电压调节并不完美,并且调节后的电压可能在1.0V和2V之间波动。结果,只能在晶片边缘附近产生稳定的时钟,在该处小芯片可以访问附近的片外去耦电容器。因此,系统在一个边缘瓦片中生成快速时钟(高达350MHz),然后通过每个瓦片中内置的转发电路将其转发到整个瓦片阵列。
(1)时钟选择和转发
时钟选择和转发电路是计算小芯片的一部分。如图3所示,计算小芯片具有多个时钟输入:主(慢)时钟、软件控制的测试/JTAG时钟和4个转发时钟(每侧一个来自相邻的小芯片);和4个输出,以将时钟转发到所有边上的相邻小芯片。在测试和程序/数据加载阶段,选择JTAG时钟作为瓦片的功能时钟。然而,在程序执行阶段,可以选择4个转发的输入时钟之一或主时钟作为瓦片逻辑的功能时钟。如果所选瓦片时钟的频率需要倍频,可以选择将其传递给PLL。此外,这5个时钟中的一个被选择转发给所有相邻的瓦片。
启动期间,时钟选择器电路默认采用软件控制的JTAG时钟。然后,我们使用JTAG进行时钟设置初始化。在此阶段,我们首先选择一个或多个边缘瓦片,并将其配置为从较慢的系统时钟生成较快的时钟,该系统时钟由晶圆外部的晶体振荡器源提供。从边缘小芯片产生的更快时钟被转发到它们的相邻小芯片。然后,非边缘小芯片被配置用于自动时钟选择阶段。在这一阶段,时钟选择电路选择转发的时钟,该时钟开始切换,并首先达到预定义的切换计数(默认为16)。一旦选择了转发的时钟,该瓦片的时钟设置阶段终止,并且所选择的时钟被转发到其相邻瓦片。这确保在时钟转发过程中不会出现活锁情况(live-lock scenario)。
然而,这种时钟转发方案存在一个问题,由于缓冲器、反相器、转发单元组件和小芯片间I/O驱动器中的上拉/下拉不平衡,快速时钟会产生占空比失真。当时钟穿过阵列中的多个瓦片时,这种占空比失真可能会杀死时钟,例如,每个瓦片5%的失真可能会杀死仅10个瓦片中的时钟。为了避免这个问题,我们提出了一个反相版本的时钟。这确保了失真在半个时钟周期之间交替。此外,我们还实现了一个占空比失真校正(duty cycle distortion correction,DCC)单元,可以校正任何残余失真。
(2)时钟转发网络中的弹性
有缺陷的小芯片可能会破坏时钟转发机制。然而,我们的时钟生成和转发方案具有内置的弹性。因为边缘的任何小芯片都可以生成更快的时钟,时钟生成中不存在单点故障。此外,因为每个非边缘瓦片从所有四个方向接收切换时钟,这确保了如果4个小芯片中的至少一个相邻小芯片没有故障,则时钟可以到达该小芯片并被进一步转发。通过归纳,可以证明所产生的快速时钟可以到达晶片上所有没有故障的瓦片,除非特定瓦片的所有相邻瓦片都有故障。
图4示出了一个具有故障瓦片的8×8瓦片阵列的一种可能时钟转发配置。边缘瓦片1产生更快的时钟,该时钟在整个晶片上前进。即使在64个瓦片网格中出现6个有故障的瓦片,除了瓦片2之外的所有瓦片都接收转发的时钟。瓦片2在所有四个面上都有故障瓦片,因此不能接收所生成的时钟。即便如此,该瓦片也会变得不可用,因为其他瓦片没有可用路径来使用晶圆级瓦片间网络与该瓦片进行通信。由于我们的小芯片间通信使用异步FIFO,半周期相位延迟和任何抖动都不是问题。
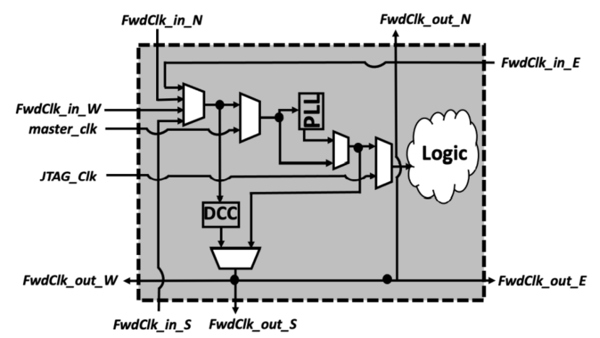
图3:时钟选择和转发电路示意图。
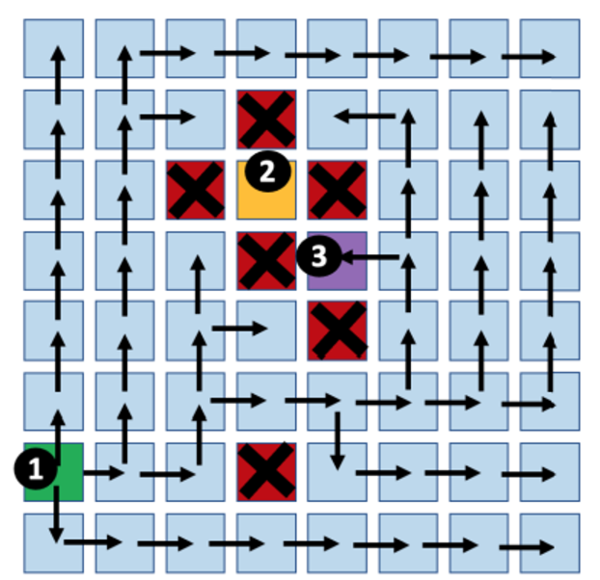
图4:具有故障瓦片的系统的时钟转发配置示意图。除了黄色的,其余所有瓦片都可以接收转发的时钟。
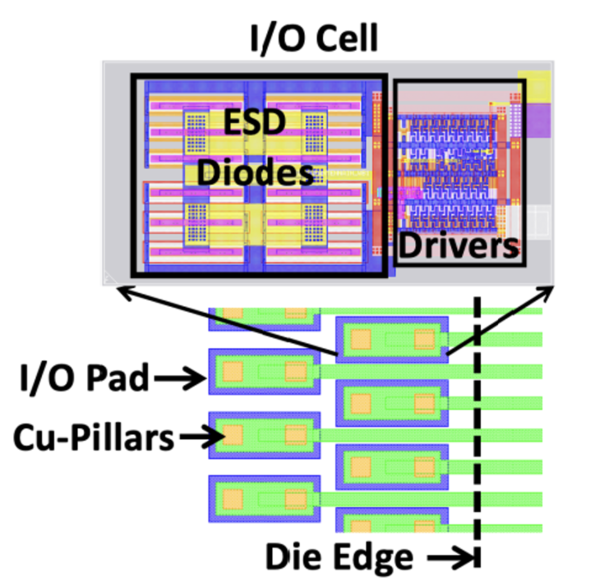
图5:具有ESD保护电路和I/O焊盘铜柱的细间距I/O布局。
另一方面,即使被三个有故障的瓦片包围,瓦片3仍然可以接收转发的时钟。这是因为它有一个从其接收生成时钟的非故障邻居。
V. I/O架构
由于每个小芯片都需要支持大量I/O(收发器电路和Cu焊盘)用于细间距铜柱互连,我们如何设计面积高效的I/O并实现高键合成品率?
Si-IF技术允许小芯片间的链路短至200-300μm。因此,这些链路可以由工作频率为1GHz的小型节能I/O电路轻松驱动。此外,Si-IF技术还提供细间距铜柱(10μm间距)用于将小芯片结合到基板上,以及细间距互连布线(4微米间距)用于小芯片间通信。为了在没有大面积开销的情况下支持大量I/O,I/O单元的尺寸要很小。此外,如果I/O单元很大,则它们必须放置在离I/O焊盘一定距离的地方,从而显著降低了短的小芯片间Si-IF链路的容量优势。
如果I/O电路可以完全包含在焊盘之下,我们就可以获得最佳的I/O收发器能效。发射器采用简单、尺寸合适的级联反相器设计,可驱动1GHz信号,链路长度最长可达500μm。接收器采用两个最小尺寸的反相器设计。在小I/O单元面积中管理静电放电(ESD)是一项挑战,但幸运的是,与通常必须处理与2kV人体模型相对应的大ESD事件的封装器件不同,裸片小芯片到晶圆的键合只需满足不太严格的100V人体模型(HBM)或机器模型(MM)规格(类似于硅内插器)。
I/O单元以及剥离的ESD电路的最终面积约为150μm2。这比一根铜柱所能容纳的面积还要大。因此,设计I/O时,每个焊盘上可以有两个铜柱。这也提高了键合相关的良率。对于单个支柱,预期键合良率> 99.99%。由于每个焊盘有两个支柱,每个I/O的焊接良率可以显著提高。由于每个小芯片超过2000个I/O,因此小芯片的键合良率将从81.46%提高到99.998%。这对于系统良率至关重要,因为我们的晶圆级系统由2048个小芯片组成(即在晶圆级,这将把有缺陷的小芯片的预期数量从380个减少到1个)。
如图5所示,为了实现每毫米小芯片边缘的最大I/O密度,I/O焊盘放置的位置,位于其对应的两个支柱与小芯片边缘的正交点上。总的来说,这种I/O设计节省面积(总I/O面积仅为0.4mm2),节能(0.063 pj/位),并显著提高系统良率。
VI. 晶圆级网络架构和弹性
当少数小芯片可能出现故障时,我们如何构建晶圆级网络,并确保工作芯片之间的良好连接?
我们使用网状网络连接晶圆上的小芯片。网络路由器驻留在计算小芯片上。为了避免死锁,我们使用维度排序路由(dimension-ordered routing,DoR)。然而,即使每个小芯片具有99.998%的键合良率,整个系统中的2048个小芯片也可能出现一个或几个有缺陷的。使用蒙特卡罗(Monte-Carlo)模拟,我们估计如果任何一对小芯片之间存在单条路径,源目的地对将断开连接的百分比。如图6所示,在晶圆中仅有五个故障小芯片(2048个)的情况下,超过12%的路径断开。
为了克服这个问题,我们设计了两个跨晶圆的独立网络;一个为X-Y维度排序路由,另一个为Y-X维度排序路由,如图7所示。这样,晶片上的大多数小芯片对(两个小芯片不在同一行/列的所有小芯片对)在它们之间具有两条不同的路径。这极大地减少了当晶片上一定数量的小芯片有故障时断开的路径数量。
例如,在晶片上有5个故障小芯片的情况下,当我们从晶片上的单个DoR网络改为两个独立的DoR网络时,断开路径的百分比从>12%降低到<2%。这时,仍然与两个DoR网络断开的路径主要是连接在同一行/列中的小芯片对。
此外,在系统中,网络请求-响应通信使用互补网络进行(这是嵌入到路由器硬件中的)。如图7所示,如果沿着X-Y方向发送从小芯片A到小芯片B的请求,则沿着Y-X方向发送从B到A的响应,以确保请求-响应对(request-response pair)采用相同的路径。这确保了每当存在一条无故障路径时,小芯片之间的双向通信是可能的。这也避免了请求-响应对之间的死锁。
如果给定小芯片边缘的长度,可以避开瓦片的每一侧,支持400位宽的并行小芯片间网络链接。在我们的例子中,整个分组的宽度是100比特。因此,我们将小芯片间链路分成4个独立的并行宽总线,其中两个专用于X-Y网络,另外两个专用于Y-X网络。与每个DoR网络的两条总线相对应的是入口链路和出口链路。
至于使用的正确网络的选择,这个任务留给了内核软件。一旦系统完全组装好,我们就识别出有缺陷的瓦片,并把它们存储在故障图中。然后,内核软件使用故障图的信息来决定用于源-目的地瓦片对的网络。如果两条路径在两个瓦片之间都可用,则内核软件以这种方式将源-目的地对分配给网络,使两个网络被同等地利用。这样做的同时,我们通过将源-目的地对之间的所有通信仅分配给单个网络来,确保数据包的一致性(即数据包按顺序到达)。
此外,我们还可以使用内核软件来规避这个断开的路径问题。
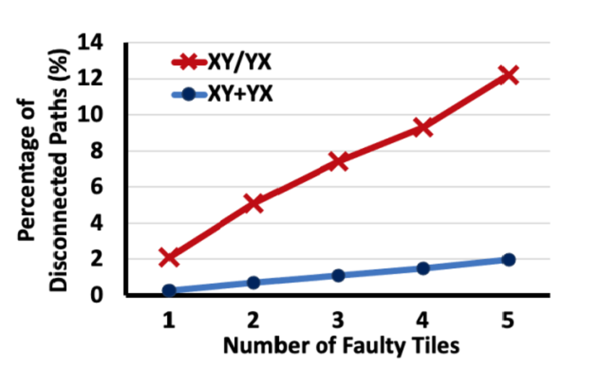
图6: 使用一个或两个网络的传统方案与使用两个网络时的源-目标对的断开平均百分比。
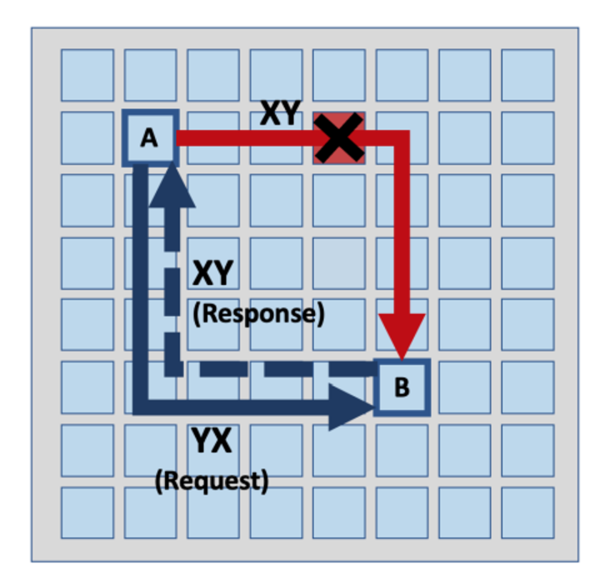
图7: 容错晶圆级网状网络架构
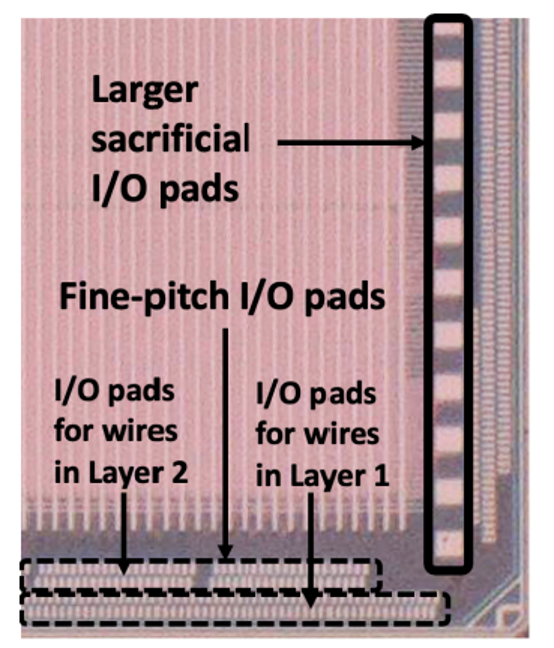
图8: 较大的焊盘用于探针,细间距焊盘用于小芯片间通信。
每当需要通过带有故障瓦片的路径发送分组时,它可以将分组转移到中间瓦片,然后将其从中间瓦片路由到最终目的地。响应数据包也将遵循相同的路径。然而,这需要内核向网络路由分配周期,而不是执行实际的应用程序进程,因此会对整体性能产生不利影响。与单个网络相比,由于我们使用两个DoR网络的解决方案显著减少了断开路径的数量,因此这种性能影响预计会很小。
VII. 测试基础设施
基于芯片的晶圆级技术有望提供比单片方法更好的系统良率。然而,这取决于Si-IF上已知的良好芯片(KGD)和可靠小芯片组件的识别。因此,我们提出这样一个问题——如何设计我们的测试方案来进行预键合测试以及系统组装后测试?
a)瓦片内部的测试基础设施如图9所示,ARM CORTEX-M3内核通过调试访问端口(DAP,基于IEEE 1149.1 JTAG协议减去边界扫描)提供调试访问。使用JTAG接口完成与DAP端口的外部通信。我们系统中的每个瓦片有14个内核,因此有14个DAP接口。一种选择是将所有14个DAP接口放在计算小芯片的边缘;最终到达晶圆边缘进行测试(在我们的例子中,使用基于ARM的MBED微控制器)。然而,这种方案在晶圆的边缘需要大量I/O,例如,对于边缘上的32个小芯片,需要1792位接口。虽然使用高级连接器或在晶圆边缘使用序列化/反序列化可以在边缘处理如此多的I/O,但这超出了本文的范围。因此,我们将计算小芯片内部的所有DAP接口以菊花链形式连接起来(如图9所示),这样只需一个JTAG接口就可以连接到一个链中的多个DAP。我们还提供菊花链,以便它可以扩展到包括多个小芯片的DAP。
在测试期间,所有的内核通常运行相同的测试指令集。此外,根据对许多不规则工作负载的分析,我们发现大多数内核实际上会运行相同的程序(尽管是独立的)。因此,为了最大限度地减少程序加载时间,我们规定将同一程序广播到一个瓦片上的多个内核。这样优化是为了将TDItile的输入广播到所有DAP端口的TDI(Test Data In,测试数据输入)引脚,并将第一个内核的TDO(Test Data Out,测试数据输出)转发到TDOtile。因此,在这种模式下,外部控制器只能看到每个瓦片一个DAP,JTAG位移位延迟因此减少了14倍。
A.预键合测试
预焊接测试对于识别KGD零件至关重要。然而,对于采用细间距IO焊盘设计的未封装小芯片的预键合测试来说,有两个问题使Si-IF组装变得困难:
(1)具有10微米间距和7微米宽度的细间距IO焊盘不适合基于探针卡的测试。探针间距通常大于50μm。
(2)一旦探针落在焊盘上,就会破坏焊盘表面的平面度,而这对于后续可靠的直接金属对金属键合至关重要。
因此,为了解决这些问题,我们为JTAG和一些辅助测试信号设计了更大的备份焊盘。这些较大的焊盘面向探针卡测试而设计,而相应的细间距用于键合到Si-IF。使用这种方法,我们可以彻底测试小芯片,并在键合之前消除有缺陷的小芯片。一旦小芯片被测试,我们就能保证芯片到晶片(die-to-wafer)键合时,不使用被探测接触过的大型焊盘。我们只用铜柱连接未探测的细间距焊盘。同样的JTAG接口可用于键合后加载小芯片的测试例程和程序,但现在使用细间距支柱。
B.装配后测试
在预键合测试之后,无缺陷的小芯片被传递到管芯到晶片(die-to-wafer)的键合过程。过去关于小间距芯片到晶片的工作显示,已经实现了极好的键合良率(>99.99%)。在我们的晶圆级系统中,芯片间I/O总数为3.7M+。即使使用第五节中描述的I/O冗余方案,仍可能发生一些与绑定相关的故障。因此,精确定位故障小芯片的位置非常重要。此外,由于在晶圆级系统中要测试的小芯片的数量非常大,该测试过程需要以高吞吐量进行,并且要求可扩展性。
a)渐进式多小芯片JTAG链展开。如图9和图10所示,我们以这样一种方式设计JTAG链机制,其中TDOtile信号可以被转发到链中的下一个瓦片,或者可以向TDOloop环回。因此,链中的每个小芯片都可以被渐进式和独立地测试。上电时,默认模式是链式环回模式。首先测试链中的第一个小芯片。一旦小芯片通过测试,其测试模式被改变,使得来自第一小芯片的TDOtile被转发到第二小芯片。第二小芯片仍然处于环回模式,因此,来自第二小芯片的TDOtile信号最终通过第一小芯片的TDIbypass和TDOloop信号被带到外部控制器。链被逐渐展开,并且对链中的所有小芯片重复测试过程。这有助于在链展开时识别有故障的小芯片。这种机制也可用于组装期间的测试,以间歇地检查部分键合系统中的故障。该方案将有助于识别和丢弃部分组装的故障系统,并使浪费的KGD小芯片最小化。
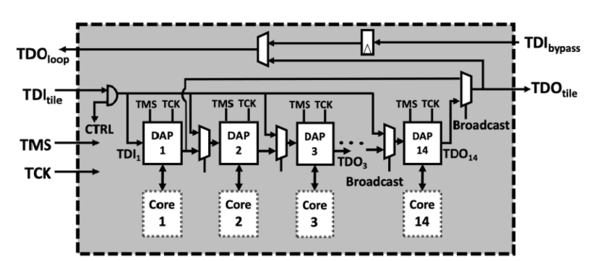
图9:瓦片内部的测试电路的示意图
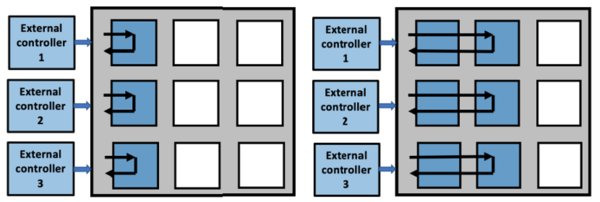
图10:示出了渐进展开方案。逐步展开JTAG链以识别链中的故障小芯片。
b)多链JTAG。为了实现高吞吐量和可伸缩性,我们采用了多链调试方法。我们没有创建一个有1024个瓦片的JTAG菊花链,而是选择将阵列分成32个链,每个链横跨各行。这有两大主要优点:
(1)测试和将程序/数据加载到行中的瓦片可以并行进行。因此,这可以将这些过程的速度提高32倍,将系统上所有内存的加载时间从2.5小时(使用单链)加快到大约5分钟。
(2)将TMS和TCLK信号广播到链中的瓦片。链分离允许每一行都拥有独立的TMS和TCLK信号,并有助于减少这些信号上的负载;这将使我们能够以高达10MHz频率运行这些信号。
VIII.晶圆级基板及对设计的影响
对于如此大的集成基板,我们无法确定晶圆基板的良率。我们设计小芯片I/O的方式是,即使有一个路由层,也要有一个正常工作的处理器系统,尽管共享存储容量减少了。我们在小芯片的每一侧都有两组I/O列(如图8所示),每层信号路由一组。第一组包括最靠近芯片边缘的两个I/O列,以及所有绝对必要的网络链路I/O,还包括与我们的内存小芯片中5个存储体中的两个相关I/O。需要第二路由层的另一组I/O列由非必要的I/O和对应于其余3个存储体的I/O组成。因此,如果只有一个路由层,我们将能够通过连接第一组中的I/O来构建整个处理器系统。唯一的缺点是共享内存容量会减少60%。
由于晶圆的尺寸远大于光罩的最大尺寸,Si-IF衬底必须设计成步进、可重复。整个晶圆被划分成更小的相同光罩,制造时将这些小光罩拼接。每个光罩由72块瓦片(12x6)组成。每个光罩内的小芯片间连接宽度为2微米,间距为3μm。然而,在每个光罩的边缘,逸出的连接变得更宽(宽度增加到3微米,间距减少到2微米),同时保持间距不变,以减少光罩拼接误差的影响。此外,来自网格边缘的每个瓦片的多个I/O需要扇出(fan-out)到晶圆的边缘,并连接到外部连接器。我们的设计将扇出布线和边缘I/O焊盘布局到各个光罩中。我们用外部连接器将这些焊盘连接到光罩,让来自边缘光罩的Si-IF基板上的小芯片槽将保持未组装状态。
为了确保这些I/O焊盘不会导致小芯片键合问题,我们使用定制的块蚀刻工艺(block etch process)来移除不需要的焊盘。如果代工厂支持每个晶圆多个光罩,也可以使用独立掩模在晶片边缘进行印刷。该处理器系统的Si-IF衬底由四个金属层组成。底部两层构建为密集开槽平面,专用于电源。顶部两层是稀疏的,专用于小芯片间信号路由。使用当今的传统工具来设计互连基板的主要挑战是系统的绝对规模。
当使用当前的商业工具设计一个>15000mm2的四层晶圆时,存储器引脚会爆炸,这又导致非常长的设计时间。因此,我们专门开发了一个定制的轻型路由器,用于设计四层晶圆级基板。路由器的当前版本仅支持小芯片间连接的无jog路由(jog-free routing),这对于该原型来说已经足够了。至于为大型(但低布线密度)小芯片组件开发通用、可扩展的路由器,那是我们未来工作的一部分。
IX. 总结和结论
小芯片组装是构建外延异构(scale-out heterogeneous)计算系统的一种非常有前途的方法。本文描述了我们设计基于小芯片组件的大型晶圆级处理器(至少比已知的最大商业化小芯片基系统大10倍)的经验,并开发了同样的设计方法。我们重点介绍了晶圆级系统在功率传输、时钟分配、网络设计、可测试性设计和容错方面的挑战和潜在解决方案。据我们所知,这是第一篇讨论基于大芯片组装系统的设计方法挑战的文章。我们的手头工作旨在对晶圆级原型进行定性,并为更高功率的晶圆级系统开发设计方法。
原文链接:
https://nanocad.ee.ucla.edu/wp-content/papercite-data/pdf/c116.pdf
