机器学习正在成为我们日常使用的许多应用程序的重要组成部分。ML模型通过面部和语音识别、标签图像、交友和购物建议、在互联网上搜索内容、编写代码、撰写电子邮件,甚至驾驶汽车来验证我们的身份。随着如此多的关键任务被转移到机器学习和深度学习模型中,人们对它们的安全性感到担忧是合理的。
随着机器学习的使用越来越多,人们对其安全威胁的兴趣也越来越大,其中,最突出的是对抗性的例子,对输入的难以察觉的变化操纵机器学习模型的行为,对抗性攻击可能导致从恼人的错误到致命的错误。
关于对抗性机器学习的论文发表是如此之多,很难让你的脑袋明白这个领域正在发生的一切。幸运的是,AI研究人员Chen pinyu和Cho-Jui Hsieh合著的《 Adversarial Robustness for Machine Learning》《机器学习的对抗鲁棒性》一书对这一主题进行了全面概述。
Chen和Hsieh汇集了对抗性机器学习关键组件背后的直觉和科学:攻击、防御、认证和应用。以下是你将学到的内容的总结:
对抗性攻击
对抗性攻击是基于在机器学习系统中发现故障模式的技巧,最著名的对抗性攻击类型是针对计算机视觉系统的逃避攻击或测试时攻击。在这些攻击中,对手会在图像中添加一层难以察觉的噪声,从而导致目标机器学习模型对图像进行错误分类。被操纵的数据通常被称为对抗样本。
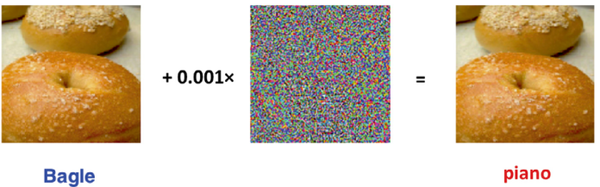
对抗性攻击的例子
对抗性攻击技术通常基于攻击成功率(ASR)进行评估,ASR是成功改变目标ML模型行为的示例的百分比。对抗性攻击的第二个标准是成功攻击所需的扰动量。扰动越小,技术越强,也越难被探测到。
对抗性攻击可以根据对手对目标ML模型的访问和知识进行分类:
白盒对抗攻击:在白盒攻击中,对手完全了解目标模型,包括其架构和权重。白盒对抗攻击利用目标模型的权值和梯度来计算对抗噪声。白盒攻击是创建对抗性示例的最简单方法,它们还具有最高的ASR,并且需要最低的扰动。
在生产系统中,攻击者通常不能直接访问模型,但白盒攻击是非常好的工具,可以在将机器学习模型部署到公众面前之前测试它的对抗鲁棒性。
黑盒对抗攻击:在黑盒攻击中,对手通过中间系统访问机器学习模型,例如web应用程序或应用程序编程接口(API),如谷歌Cloud Vision API、Microsoft Azure Cognitive Services和Amazon Rekognition。
黑盒对抗性攻击不了解底层ML模型的架构和权重。他们只能查询模型并评估结果。如果ML系统返回多个类别及其置信度分数(例如,钢琴:85%,百吉饼:5%,鲨鱼:1%等),则对手可以进行软标签黑盒攻击。通过逐渐对图像添加扰动,并观察ML系统输出分数的变化,攻击者可以创建对抗示例。
在某些情况下,ML系统返回单个输出标签(例如,钢琴)。在这种情况下,对手必须进行硬标签黑盒攻击。这种类型的攻击更加困难,但并非不可能。
除了扰动水平和ASR,黑盒攻击的评估还基于其查询效率,即创建对抗示例所需的查询数量。
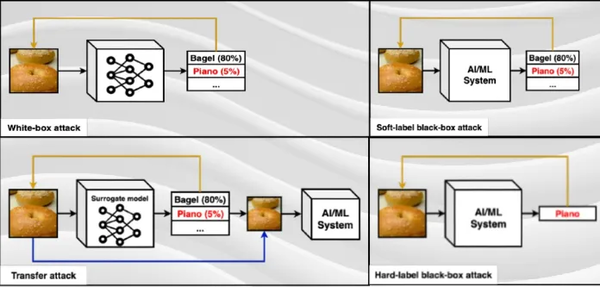
不同类型的机器学习对抗攻击
传输攻击是一种攻击类型,攻击者使用源ML模型为目标模型创建对抗示例。在典型的传输攻击设置中,对手试图以黑盒模型为目标,并使用本地白盒模型作为代理来创建对抗示例。代理模型可以通过从黑盒模型中获得的软标签进行预训练或微调。
传输攻击是困难的,特别是如果目标模型是一个深度神经网络。如果不了解目标模型的体系结构,就很难创建一个可以创建可转移的对抗示例的代理模型,但这并非不可能,有几种技术可以帮助提取关于目标模型的足够信息,以创建有效的代理模型。传输攻击的优势在于,它们克服了访问远程ML系统的瓶颈,特别是当目标API系统为每次推断向客户收费或具有防御机制以防止对抗性探测时。
在机器学习的对抗鲁棒性中,Chen和Hsieh深入探讨了每种类型的攻击,并为相关论文提供了参考。
其他类型的对抗性攻击
虽然针对计算机视觉系统的测试时攻击受到了媒体的最多关注,但它们并不是针对机器学习的唯一威胁。在机器学习的对抗性鲁棒性中,您将了解其他几种类型的对抗性攻击:
物理对抗性攻击是一种攻击类型,攻击者创建的物理对象可以欺骗机器学习系统。一些常见的物理对抗性例子是针对面部识别系统的对抗性眼镜和化妆品,用于躲避人体探测器的对抗性t恤,以及欺骗自动驾驶汽车路标探测器的对抗性贴纸。
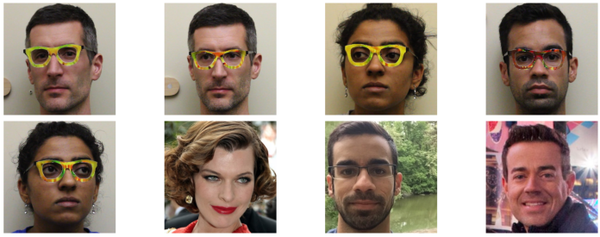
卡内基梅隆大学的研究人员发现,通过戴上特殊眼镜,他们可以欺骗面部识别算法,将他们误认为是名人。
训练时对抗性攻击:如果对手能够访问机器学习系统的训练管道,他们将能够操纵学习过程以达到自己的优势。在数据中毒攻击中,对手修改训练数据以降低训练模型在一般情况下或特定类别上的准确性。在后门攻击中,对手通过添加带有触发模式的示例来污染训练数据。经过训练的模型对模式变得敏感,攻击者可以在推理时使用它来触发所需的行为。
图像之外的对抗性攻击:图像分类器并不是唯一一种可以作为对抗性攻击目标的机器学习模型。在机器学习的对抗性鲁棒性中,Chen和Hsieh讨论了处理文本、音频信号、图形数据、计算机指令和表格数据的机器学习系统的对抗性示例。每一种都有其特定的挑战和技巧,作者在书中讨论了这些问题。
对抗性防御技术
对抗性防御技术保护机器学习模型不受篡改示例的影响。一些防御技术修改了训练过程,使模型在对抗实例时更加健壮。其他是后处理计算,可以降低对抗性示例的有效性。
值得注意的是,没有什么防御技术是完美的。然而,许多防御技术是兼容的,可以结合起来提高模型对对抗性攻击的鲁棒性。
对抗性训练:在训练模型之后,ML工程团队使用白盒攻击技术来创建对抗性示例。然后,该团队使用对抗示例及其适当的标签进一步训练ML模型。对抗性训练是最广泛使用的防御方法。
随机化:另一种保护机器学习模型的方法是将随机化的组件集成到模型中。一些技术可以是随机退出和层切换,随机化使得攻击者更难以对模型进行固定攻击。
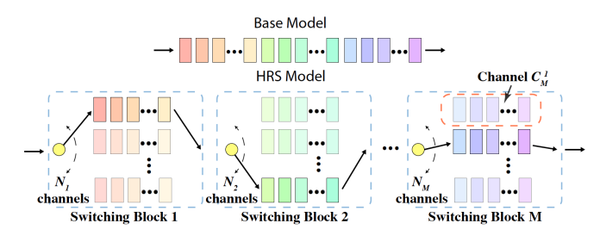
随机切换可以提高对抗鲁棒性
检测:使机器学习模型对各种对抗性攻击具有健壮性是非常困难的,改进对抗性防御的一种补充方法是创建一个额外的系统来检测异常示例。
过滤和投影:一个额外的防御向量在将输入传递给机器学习模型之前对输入进行修改,这些修改是为了过滤可能添加到输入数据中的对抗性噪声。例如,可以训练生成式ML模型将图像作为输入,并通过保持主要特征和去除分布外噪声来重现图像。
离散组件:大多数对抗性攻击技术都是基于梯度计算。因此,另一种防御方法是将离散组件集成到机器学习模型中。离散组件是不可微的,这使得基于梯度的攻击更加困难。
对抗性机器学习的不同心态
机器学习的对抗鲁棒性讨论了对抗性机器学习的其他方面,包括验证ML模型的认证鲁棒性,还探讨了对抗性例子的一些积极方面,例如为新的应用程序重新编程训练过的模型和生成对比的解释。
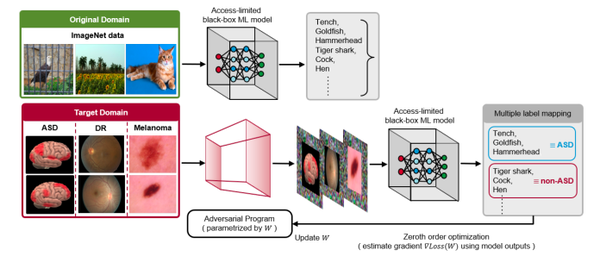
黑盒对抗性重新编程可以将神经网络重新用于新任务,而无需完全访问深度学习模型。
Chen和Hsieh提出的一个重要观点是,需要重新思考我们如何评估机器学习模型。目前,训练过的模型是根据它们对测试集分类的准确性来分级的,但是标准的准确性指标并没有说明ML模型对对抗性攻击的鲁棒性。事实上,一些研究表明,在许多情况下,较高的标准精度与对抗性扰动的高敏感性有关。
最后,在标准精度和对抗鲁棒性之间这种不可取的权衡表明,人们应该使用本书中讨论的技术来评估和提高机器学习的对抗鲁棒性。
原文链接:https://bdtechtalks.com/2023/01/23/adversarial-machine-learning-book/
