3D片上系统(3D SoC)由电子设计自动化(EDA)和3D工艺技术实现,是一种极具吸引力的异构集成方法,可用于解决高性能系统中的存储墙问题。如果将集成晶片的背面用于功率传输、信号路由或两者,可以实现系统级的进一步性能增益。2021年IEEE国际电子器件会议(IEDM)上发表的两篇论文曾强调了3D-SoC设计和特定电路中背面互连的优势。在这篇文章中,Dragomir Milojevic、Geert Van der Plas和Eric Beyne揭示了这些有前途的方法。
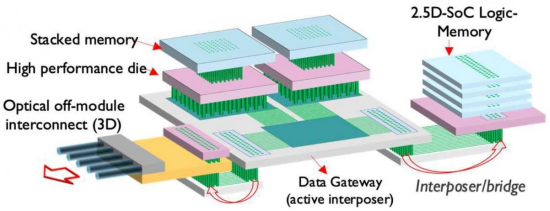
图1:未来可能的高性能系统的抽象图。
3D-SoC设计方法的前景
用于高级计算、数据服务器或深度学习应用的数据密集型高性能系统,越来越多地遭遇所谓的内存墙(memory wall)的挑战,很难足够快速地访问数据。拆除这堵内存墙的一个有趣方法是3D片上系统(3D SoC)集成。根据这种异构集成方法,系统被自动划分为独立芯片,这些芯片被同时设计并在三维空间中互连。
在2021年IEDM论文“3D-SoC集成,超越2.5D小芯片”中,作者解释了这种3D-SoC概念如何超越当今流行的小芯片方法,以实现多芯片异构系统集成。imec R&D副总裁兼3D系统集成项目总监Eric Beyne说:“小芯片技术涉及单独设计和加工的小芯片管芯。一个众所周知的例子是高带宽存储器(HBMs)——动态随机存取存储器(DRAM)芯片的堆叠。这种内存堆栈通过接口总线连接到处理器芯片,这限制了它们在容许延迟的应用中的使用。因此,小芯片概念将永远不允许快速、一级和中级高速缓冲存储器与逻辑之间的快速访问。"
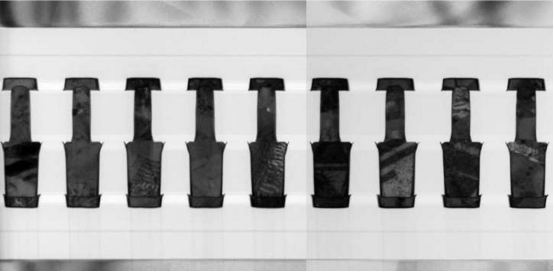
图2:间距为700纳米的晶圆到晶圆(Wafer-to-wafer)混合键合(如2021年IEDM所展示)。(Credit:IMEC)
借助3D-SoC集成,可以使用更短的直接互连实现内存逻辑分区,从而显著提高性能。在他们的特邀论文中,作者展示了一种3D-SoC设计的优化实施,其中内存宏位于顶部芯片中,其余逻辑位于底部芯片中,与2D设计相比,工作频率提高了40%。
他们还讨论了实现全功能3D SoCs的关键挑战。imec首席科学家、布鲁塞尔自由大学教授Dragomir Milojevic表示,“在设计方面,逻辑和内存分区都需要3D-SoC协同设计策略。这需要能够同时处理两种设计的专用电子设计自动化(EDA)工具,在布局布线期间使用自动化工具进行系统划分和3D关键路径优化。通过与Cadence的合作,我们可以使用这些高度先进的工具。”在技术方面,晶片到晶片(Wafer-to-wafer)混合键合解决方案的发展将允许非常高的芯片到芯片(chip-to-chip)互连密度,这是一级和中级高速缓存存储器分区所必需的。
下一步:开发晶圆的背面
高性能3D-SoC系统的一种可能的划分涉及将一些或所有存储器宏放置在顶部管芯中,而将逻辑放置在底部管芯中。在技术方面,这可以通过使用低温晶片到晶片键合技术将“逻辑晶片”的有源正面键合到“存储器晶片”的有源正面来实现。在这种配置中,两个晶片的原始背面现在位于3D-SoC系统的外部。
Eric Beyne说,“我们现在可以考虑利用这些晶片的‘自由’背面进行信号路由或直接为‘逻辑晶片’中的晶体管供电。”传统上,信号路由和功率传输发生在晶片的正面,在复杂的后段制程互连方案中,它们在此竞争空间。在这些设计中,晶片的背面仅作为载体。2019年,Arm的模拟首次显示了在CPU设计中使用背面功率传输网络(BSPDN)的有益影响,该设计实施了imec开发的3纳米工艺。在这种设计中,位于晶片薄背面的互连金属使用位于埋入电源轨上的硅通孔(tsv)连接到晶片正面的3nm晶体管。仿真表明,该BSPDN的效率是传统前端PDN的7倍。
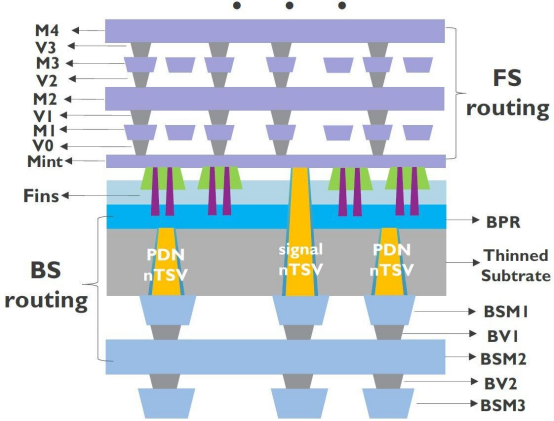
图3:用于PDN和信号路由的传统正面(FS)BEOL和背面(BS)金属示意图。用于PDN布线的BS金属使用ntsv将BS金属连接到埋地供电轨,而用于信号布线的BS金属使用ntsv将BS金属连接到FS金属(如2021 IEDM上所示)。(Credit:IMEC)
因此,当BSPDNs用于为“逻辑上存储”3D-SoC底部的高功耗核心逻辑电路供电时,可以获得额外的性能提升。人们还可以想到替代的3D-SoC分区,其中部分存储器瓦片,例如,L1级高速缓存静态随机存取存储器(SRAM)也驻留在底部管芯中,也从背面供电。
除了扩展3D-SoC设计的可能性之外,BSPDNs还被提议用于单芯片逻辑和SRAM片上系统(SoC),可以帮助进一步的器件和ic缩放。imec项目经理Geert Van der Plas认为,“将供电网络移至芯片背面已被证明是解决后端(BEOL)布线拥塞挑战和降低IR-drop的一种有趣方法。3D-SoC方法的一个主要区别在于,现在可将虚拟晶片结合到目标晶片上,以允许背面晶片变薄和金属化。”最近,imec的一个合作伙伴宣布将在未来的一个节点芯片中实现这样的BSPDN概念。
背面互连进一步提高SRAM宏和逻辑的性能
BSPDN优势在具体设计中已得到验证,使用晶圆背面进行全局信号路由的更多优势有望进一步开发。Imec与Cadence合作,首次评估并优化了部分从背面布线的SRAM宏和逻辑电路设计。SRAM宏不仅涉及存储器位单元阵列,还涉及与处理器设计相关的外围电路,如地址解码器、控制块等。
对于SRAM宏和逻辑,多达三个背面金属层用于信号路由,而纳米tsv(nTSVs)将背面金属化连接到正面。SRAM宏在设计上实现了2nm纳米片晶体管。在这些宏中,只有外围电路的全局布线设计有背面金属化。对于逻辑,使用环形振荡器框架来评估背面信号路由的影响。该设计在逻辑标准单元中实现了2nm技术节点的叉片(forksheet)器件。使用相同的2nm叉片工艺设计套件(PDK)的64位ARM CPU的物理实现,保证了环形振荡器仿真结果的意义。
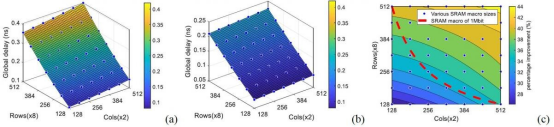
图4:SRAM宏在不同宏行和列的全局路由延迟(读取访问)。(a) FS;(b)BS;(c)从FS到BS的改进。宏的范围从128*128*16 = 256kbit到515*512*16 = 44Mbit(如在2021 IEDM上呈现的)。(Credit:IMEC)
Geert Van der Plas表示,“与正面布线相比,背面布线在改善长互连信号布线的延迟和功率效率方面更加有益。对于SRAM宏,与前端布线相比,我们实现了高达44%的性能提升和高达30%的功效提升。对于逻辑单元,背面布线使速度提高了2.5倍,能效提高了60%。”R. Chen等人在2021年的IEDM论文“在2nm节点使用背面互连的SRAM宏和逻辑设计和优化”中描述了这些结果。
通过结合实验和建模,可以对电路的性能和功效进行评估。Dragomir Milojevic表示,“实验包括根据电容和电阻表现进行nTSV工艺优化,以确保正面和背面金属之间的良好电连接。这些参数被输入到一个模型中,用于进行模拟。最后,我们的团队进行了设计技术协同优化(DTCO)驱动的路由优化,展示了进一步改进的途径。我们证明,通过降低背面金属的电容,性能又提高了20%。”
原文链接:
https://techxplore.com/news/2021-12-benefits-3d-SoC-backside-interconnects-future.html
