来自高性能处理器的数据表明,延续摩尔定律的新方向即将到来。每一代处理器都需要比上一代性能更好,这也意味着需要在硅片上集成更多的逻辑电路。但是目前在芯片制造领域存在两个问题:一是缩小晶体管及其构成逻辑和内存块的能力正在放缓;另一个是芯片已经达到了尺寸极限。
近几年来,片上系统(SoC)开发人员开始将较大的芯片设计分解成较小的芯片,并在同一个封装内将它们连接在一起。CPU连接技术大多是2.5D封装,其中小芯片彼此并排放置,并使用短而密集的互连连接。由于大多数制造商已就2.5D“D2D”通信标准达成一致,这种集成趋势会不断发展。
但是,由于数据存储需求增加,要想将大量数据存储在同一个芯片上,就需要更短、更密集的连接,而这只能通过将一个芯片叠加在另一个芯片上来实现。将两个芯片“面对面”连接意味着每平方毫米进行数千次连接。
这需要大量的创新才能实现,工程师必须弄清楚如何防止堆栈中一个芯片由于过热毁掉另一个芯片,防止偶尔出现的坏小芯片导致整个系统崩溃等,并即刻处理这些问题。
这里有三个来自AMD、Graphcore和英特尔的例子,分别从简单到复杂,显示了颠覆计算的三种3D堆叠技术。
AMD Zen 3
长期以来,个人电脑可以选择增加内存来提高超大应用程序和大数据量的工作速度。得益于3D芯片堆叠,AMD的下一代CPU小芯片将提供这种选择。
Zen 2和Zen 3处理器内核都使用相同的台积电制造工艺,因此具有相同尺寸的晶体管、互连等。AMD在架构上做了很多改变,即便没有额外的缓存内存,Zen 3的平均性能也提高了19%。
Zen 3架构亮点之一是采用了背部足够薄的硅通孔(TSV)垂直堆叠芯片,这是一种将多个芯片相互连接的方式。TSV是在Zen 3最高级别缓存中构建的,即称为L3的SRAM块,它位于计算小芯片的中间,并在所有8个核心上共享。
在处理繁重数据的处理器中,Zen 3晶圆背面被减薄,直到TSV暴露出来,然后,一个64M的SRAM小芯片被连接到那些暴露的 TSV上,该过程使用的是混合键合——一种类似于铜冷焊的过程,这实现了一组间距为9微米的密集连接。最后,为了结构稳定和热传导,在Zen 3 CPU die的剩余部分用空白硅小芯片填充。
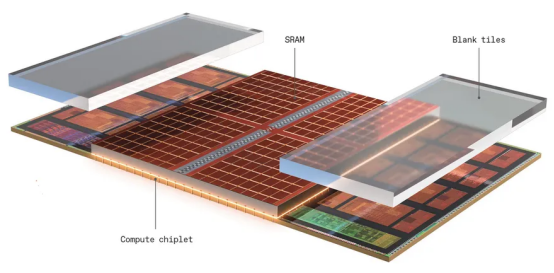
AMD 3D V-Cache技术将一个64M字节的SRAM缓存(红色)和2个空白结构小芯片堆叠到Zen 3计算小芯片上。
“通过将空白硅小芯片设置在CPU die旁边来增加额外的内存是不可取的,因为数据要花费太长的时间才能到达处理器核心。尽管L3缓存大小增加了三倍,但3D V-Cache仅增加了四个时钟周期的延迟——这只能通过3D堆叠来实现,”AMD高级设计工程师John Wuu表示。
更大的缓存在高端游戏中崭露头角。使用带有3D V-Cache的桌面锐龙CPU,在1080p下渲染的游戏速度平均提高了15%。这对更苛刻的工作也有好处,将一个繁重的半导体设计计算的运行时间缩短了66%。
Wuu指出,与缩小逻辑的能力相比,业界缩小SRAM的能力正在放缓。因此,预计未来SRAM扩展将继续使用更成熟的制造工艺,而计算小芯片则被推向摩尔定律的前沿。
Graphcore Bow AI处理器
即使堆栈中的芯片没有晶体管,3D集成也能加快计算速度。总部位于英国的AI计算机公司Graphcore仅通过在其AI处理器上安装电力传输(power-delivery)芯片,就实现了系统性能的大幅提升。
添加电力传输芯片意味着Graphcore Bow的组合芯片可以运行得更快(1.85-1.35GHz),并且电压低于前一代。这意味着与上一代相比,计算机训练神经网络的速度提高了40%,能耗降低了16%。最重要的是,用户无需更改其软件即可获得这种改进。
电源管理芯片由电容器和硅通孔堆叠而成,后者为处理器芯片提供电力和数据,真正与众不同的是电容器。与DRAM中的位存储组件一样,这些电容器是在硅中又深又窄的沟槽中形成的。由于这些电荷储存器非常靠近处理器的晶体管,功率传输变得平滑,从而使处理器内核能够在较低电压下更快地运行。
如果没有电力传输芯片,处理器必须将其工作电压提高到高于标称水平才能在1.85GHz下工作,这样会消耗更多的功率。使用电源芯片,它也可以达到既定的时钟频率并消耗更少的功率。
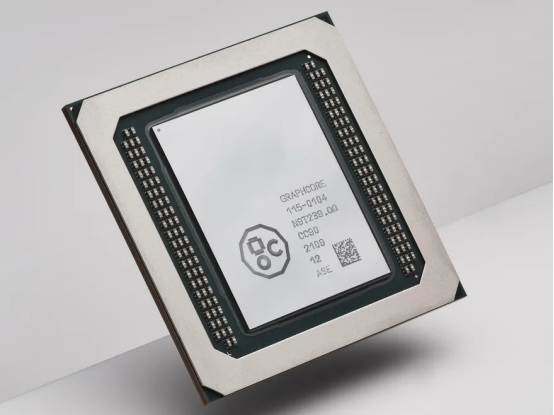
Graphcore Bow AI加速器使用3D芯片堆叠将性能提升40%。
Graphcore Bow制造工艺是独一无二的。大多数3D堆叠是通过将一个小芯片粘合到另一个小芯片上来完成的,其中一个仍然在晶圆上,称为晶圆上芯片。相反,Graphcore Bow使用了台积电的“晶圆 - 晶圆”技术,其中一种类型的整个晶圆与另一种类型的整个晶圆键合,然后切割成芯片。
Graphcore首席技术官Simon Knowles表示,这是市场上第一款使用该技术的芯片,它使两个裸片之间的连接密度高于使用晶圆芯片工艺所能达到的密度。
尽管电力传输小芯片没有晶体管,但不久的将来可能会出现。Knowles说,仅将这项技术用于电力传输只是第一步,在不久的将来,它会走得更远。
英特尔Ponte Vecchio超级计算机芯片
Aurora超级计算机旨在成为美国首批突破exaflop障碍的高性能计算机(HPC)之一——每秒10亿次高精度浮点计算。为了让 Aurora达到这些性能,Ponte Vecchio将47块硅片上超过1000亿个晶体管封装到一个处理器中。英特尔同时使用2.5D和3D技术,将3,100平方毫米的硅片(几乎等于四个Nvidia A100 GPU)压缩到2,330平方毫米的空间中。
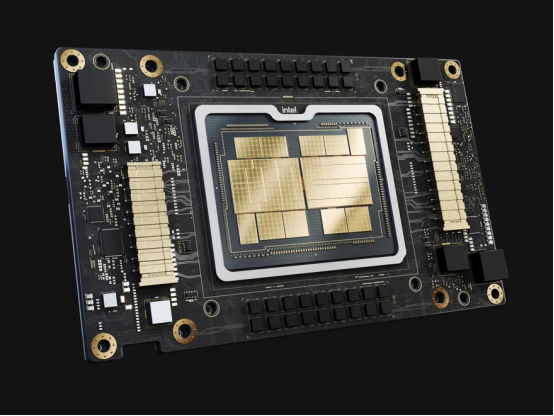
英特尔Ponte Vecchio处理器将47个小芯片集成到一个处理器中。
每个Ponte Vecchio实际上是两组镜像芯片,使用英特尔的2.5D集成技术Co-EMIB连接在一起,Co-EMIB在两个3D小芯片堆栈之间形成高密度互连的桥梁。“桥”本身是嵌入封装有机基板中的一小块硅,硅上互连布线的密度可以是有机基板上的两倍。Co-EMIB die还将高带宽内存和I/O小芯片连接到基础瓦片(base tile,最大的小芯片,其他芯片都堆叠在其上)。
基础瓦片使用英特尔的3D堆叠技术,称为Foveros,在其上堆叠计算和缓存小芯片。该技术在两个芯片之间建立了密集的die-to-die垂直连接阵列,这些连接是36微米。信号和电源通过硅通孔进入这个堆栈,较宽的垂直互连直接穿过硅的大部分。
八个计算瓦片、四个缓存瓦片和八个用于给处理器散热的空白瓦片都连接到基础瓦片上。基础瓦片本身提供缓存内存和允许计算瓦片访问内存的网络。
英特尔研究员Gomes表示:这一切都不容易,Ponte Vecchio在良率管理、时钟电路、热调节和功率传输方面都进行了创新。例如,英特尔工程师选择为处理器提供高于正常电压(1.8V)的电压,以便电流足够低以简化封装。基础瓦片中的电路将电压降低到接近0.7V以用于计算瓦片,并且每个计算瓦片必须在基础瓦片中有自己的电源域。关键是新型高效电感器,称为同轴磁性集成电感器。因为这些都内置在封装基板中,所以在向计算瓦片提供电压之前,电路实际上在基础瓦片和封装之间来回移动。
Gomes表示,从2008年的第一台petaflop超级计算机到今年的exaflops用了14年,先进的封装技术如3D堆叠,将有助于提高计算能力。
原文链接:
