深度学习是一种关键的计算方法,它正在推动技术的边界——处理海量数据,并揭示人类自己永远无法识别的微妙模式。“但为了获得最佳性能,深度学习算法需要得到正确的软件编译器和硬件组合的支持。”特别是,可重构处理器是关键,它允许根据需要灵活使用硬件资源进行计算。在最近的一项研究中,香港科技大学研究人员报告了一种新的可重构处理器,称为ReAAP,其性能优于几种常用于支持深度神经网络(DNNs)的计算平台,DNNs是一种有用的深度学习形式,通常涉及具有许多计算密集型数据层的大型数据集。
ReAAP软硬件协同设计
普通处理器通常允许“使用特定的硬件路径处理”数据,而可重构处理器提供了一种更具适应性的选择:根据需要重新配置最有效的硬件资源来处理数据。“可重构处理器结合了软件灵活性和硬件并行性的优势,”香港科技大学电子和计算机工程系博士后研究员郑建卫解释说,他参与了这项研究。
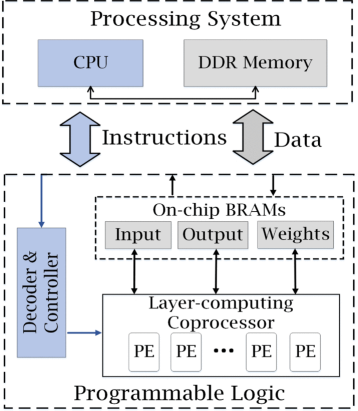
在嵌入式FPGA平台上实现的ReAAP异构系统。提议的软件编译器及其JIT在嵌入式CPU上运行,提议的可重构阵列架构用作层级计算协处理器。
这些优势促使他的团队创建了ReAAP,这是一个集成的软硬件系统,软件编译器负责评估和优化多样化的深度学习工作负载。一旦确定了并行处理数据的最佳解决方案,ReAAP就发送指令来重新配置硬件协处理器,由该协处理器分配适当的硬件资源进行并行计算。“作为一个端到端的系统,只需在软件中为每个应用定制一个Python脚本,就可以部署ReAAP来加速各种深度学习应用,”郑博士解释道。
他们提出的协同设计法原则是让所有并行PE尽可能忙碌。通过平衡考虑软件灵活性和硬件并行性,ReAAP上的端到端性能评估表明,在三个常用模型(包括ResNet、MobileNet和BERT)中,所有不同层级的处理单元(PE)利用率都很高。只有边缘PE连接到片上暂存区,其他PE与其邻居互连。因此,所提出的阵列体系结构可以容易地在规模上重新配置,并且可以在高工作频率下工作。
在DNNs中,每个输入特征映射与所有权重过滤器一起重复使用,而每个权重过滤器用于每个输出特征映射。相同权重的过滤器在一批独立样品中重复使用。对这些重用数据进行并行和流水线处理是避免大型近MAC缓冲区的关键方法。因此,在这项研究中,研究团队提出了一个细粒度的2D脉冲阵列来捕捉这些并行性和数据重用机会。由于提出的阵列结构中的高度流水线组织,每个滤波器仅需要一个数据,每个MAC仅需要一个部分和。同时,脉冲阵列的硬件特性被认为是软件编译过程中的硬件约束参数。
实践中,映射PE集的大小由给定层的权重和输入映射的大小决定。需要提出一种定制的数据分块策略来将PE集映射到物理PE阵列上,这意味着在空间架构内组合时间数据流。从时间角度来看,具有专用数据流的定制数据分块策略能够重新配置空间架构,以便在DNNs中映射给定的层计算模式。在某种程度上,寻找一个支持并行计算且数据移动代价最小的最优时态数据流对于重构空间体系结构至关重要。
在这项研究中,一个基本形式的2D脉冲阵列被选为理想的空间架构映射层计算模式在DNNs。互连的PE共同组成有节奏工作的脉冲阵列——在每个时间步,每个PE从一些邻居读取输入,执行计算,并将输入或部分和转发给其他邻居。并行计算由具有可重新配置的架构参数确定的时间数据流驱动。近邻互连的特性适合于重用输入数据或传递每层的部分和,从而降低数据传输的高压。当考虑将层计算模式作为生成脉冲数据流配置的基础时,最佳目标是最小化脉冲阵列的计算延迟,同时平衡存储器访问。
时空计算的组合包括三个方面:PE内部的逻辑电路设计、空间架构拓扑设计和时态数据流配置。特别是,PE内部的逻辑电路被设计成利用缓冲寄存器来执行算术计算。为了避免影响PE级的延迟,通过在每个PE内添加双缓冲区来采用双缓冲技术,以通过邻居PE传递数据。对于其他两方面,我们设计背后的创新是将时间数据流配置从空间拓扑结构设计中分离出来。
研究还提出了一种可重构阵列结构,这对于一系列架构参数(如数据流选择、数据分块策略、物理阵列大小、位宽精度等)来说是不可或缺的。该架构可重新配置,支持广泛使用的数据流、定制的阵列大小和不同的数据块策略,这些可以提前固定或在运行时配置。在运行期间,输入和权重矩阵从主DRAM存储器预加载到片上便笺式存储库中。如所配置的,输入矩阵和权重矩阵的预加载数据直接馈入瓦片阵列,瓦片阵列将部分和矩阵的数据写回片上便签式存储器组或其它功能单元。
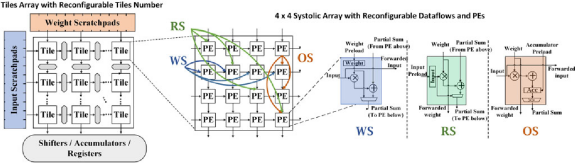
建议的可重构阵列结构。一个瓦片包括16个以4×4脉冲阵列结构组织的PE。切片数量可重新配置,可适应不同的层级工作负载。所有图块被分配在管道网格内以形成图块阵列,4×4脉冲阵列和每个PE可用不同数据流重新配置。
结果及分析
将研究提出的软件编译器与Nvidia GPU和ARM CPU上的其他基线软件编译器进行比较。结果表明,协同设计方案能够有效地将软件灵活性与硬件并行性相结合,以加速多样化的深度学习工作负载。它的执行速度是运行在“GPU”上的下一个最佳软件编译器的1.9-5.7倍,是运行在“CPU”上的相同软件编译器的1.6-3.3倍。
作为一个整体系统,ReAAP实现了持续的高硬件资源利用率,用于加速ResNet、MobileNet和BERT中所有不同的计算密集型层。此外,ReAAP在各种不同的计算密集型层实现了一致的高硬件资源利用率。
虽然ReAAP擅长处理具有典型数据密集型工作负载的DNN,但它目前不太适合在数据稀疏时支持DNN。研究人员希望在未来解决这个问题,希望以ReAAP为基础更好地处理量化数据,以显著降低神经网络的内存需求和计算成本的方式处理的数据。
“在(ReAAP更好地处理量化数据的)扩展完成和评估后,我们考虑将其与其他几个AI计算加速解决方案一起商业化,这将使ReAAP在资源受限的平台上更有效,如各种物联网(IoT)设备,”郑博士说。
参考链接:
