渴望更高性能功耗比的人工智能(AI)算法推动了特定硬件设计技术的发展,包括用于片上系统(SoC)设计的内存计算。内存计算主要出现在寻求颠覆行业的半导体初创公司中,但许多行业领导者也在幕后应用内存计算技术。
使用内存计算的创新设计旨在颠覆AI SoC格局。首先让我们来看看使用内存计算的初创公司想要颠覆的现状。自2015年公司和风投开始大举投资专门针对AI的新SOC以来,AI硬件取得了巨大飞跃。在过去5年里,投资一直在加速,为行业领导者带来了AI硬件设计的许多改进。英特尔的x86处理器增加了新的指令,甚至还有一个独立的NPU引擎。Nvidia增加了特定的张量内核,并放弃了GDDR来实现HBM技术,以增加内存带宽。谷歌开发了专用于AI算法的专用ASIC TPUs,或张量处理单元(图1)。但即使这些架构继续改善,投资者也在期待初创公司开发AI技术的下一个突破。
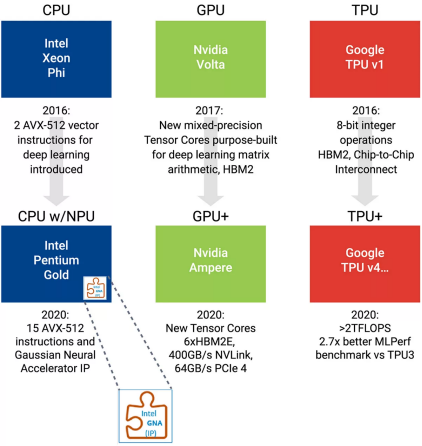
图1,英特尔、英伟达和谷歌正在推出新的硬件架构,以提高AI应用的性能功耗比。
为什么AI计算的中断如此有趣?
对AI硬件进行大量投资的三个关键原因是:
1)生成的数据量呈指数级增长,AI是解决复杂性的关键技术;
2)在现有架构下,运行AI算法的功率和时间成本仍然太高,特别是在边缘;
3)AI计算引擎的并行化正在达到芯片尺寸极限,推动这些系统扩展到多个芯片,这仅在云或边缘云数据中心中实用。
总之,这些新挑战正在推动设计人员探索新的、创新的硬件架构。内存计算被视为最有前途的硬件创新之一,因为它可以提供多个数量级的改进。
AI计算颠覆的路径
目前,初创公司和领先的半导体提供商正在寻找AI计算加速的潜在途径。
新的神经网络经常被引入。例如,谷歌研究团队已经产生了EfficientNet,高级大脑研究发布了LMU,Lightelligence与麻省理工学院合作运行高效单一神经网络(EUNNs)。
几家初创公司正在探索集成光子学,将其作为另一种颠覆方法。
正在开发压缩、修剪和其他技术,以使特定的AI功能能够在小型、高效的处理器上运行,如DesignWare在100MHz下运行的EM处理器IP。
通过封装多个芯片、多个主板或多个系统来扩展计算系统已经成为行业领导者的主流。该解决方案用于解决最复杂、最昂贵的AI挑战。
这些提高性能的方法都在探索或已经实现。除了其他正在开发的技术之外,内存计算设计可以建立在这些方法基础上,通过多倍的改进来提高效率。
什么是内存计算?
内存计算是指在硬件处理元件旁边或内部设计内存。内存计算利用寄存器文件、处理器中的内存,或者将SRAMs阵列或新的内存技术转化为寄存器文件或计算引擎本身。对于半导体来说,内存计算的本质可能会推动AI成本的显著改善,减少计算时间和功耗。
内存计算包括硬件和软件元素,这可能会引起一些混淆。从软件的角度来看,内存计算指的是在本地存储中处理分析。基本上,该软件充分利用了靠近计算机的内存。从硬件角度来看,“存储器”有点模糊,可以指本地系统中的DRAMs、SRAMs、NAND闪存和其他类型的存储器,而不是通过网络软件基础架构获取数据。优化软件以利用更本地化的内存为行业发展带来了巨大的机遇,工程师团队需要继续关注系统层面的这些创新。然而,对于硬件优化,内存计算提供了更接近模拟人脑的位级创新,其效率是当今计算的1000倍。
内存计算不仅仅是AI算法的神奇解决方案——它有不同的实现方式,并且是从一系列创新中演变而来的。寄存器文件和高速缓存的实现已经存在了几十年,近存储器计算已经成为改进的自然进程,并且在过去几年中已经在新的SOC中实现。AI算法需要数百万甚至数十亿的系数和乘法累加(MACs)。为了有效地执行所有这些MAC,用于MAC阵列的定制本地SRAMs现在被设计到SOC中,其唯一目的是执行AI模型数学,即矩阵/张量数学。为一系列MAC集成专用的专用本地SRAMs来执行AI模型数学是近内存计算的概念。在近内存计算中,本地SRAMs针对存储其指定MAC单元所需的权重和激活进行了优化。
开发内存计算下一个自然进展是模拟计算。模拟计算实现了额外的并行性,并更接近地模拟了人脑的效率。对于模拟系统,MAC和内存是并行的,比单独的近内存计算进一步提高了系统效率。传统SRAMs可以作为内存模拟计算实施的基础,Synopsys为此提供了定制服务。
内存技术应对内存计算挑战
诸如MRAM、ReRAM等新的存储器技术是有前途的,因为与传统的SRAMs相比,它们提供了更高的密度和非易失性。对SRAMs的改进可以提高片上计算和存储器的利用率。利用率是AI SoC设计师面临的最关键的设计挑战之一(图2)。无论使用何种技术,SoC设计人员都需要专门为AI数据移动和计算设计的内存子系统。
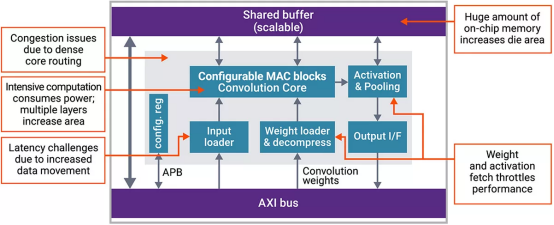
图2,AI SOC具有极其密集的计算和数据移动,这会影响延迟、面积和性能。
具有存储系统的AI SoC设计的关键挑战与需要存储的MAC和系数的数量有关。对于ResNet-50来说,需要超过2300万个权重,这相当于35亿次MAC和105亿次内存访问。不是所有的都同时运行,所以最大激活的大小可能是内存子系统的关键瓶颈。控制工程师知道,效率是通过将瓶颈设计在最昂贵的执行功能上来实现的。因此,设计需要确保内存计算架构能够有效处理最大层的激活系数。
满足这些要求需要大量的片上存储器和多层的密集计算。正在开发存储器设计中的独特技术,以消除延迟,消除系数的大小,并消除必须在SoC中移动的数据量。
结论
业界采用内存计算的速度有多快还有待观察;然而,这项技术的承诺、新存储器概念的实现、创新电路和创造性设计师,将肯定是一个令人兴奋的工程成就。探索解决方案的过程有时和最终结果一样有趣。
原文链接:
https://www.synopsys.com/designware-ip/technical-bulletin/in-memory-computing-ai.html
