在当前的技术时代,我们知道 AI ML 就像空气一样无处不在,数据是其中的命脉。但是,从行数据到 ML 训练数据的阶段不仅具有挑战性,而且非常耗时。有时我们没有足够的数据,有时我们为特定目的训练 ML 模型,而其他人已经训练得更好。在那一刻,如果我们可以利用预先训练的模型,对其进行微调,并使其预测满足我们业务需求的结果,那会怎样呢?
迁移学习是机器学习中的一项强大技术,它使我们能够用更少的数据和计算来构建准确的模型。通过利用来自预训练模型的知识,我们可以快速使它们适应新的任务和领域,并以最小的努力实现最先进的性能。因此,在本文中,我们将探索革命性的迁移学习、有效性和真实示例。
它是如何工作的
迁移学习是使用先前训练过的模型来增强新模型在特定任务上的成功的过程。迁移学习从一个预先训练好的模型开始,该模型已经从大量数据中学习了一般特征和模式,而不是从一个大型数据集开始训练模型。
然后使用更集中的数据集对预先训练的模型进行调整。这使得模型能够在保留它在训练前获得的一般信息的同时,拾取特定于任务的特征。这有助于避免过度拟合,深度学习中经常出现的问题,以及节省时间和资源。
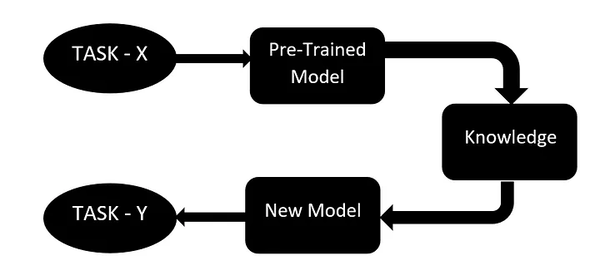
我们可以利用的方式:一步一步的开发人员指南
在本节中,我们将探索一个真实世界的示例,以了解如何利用预训练的模型并设计特定的用例。我以当前一个流行的ML突发新闻为例,即GPT-3,从中我们可以看到,如何在GPT-3之上训练可靠的NLP模型。这将是迁移学习的一个令人困扰的例子。所以,让我们看一步一步公会。
步骤1:选择一个预先训练好的模型
利用迁移学习的第一步是选择与您的特定用例相关的预训练模型。在本例中,我们将使用OpenAI的GPT-3模型,该模型已经在大量文本数据上进行了预训练。
步骤2:对预训练的模型进行微调
一旦你选择了一个预先训练好的模型,下一步就是根据你的特定任务对它进行微调。这包括在特定于任务的较小数据集上训练模型,以便它能够更有效地执行任务。例如,如果您希望使用GPT-3进行文本分类,则需要对标记文本数据集上的模型进行微调。
步骤3:评估经过微调的模型
在对预训练的模型进行微调之后,评估它在特定任务中的表现是很重要的。这包括在已有数据集上测试模型,并测量其准确性和其他性能指标。
步骤4:部署经过微调的模型
一旦您对您的微调模型的性能感到满意,您就可以将其部署到生产环境中,并使用它对新数据进行预测。在GPT-3的情况下,这可能涉及使用模型根据给定的提示或输入生成文本。
通过以这种方式利用迁移学习,您可以显著减少从头开始训练模型所需的数据量和计算资源,同时在特定任务上仍然实现最先进的性能。
龙头企业的现实世界设置
1.Google 的 BERT (Bidirectional Encoder Representations from Transformers) 模型:
它已经在大量文本数据上进行了预训练,用于各种自然语言处理 (NLP) 任务,例如问答、文本分类和命名实体识别。
2.微软的 Seeing AI 应用程序:
它使用迁移学习来识别图像中的物体、人物和文本,让有视觉障碍的人也能使用它。
3.Facebook 的 DeepFace:
它使用预训练的卷积神经网络 (CNN) 进行面部识别任务,例如识别照片和视频中的人脸。
4.OpenAI的GPT-3(Generative Pre-trained Transformer 3)模型:
在海量文本数据上进行了预训练,可以针对语言翻译、摘要、问答等各种语言任务进行微调。
5.特斯拉的 Autopilot:
它使用迁移学习,通过利用特斯拉汽车行驶数百万英里的数据来提高其自动驾驶能力。
因此,通过这种方式,迁移学习正在彻底改变 ML 的发展,从而导致更快的行业增长。
