摘要
AI任务涵盖了广泛的领域,虽然已经设计了许多针对特定任务和应用的AI模型,但在找到合适的模型架构、优化算法和超参数方面,它们通常需要相当大的人力投入。近年来,像ChatGPT这样的大型语言模型(LLMs)在推理、理解和交互的各个方面展示了卓越的能力。因此,我们提出了开发面向任务的提示并自动利用LLMs自动化训练流程的建议。为了实现这一概念,我们提出了AutoML-GPT,它将GPT作为连接各种AI模型的桥梁,并动态使用优化的超参数来训练模型。AutoML-GPT从模型和数据卡中动态获取用户请求,并组成相应的提示段落。最终,利用这个提示段落,AutoML-GPT将自动进行从数据处理到模型架构、超参数调优和预测训练日志的实验。通过利用AutoML-GPT强大的语言能力和现有的AI模型,AutoML-GPT可以处理各种复杂的AI任务和数据集。这种方法在计算机视觉、自然语言处理和其他具有挑战性的领域取得了显著的结果。广泛的实验和消融研究表明,我们的方法对许多AI任务具有普适性、有效性和益处。
1 引言
人工智能(AI)近年来取得了显著的进展。其中,ChatGPT [OpenAI, 2023]由于其推理、理解和交互能力而受到特别关注。基于指令执行新任务的能力是实现人工通用智能的关键步骤,大型语言模型(LLMs)的卓越能力推动了许多新兴的研究课题,如上下文学习、思维链提示、检索和阅读和基于GPT的智能系统。这些领域旨在探索LLMs的巨大潜力,并为构建复杂的AI系统提供了无限的机会。
然而,LLMs(如GPT-4 ,LLaMA ,Flan-T5和PaLM)已经展示了对自然语言的深入理解和产生连贯、上下文适当的回应的能力。这一进展为涉及不同领域数据的具有挑战性的任务打开了新的潜在应用,例如图像和文本处理以及领域特定知识的整合。在这个背景下,LLMs发挥着关键作用,因为它们理解和生成自然语言的能力使得AI能够更好地理解和解决各种挑战。
本文旨在开发一个名为AutoML-GPT的自动机器学习(AutoML)系统,利用LLMs在具有用户输入和描述的数据集上自动训练模型。LLMs被用作自动训练系统,与多功能模型建立连接并处理输入。我们建议使用语言作为LLMs与用户交互的通用界面和提示,通过将数据和模型描述结合到提示中,LLMs可以管理数据处理、模型架构设计和超参数调优的AI模型。它们可以根据需要调用这些模型来解决AI任务并返回预测的训练日志。然而,将多个AI模型整合到LLMs中需要大量高质量的模型描述。为了克服这一挑战,我们建议利用模型卡片提供的定义明确的模型描述和特定AI任务的数据卡片。这种方法将使我们能够通过基于语言的界面连接不同的模型,从而便于解决复杂的AI任务,它还可以通过捕捉它们的相似性来增强模型和数据集之间的可迁移性。
AutoML-GPT将多功能机器学习模型、训练流程和数据集连接起来,以解决许多复杂的AI任务。更具体地说,对于我们要解决的每个AI任务,我们使用其对应的描述(如模型卡片和数据卡片),将段落作为提示融入预训练的LLMs(如ChatGPT)中,建立AutoML流程。然后,在我们的系统中,LLMs执行自动训练,为用户的输入问题返回预测的训练日志。根据这些训练日志,我们可以进一步与LLM进行交互,解决请求(如超参数调优),如图1所示。因此,AutoML-GPT的整个过程可以分为四个阶段:
1)数据处理,
2)模型架构设计,
3)使用预测的训练日志进行超参数调优,
4)对实验数据的人工反馈。
由于这样的设计,图1中的AutoML-GPT能够使用外部模型,因此可以在众所周知的基准测试上处理多个任务,并在只提供元数据(数据卡片)的情况下将知识转移到未知的私有数据集上。此外,这个流程还使得AutoML-GPT能够不断吸收来自任务特定专家的力量,实现可扩展的AI能力。总之,我们的贡献如下:
• 为了补充大型语言模型和专家模型的优势,我们提出了AutoML-GPT作为数据处理和模型架构设计的系统,并自动为每个特定任务进行实验。
• 通过将模型卡片与模型描述和数据卡片与数据描述进行整合,我们提供了一个固定格式的提示段落,并建立了一个训练流程来解决通用的AI任务。
• 在跨语言、视觉和持续学习等多个AI任务上进行了广泛的评估,证明了AutoML-GPT在自动训练方面的能力。它进一步证明了为未知或新数据集提供超参数调优的有效性。
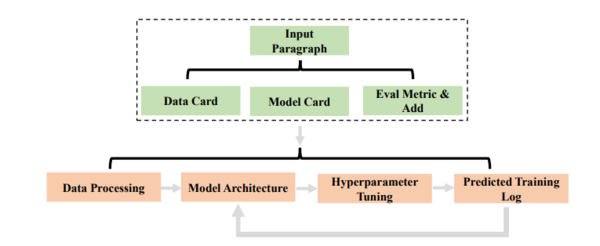
图1:AutoML-GPT概述。一些符号标注在相应的组件旁边。 "Eval Metrics & Add"指的是评估指标和额外请求。
2 AutoML-GPT
AutoML-GPT是一个协作系统,依靠数据和模型信息来格式化提示输入段落。LLM充当控制器,而许多专家模型充当协作执行者。 AutoML-GPT的工作流程包括四个阶段:数据处理、模型架构设计、超参数调优和训练日志生成。具体而言,我们为AutoML-GPT提出了一个通用的流程:
1)使用模型卡片和数据卡片生成一个固定格式的提示段落,
2)构建训练流程,并处理用户对选定数据集和模型架构的请求,
3)生成性能训练日志并调优超参数,
4)使用自动建议的超参数对模型进行调优。
2.1 输入分解
在AutoML-GPT的第一个阶段,LLM接收用户的输入。为了提高LLM的性能并生成有效的提示,我们对输入提示使用特定的指令。指令包含以下三个部分的描述。
数据卡片:为了明确数据集的预期用途并将其在不适合的情境中的使用最小化,我们使用数据卡片为该数据集提供全面的文档。如图2所示,数据卡片的关键组成部分包括数据集名称、输入数据类型(如图像数据或文本数据)、标签空间(如类别类型或分辨率)和默认评估指标。
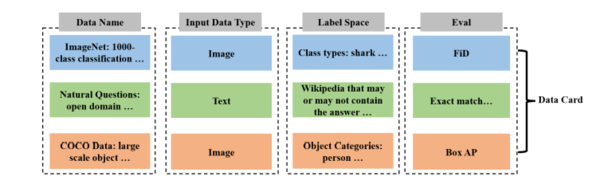
图2:数据卡片包括数据名称、输入数据类型、标签空间和评估指标。在数据卡片中,相同的颜色表示来自单个数据集的信息。
模型卡片:模型卡片作为前面所讨论的“数据卡片”的补充,是报告用于训练和测试数据集的模型详细信息的一种提议范式之一。模型卡片包括模型名称、模型结构(例如,使用Swin Transformer 和UperNet 头部的结构)、模型描述和架构超参数。通过提供这些信息,模型卡片向LLM提供有关所使用的机器学习系统以及用户在模型架构上希望拥有的灵活性程度的信息,这将进一步与LLM创建更加包容性的结果。
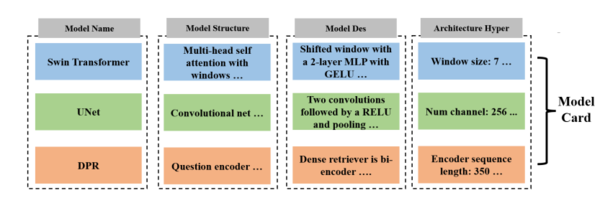
图3:模型卡片包括模型名称、模型结构、模型描述和架构超参数。在模型卡片中,相同的颜色表示来自单个模型卡片的信息。
评估指标和额外请求:除了模型卡片和数据卡片外,用户还可以选择请求更多的评估基准、指标或任何约束。除了默认的评估指标外,在选择模型架构时,我们可以根据用户的请求添加特定的指标或约束。例如,给定一个约束条件“推断时间小于10 FPS”,然后我们在评估指标和约束条件下处理用户的请求。通过这些评估指标和额外请求的指令和人类反馈,LLM可以更好地遵循指令。
AutoML-GPT将这些任务规范作为高级指令提供给LLM,以便根据用户的请求进行分析。
2.2 数据处理
数据处理是机器学习中的一个关键步骤,因为数据的质量和从中派生的有用信息直接影响模型的学习能力。因此,在将数据输入模型之前,我们对数据进行处理是至关重要的。例如,在计算机视觉中,数据处理指的是用于为分析或机器学习算法准备原始图像数据的一系列技术和方法。这可能包括图像的调整大小、归一化、增强和滤波。类似地,在自然语言处理(NLP)项目中,数据处理是将原始文本数据转换为结构化和干净的格式,以便机器学习算法能够轻松理解和处理的过程。常用的技术包括分词、停用词移除、转换为小写字母、去除特殊字符和数字等。根据提供的数据卡片和数据描述,AutoML-GPT根据项目的要求和数据的特性提供具体的处理技术。
2.3 模型架构
在处理任务列表时,AutoML-GPT需要将每个任务与相应的模型匹配,从列表中选择适合每个任务的合适模型。为了实现这一点,我们首先从用户输入中获取模型卡片和模型描述。然后,我们使用上下文任务-模型分配机制动态地将模型分配给任务。这种方法通过结合提供模型描述和对用户请求的更好理解,实现了增量模型访问,并提供了更大的开放性和灵活性。
模型架构是指机器学习模型设计、结构和组件的详细解释。这些描述通常包括以下元素:输入和输出层、隐藏层、激活函数、损失函数和模型特定组件(例如注意力机制、卷积层或循环层)。
2.4 使用预测的训练日志进行超参数调优
在机器学习中,超参数调优是寻找给定模型在特定数据集上性能最佳的超参数组合的关键步骤。超参数是在训练过程中不会学习的配置设置,而是预定义的,用于控制模型学习行为的各个方面。常见的超参数示例包括学习率、批量大小、隐藏层数量和每层神经元数量。
为了在没有在真实机器上进行训练的情况下调整超参数,我们通过为提供的数据卡片和模型卡片生成一个给定超参数设置的训练日志来预测性能。AutoML-GPT将自动进行训练并返回训练日志。模型在数据集上的训练日志记录了训练过程中收集的各种指标和信息。它有助于了解模型的进展,识别潜在问题,并评估所选架构、超参数和优化技术的有效性。典型的训练日志包括训练和验证指标的时期数。通过检查训练日志,我们可以根据用户的反馈形成对模型性能的基本理解。
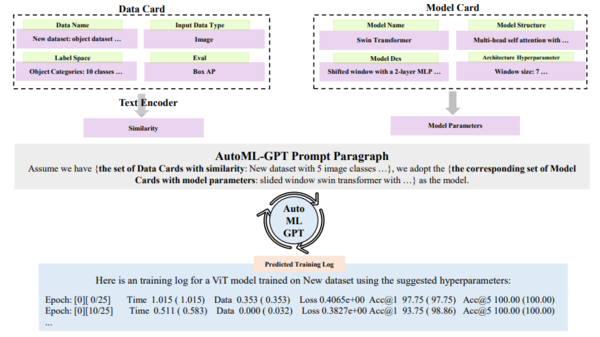
图4: AutoML-GPT针对未知数据集的概述:顶部块展示了数据卡片和模型信息。
我们首先记录了几个数据集的训练信息。这些数据集的数据卡片经过文本编码器处理,以获取相似度分数,然后将这些分数与相应训练模型的模型参数相结合,形成AutoML-GPT的提示段落。底部块展示了基于推荐的超参数设置对未知数据集的预测训练日志。
未知数据集:对于未知的私有数据集进行超参数调优可能更具挑战性。根据未知数据集的元数据,AutoML-GPT可以推荐适用于该数据集的超参数配置。我们依靠数据卡片来利用必要的文本描述,并确定未知数据集与现有数据集之间的相关性。基于相关性,我们将现有数据集的超参数设置转移到新的未知数据集上。
为了计算相关性,我们使用文本编码器对数据卡片进行编码。具体而言,在数据卡片中,包含了诸如类别类型、分辨率、图像大小和其他相关元数据的信息。我们将数据集规模、任务描述、标签空间以及输入/输出数据类型作为文本编码器(例如CLIP [Radford et al., 2021])的输入,并使用编码的潜在表示的相似度分数描述该未知数据集与现有数据集之间的相关性。
3 实验
我们评估了我们的AutoML-GPT并使用ChatGPT(OpenAI的“GPT-4”版本)进行实现。我们进行了各种案例研究,以从多个角度展示我们方法的有效性。
3.1 未见过的数据集
在图4中,我们展示了使用AutoML-GPT在未见过的数据集上进行训练的结果。为了验证在实际情况下的性能,我们构建了一组在已经训练的数据集上的性能和超参数,并且一些未训练的数据集即将到来。我们将预测这些未训练数据集的超参数配置。我们的测试环境基于Vinyals等人描述的分类设置。我们还按照MiniImageNet 对训练数据集进行了子采样和切分,分为80%和20%的部分。从80%的数据中,我们构建了数据卡片和相应的模型卡片(包含模型的最佳超参数)。我们随机选择了十五个类别,创建了各种子集数据集(例如,数据集A,B等),对超参数进行了网格搜索,微调了ViT基准模型并记录了这些子集数据集上的最佳性能。然后,我们使用剩余20%的数据创建了一个名为“New”的新数据集,其中包含十个图像类别。
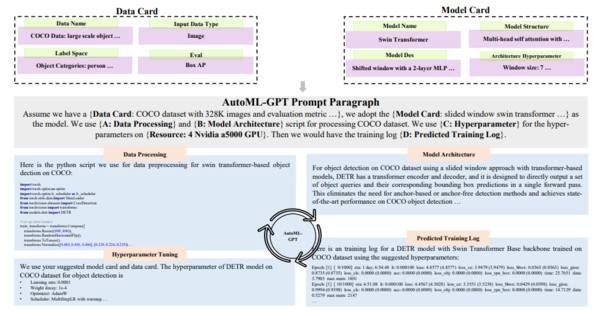
图5:AutoML-GPT目标检测的概述:顶部块显示数据卡和模型卡。
中间块展示了从数据卡和模型卡派生出的AutoML-GPT提示段落。底部块概述了四个步骤:数据处理、模型架构、超参数调整和预测的训练日志。我们使用预测的训练日志来调整超参数,然后将超参数反馈给用户。
为了展示我们的方法在未知数据集上的能力,我们利用AutoML-GPT根据提供的数据卡和模型卡为“新”数据集推荐最佳训练配置。
在我们的数据卡中,我们记录了标签空间,即每个类别的文本描述。在实践中,我们通过将数据卡中的文本通过文本编码器(例如CLIP文本编码器)进行编码,并计算相似度,来衡量两个数据卡之间的相似度。具体来说,在图4中,我们指出“新”数据集与数据集A的标签空间相似度为60%,与数据集B的标签空间相似度为40%。利用这些信息以及数据卡中的超参数设置(数据集A和B的设置),AutoML-GPT可以为“新”数据集的训练推荐适当的超参数设置。在我们的实验中,与平均随机选择的超参数的80% Top 1准确率相比,我们实现了98%的Top 1预测准确率。此外,我们还使用AutoML-GPT推荐的超参数设置初始化模型,而不提供任何额外的数据集。使用这个配置,我们实现了82%的Top 1准确率,这比平均随机选择的超参数要好,但不如我们推荐的设置。这也表明ChatGPT可以为特定任务(例如图像分类)提供良好的超参数设置。这证明了我们提出的自动训练方法在解决机器学习问题方面的有效性,即使是对于未知或新的数据集。这些发现突显了我们的自动训练方法提供准确的超参数推荐来增强机器学习的潜力。
3.2 目标检测
图5展示了我们在COCO数据集[Lin et al., 2014]上进行目标检测的结果。➀ 顶部块显示了COCO数据集的数据卡和基于用户输入的ImageNet模型卡。中间块展示了从输入分解中得出的AutoML-GPT提示段落。数据卡和模型卡的信息被自动合并到我们的提示格式中。我们报告了数据处理、模型架构设计、超参数调整和训练日志生成的结果。➁ 在数据处理阶段,AutoML-GPT生成一个处理输入数据集的脚本。我们在图5中也提供了一个Python脚本示例。对于模型架构设计,我们的流程生成了一个用于后续训练的模型组合。一旦数据和模型准备好,详细的配置信息将在超参数调整阶段提供(例如学习率:10^(-4),权重衰减:10^(-4)),并通过预测的训练日志进行进一步调整。➂ 这些结果进一步验证了我们的方法可以作为将语言模型灵活适应下游任务的有效流水线。我们的方法利用数据卡和模型卡来生成AutoML-GPT的提示段落,也可以作为专注于增强语言模型提示组件的工作的补充模块。
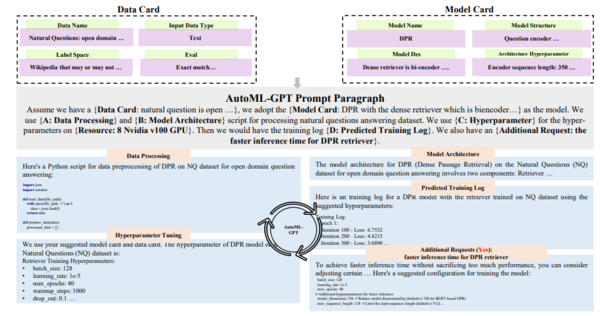
图 6: AutoML-GPT在问答任务中的概述:顶部块展示了数据卡和模型信息,而中间块突出显示了由数据卡和模型卡派生出的AutoML-GPT提示段落。底部块详细说明了四个步骤:数据处理、模型架构、超参数调整和预测的训练日志。
3.3 问答任务
我们在Natural Questions Open数据集上展示了实验结果,如图6所示。我们使用了Dense Passage Retrieval (DPR) 。
① 对于数据卡,用户输入数据名称、输入数据类型、标签空间和评估指标。
② 对于模型卡,包括模型名称、模型结构、模型描述和架构超参数。
③ 使用生成的AutoML-GPT提示段落,AutoML-GPT进行数据处理、模型架构创建、超参数调整,并生成预测的训练日志。如“超参数调整”所示,AutoML-GPT生成的超参数与DPR提供的超参数非常接近,例如学习率为10^(-5),最大迭代轮数为40。
④ 一旦获得预测的训练日志,我们展示了一个场景,用户可以根据需求向AutoML-GPT询问不同的评估指标或模型架构,如图6中的“附加请求:DPR检索器快速推断时间”。
如图6中的返回响应所示,AutoML-GPT还提供了一些提示,比如“在不牺牲太多性能的情况下”。AutoML-GPT根据这些请求和预测日志进一步调整超参数。我们的方法展示了自动进行实验和交互式超参数调整的强大能力。它进一步证实了我们的方法在各种数据集上都能良好工作,并且可以在不同的输入类型和领域中推广应用。
3.4 分类任务
我们还在UCI Adult数据集上使用XGBoost评估了AutoML-GPT。与之前一样,我们提供数据卡和模型卡来生成输入的提示段落。如图7所示,同样的训练流程被应用在这里。我们也遵循AutoML-GPT建议的超参数设置,并训练XGBoost模型。这次训练结果是最终的验证损失为0.277,准确率为85.92%。尽管输入和任务不同,我们提出的AutoML-GPT在分类任务中始终表现出较强的性能。这进一步证明了AutoML-GPT可以应用于各种任务的机器学习问题中。
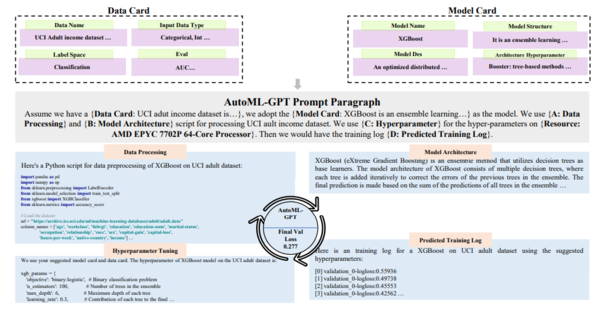
图7: AutoML-GPT在分类任务中的概述:顶部块展示了数据卡和模型信息,中间块展示了由数据卡和模型卡派生出的AutoML-GPT提示段落。底部块概述了四个步骤:数据处理、模型架构、超参数调整和预测的训练日志。此外,我们还包括了最终的验证结果,根据AutoML-GPT的超参数建议进行模型训练。
4 相关工作
先进的大型语言模型(LLMs)通过拥有超过一千亿参数规模的零样本学习和少样本学习展示了其稳健性和泛化能力。其中值得注意的LLMs包括参数规模为5300亿的Megatron-turing NLG ,参数规模为2800亿的Gopher,以及参数规模为5400亿的PaLM 。LLM的扩展解锁了在较小模型下之前未观察到的新的突现能力。这些LLMs展示了LLMs在零样本学习方面的优越性。在现有的LLMs中,ChatGPT具有独特的特点。它具有与用户以对话方式进行交互的能力,同时保留了从预训练中获得的累积知识和泛化能力。在本文中,我们进一步探索了ChatGPT在对话以外的不同任务上的零样本学习能力。
- 思维链思维链CoT
CoT提示促使LLMs在回答之前生成中间推理步骤。有两个研究方向专注于当前的CoT提示。一条线是探索手动设计的CoT。在手动设计的CoT中,LLMs根据推理过程的手动设计特征和演示进行调整 。Wang等人提出了一种新的解码策略,即自一致性,用于取代链式思维提示中使用的贪婪解码策略。最近,引入了交互式链式提示(Interactive-Chain-Prompting)来解决跨语言条件生成的歧义问题。另一条线是在零样本设置下进行研究,其中引入了STaR 用于自动生成并帮助模型自我改进,以及Automatic Reasoning and Tool-use (ART) ,这是一个使用冻结的LLMs自动生成中间推理步骤作为程序的框架。
- 基于GPT的系统
GPT显示出了令人期待的性能提升。最近的一系列研究专注于将GPT模型整合到AI系统中。HuggingGPT是使用HuggingFace transformers库构建的,利用GPT作为交互代理。VisualGPT 结合了不同的视觉基础模型,使用户能够与ChatGPT进行交互。OpenAGI是一个开源的AGI(通用人工智能)研究平台,旨在提供复杂的多步任务,并配备专门的任务数据集。类似地,我们也将GPT集成到了我们的AutoML流程中。还有另一个基于GPT的系统可以整合来自搜索引擎的额外信息,例如AutoGPT 2。AutoML-GPT从自动训练的角度重新思考了ChatGPT的影响。我们专注于从头到尾构建训练流程和建立一个AutoML系统。
5 结论
我们的工作展示了在GPT基础上构建AutoML系统的好处,所提出的方法可以自动进行机器学习实验,这种自动学习极大地提高了训练效率并增强了模型的性能。我们展示了在计算机视觉、自然问答和分类基准测试中的应用案例。我们还进行了一个详细的用例,涉及到未见过的数据集和用户与AutoML-GPT之间的额外交互。总而言之,所提出的AutoML-GPT方法是有效且通用的,具有为各种任务调整机器学习模型的潜力。在未来,我们将: 1) 自动为知名基准测试生成模型和数据卡,并使其成为我们系统的一部分,以及 2) 借助ChatGPT从大型预训练模型中提取任务感知的子网络。
