Meta 构建了 AI 模型,可以识别和生成 1,000 多种语言的语音——是目前可用语言的十倍。Meta公司表示,这是朝着保护面临消失风险的语言迈出的重要一步。
Meta 通过代码托管服务 GitHub 向公众发布其模型,它声称将它们开源将有助于使用不同语言工作的开发人员构建新的语音应用程序——例如可以理解每个人的消息服务,或者可以在任何语言中使用的虚拟现实系统。
世界上大约有 7000 种语言,但现有的语音识别模型只能全面涵盖其中的大约 100 种。这是因为这类模型往往需要大量带标签的训练数据,而这些数据仅适用于少数语言,包括英语、西班牙语和中文。
Meta 研究人员通过重新训练该公司在 2020 年开发的现有 AI 模型解决了这个问题,该模型能够从音频中学习语音模式,而无需大量标记数据(例如转录本)。
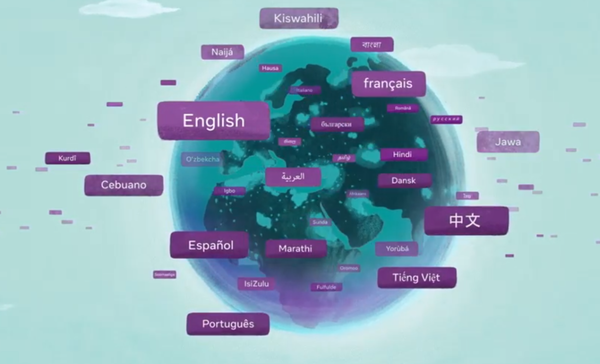
他们在两个新数据集上对其进行了训练:一个包含新约圣经的录音及其从互联网上以 1,107 种语言获取的相应文本,另一个包含 3,809 种语言的未标记新约录音。该团队处理语音音频和文本数据以提高其质量,然后运行旨在将录音与伴随文本对齐的算法。然后,他们用在新对齐数据上训练的第二种算法重复这个过程。通过这种方法,研究人员能够教算法更轻松地学习一门新语言,即使没有附带的文本也是如此。
“我们可以利用该模型学到的知识,然后用非常非常少的数据快速构建语音系统,”从事该项目的 Meta 研究科学家 Michael Auli 说。
“对于英语,我们有很多很好的数据集,我们有更多语言的数据集,但我们只是没有那些被 1000 人使用的语言的数据集。”
研究人员表示,他们的模型可以用 1,000 多种语言进行交流,但能够识别 4,000 多种语言。
他们将这些模型与竞争对手公司(包括 OpenAI Whisper)的模型进行了比较,并声称他们的错误率只有一半,尽管覆盖的语言是后者的 11 倍。
然而,该团队警告说,该模型仍然存在错误转录某些单词或短语的风险,这可能导致不准确或可能令人反感的标签。他们还承认,他们的语音识别模型比其他模型产生了更多有偏见的词,尽管只多出 0.7%。
Masakhane 的研究员 Chris Emezue 说,虽然研究的范围令人印象深刻,但使用宗教文本来训练 AI 模型可能会引起争议,该组织致力于非洲语言的自然语言处理,他没有参与该项目。“圣经有很多偏见和误传,”他最后说。
