视觉转换器(ViTs)是一种强大的人工智能技术,可以识别或分类图像中的对象,但是,计算能力和决策透明度方面存在重大挑战。研究人员现已开发出一种新的方法来解决这两个挑战,同时还提高了ViT在识别、分类和分段图像中的对象的能力。
变形金刚是现有最强大的人工智能模型之一。例如,ChatGPT是一种使用变形金刚架构的人工智能,但用于训练它的输入是语言。 ViTs是基于变形金刚的人工智能,通过使用视觉输入进行训练。例如,ViTs可以用于检测和分类图像中的物体,例如识别图像中的所有汽车或所有行人。
然而,ViT也面临两个挑战。
首先,变压器模型非常复杂。相对于输入到人工智能的数据量,变压器模型需要大量的计算能力和大量的内存。这对于 ViTs 来说尤其令人担忧,因为图像包含大量的数据。
其次,用户很难理解 ViTs 确切的决策流程。例如,您可能已经训练了一个 ViT 以在图像中识别狗。但是,ViT 确定什么是狗和什么不是狗的方法并不完全清楚。根据应用程序,理解 ViT 的决策过程,也称为其模型可解释性,可以非常重要。
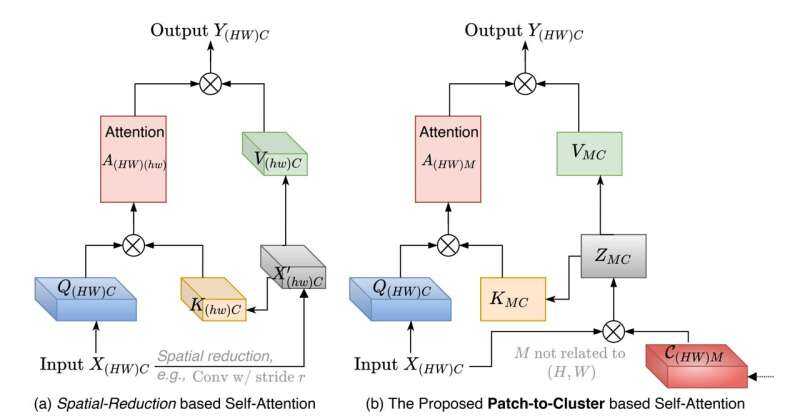
新的ViT方法学名为“Patch-to-Cluster attention”(PaCa),旨在解决这两个挑战。
“我们通过使用聚类技术来解决与计算和内存需求相关的挑战,这使得变压器架构能够更好地识别和聚焦于图像中的对象,”来自北卡罗来纳州立大学电气与计算机工程系副教授和该研究论文的通讯作者吴天赋说道。
聚类是指人工智能根据在图像数据中找到的相似性将图像的部分分组。这显著降低了系统的计算需求。在进行聚类之前,ViT的计算需求是二次的。例如,如果系统将图像拆分为100个较小的单元,则需要比较所有100个单元彼此之间的相似性,这将需要进行10,000个复杂函数。
“通过聚类,我们能够使这成为一个线性过程,每个较小的单元只需要与预定数量的聚类进行比较。假设你告诉系统建立10个聚类;那只需要1,000个复杂函数,”吴说道。
“聚类还允许我们解释模型,因为我们可以看看它在第一时间如何创建聚类。它决定将哪些数据段归为一类时认为哪些特征是重要的?而且由于AI只创建了一小部分聚类,我们可以相当容易地查看它们。”
研究人员对PaCa进行了全面的测试,并将其与两种最先进的ViT——SWin和PVT进行了比较。
吴说:“我们发现,PaCa在各个方面都优于SWin和PVT。PaCa在对图像中的对象进行分类、识别和分割方面表现更好,基本上可以勾勒出图像中对象的边界。它也更加高效,意味着它能够比其他ViT更快地完成这些任务。”
我们的下一步是通过对更大的、基础的数据集进行训练来扩展 PaCa。
论文 "PaCa-ViT: 学习在视觉转换器中的补丁到聚类注意力" 将在2022年6月18日至22日在加拿大温哥华举行的IEEE/CVF计算机视觉和模式识别会议上发表。
