来自UCLA和美国陆军研究实验室的研究人员提出了一种新的方法,通过将基于物理学的意识添加到数据驱动技术中,来增强人工智能驱动的计算机视觉技术。
这项研究发表于《自然·机器智能》杂志,提供了一个混合方法的概述,旨在改进基于人工智能的机器在实时环境中感应、交互和响应的能力——如自主车辆的移动和操纵,以及机器人使用改进技术进行精密操作的能力。
计算机视觉通过解码数据并从图像推断物理世界的属性,使AI能够看到并理解其环境。尽管这些图像是通过光学和机械原理生成的,传统的计算机视觉技术主要集中在数据驱动的机器学习上以提高性能。物理学基础研究走的是另一条路,探索了许多计算机视觉挑战背后的各种物理原理。
在神经网络的发展中,把物理学——管控质量、运动等规律——融入其中一直是个挑战,因为AI是模仿人脑并利用数十亿的节点去解析趋近于无限的图像数据集,直到它们理解所“看见”的东西。但如今已有不少有前途的研究方向,旨在将对物理的认知元素注入已存在的强大数据驱动网络中。
UCLA的研究旨在利用数据的深度知识和物理学的实际经验,创建一种具有增强能力的混合人工智能。
这项研究的对应作者、加州大学洛杉矶分校工程学院的电气和计算机工程助理教授阿丘塔·卡丹比表示:“使用图像感知世界的视觉机器——如汽车、机器人或医疗仪器——最终会在我们的物理世界中执行任务。有物理意识的推理形式可以让汽车更安全地行驶,也可以让外科机器人更精确。”
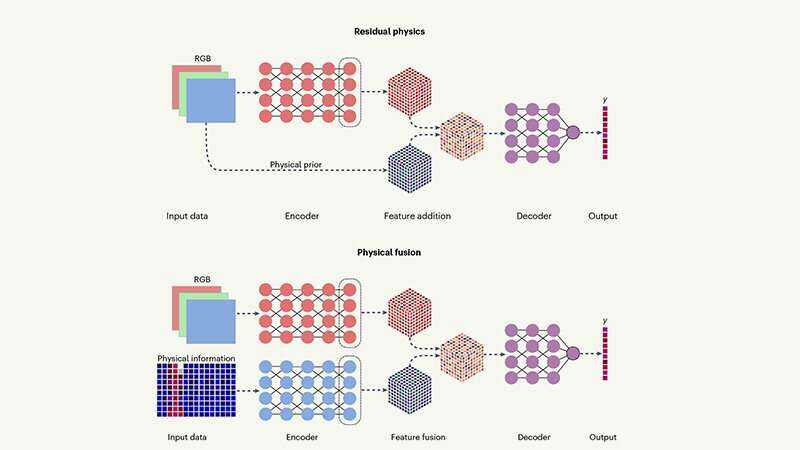
研究团队概述了三种物理学和数据开始与计算机视觉人工智能结合的方式:
这三条研究线已经在改进计算机视觉方面取得了有益的成果。例如,混合方法使得人工智能能够更准确地跟踪和预测物体的运动,并能从恶劣天气遮挡的场景中生成准确、高分辨率的图像。
根据研究人员的说法,随着这种双模态方法的不断进步,基于深度学习的人工智能甚至可能开始自行学习物理定律。
本文的其他作者包括陆军研究实验室计算机科学家Celso de Melo、加州大学洛杉矶分校计算机科学教授Stefano Soatto、计算机科学副教授Cho-Jui Hsieh和电脑工程和计算机科学教授Mani Srivastava。
