大型语言模型正在产生语言污染,这种污染可能会威胁到这些模型所依赖训练数据的本质。
这是一支由英国和加拿大的研究团队所得出的结论,他们探索了连续几代 ChatGPT 生成的文本对未来模型的影响。
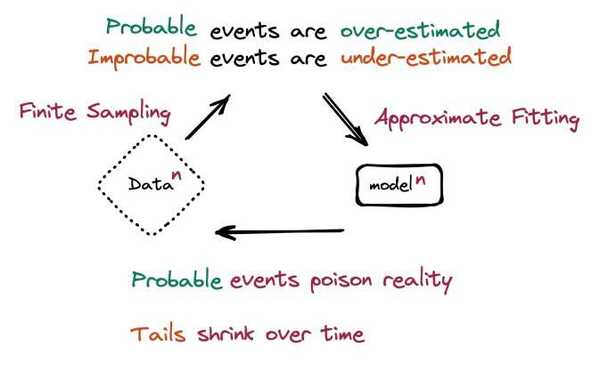
一个题为“递归的诅咒:训练生成数据使模型遗忘”的 arXiv 预印本上发表的论文中,团队预测,人工智能训练中的递归性质最终将导致“模型崩溃”。
团队表示:“我们发现,从其他模型生成的数据进行学习会导致模型崩溃和退化,在此过程中,模型会随着时间的推移忘记真正的基础数据分布。”
剑桥大学和爱丁堡大学的团队成员罗斯·安德森将这种影响比作音乐输出质量的递减。
他在个人博客中表示:“如果你用莫扎特训练音乐模型,你可以期待的输出会有点像莫扎特,但缺乏亮点……而且如果这个版本训练出了下一代,以此类推,第五代或第六代的声音会是什么样子呢?”
作者指出,模型崩溃是一种类似于灾难性遗忘和数据污染的威胁。
在灾难性遗忘中,模型在学习新信息时会"遗忘"以前的数据,有时会突然发生。这种影响随时间的推移而不断加剧。
在他们的新研究中,研究团队表示,模型并不会忘记之前学习的数据,但是会开始错误地解读自己认为是真实的内容,从而加强他们自己的信仰。
数据中毒是恶意插入虚假信息的行为。当然,这种做法早在大型语言模型的使用之前就已经存在了。但是,使用大规模的网络爬虫,即使插入了少量的恶意数据,在团队的说法中,也可能导致广泛的污染。
该团队表示,大型语言模型的到来所不同的是,一旦自动化,这种毒化行为可能在更大规模上发生。
牛津大学的研究员伊利亚·舒迈洛夫警告说,“即使保留了一些原始数据,在几次迭代中就会发生重大的退化。”
“由于优化不完美、模型有限和数据有限,导致合成数据的质量较低。”他继续说道,“随着时间的推移,错误会不断累积,最终迫使从生成的数据中学习的模型进一步错误地感知现实。”
研究者表示,递归学习的本质是放弃低概率事件,统计学家称之为“分布的尾部”。
安德森在他的博客中警告说:"在训练中使用模型生成的内容会引起不可逆转的缺陷。原始内容分布的尾巴会消失。放置几代后,文本变成垃圾。"
该报告指出:“了解复杂系统,低概率事件至关重要。”
最初的大型语言模型是基于人类生成的文本进行训练的。但随着ChatGPT在行业和普通用户中的快速普及,大量的数据正在填充在线网站。
研究人员敦促采取措施,区分人工智能生成的内容和人类生成的内容,并努力保留原始内容以供未来的训练目的。
“大型语言模型就像火一样,”团队成员安德森说,“它是一个有用的工具,但也是一个污染环境的工具。我们将如何应对?”
