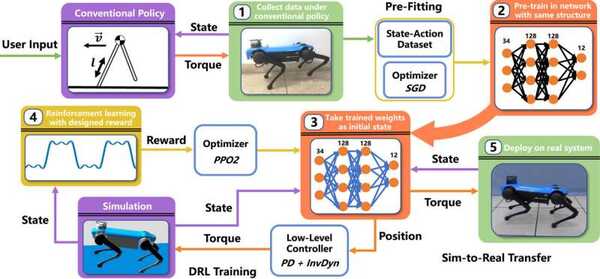
在《IET Cyber-Systems and Robotics》期刊的专辑中发表的一项研究中,来自浙江大学的研究人员,他们在四足机器人运动和控制方面经验丰富,使用了传统基于模型的控制器操作的机器人的数据,对神经网络(NN)进行了预训练。
这种预训练作为一种初步措施,旨在防止行为覆盖和奖励欺骗--即代理通过不经意地优化达到局部最优而非预期目标,意外获得奖励的情况。在预训练之后,研究团队实施了深度强化学习(DRL),这是一种在四足动作控制中引领潮流的基于学习的方法。
值得注意的是,设计了一个考虑到接触点和相位的奖励函数,通过强制步态对称性和周期性,得出了更好的跳跃性能。所开发的DRL方法首先在模拟环境中进行学习,然后成功地应用于真实的四足机器人——觉鹰迷你。这种行动方式在室内和室外的各种环境中进行了测试,展示了高效计算和出色的运动结果。对于提升四足机器人在不同室内外环境中的敏捷性和适应性具有巨大意义。
该研究的下一步是将当前方法与环境感知工具(如摄像头或激光雷达系统)进行整合。尽管这些工具在当前研究中没有使用,但它们可以提供更准确的机器人定位和跳跃跨越不同地形的导航。
在该专辑中发表的另一项研究中,研究人员开创性地使用了控制力矩陀螺仪(CMGs)来提高双足机器人在高速操作中的稳定性。双足机器人在各行业中的使用越来越广泛,但它们在速度增加时往往难以保持平衡和抵御干扰。
新开发的CMG辅助策略增强了它们抵抗冲击、快速恢复平衡的能力。仿真结果证实了CMGs在显著提高机器人稳定性方面的有效性。这种对CMGs的创新使用代表了双足机器人领域的一次飞跃,计划进一步整合CMGs以提高高动态运动的现实世界性能。
