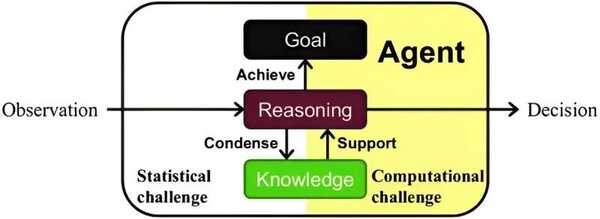
在《智能计算》上发表的一篇新论文中,介绍了强化学习在复杂和动态环境下智能决策中所面临的主要挑战。
强化学习是一种机器学习的类型,代理通过与环境的互动来学习做出决策,并获得奖励或惩罚。
代理的目标是通过确定在不同情况下采取的最佳行动来最大化长期奖励。然而,仅依赖奖励和惩罚的强化学习方法无法成功产生学习、知觉、社交互动、语言、泛化和模仿等智能能力。
现有强化学习方法的一个主要问题是需要通过反复试错来收集的信息量。
与人类可以利用过去的经验来推理和做出更好选择的能力不同,目前的强化学习方法在很大程度上依赖于代理人反复尝试来学习如何执行任务。当处理涉及许多不同因素影响结果的问题时,需要代理人尝试大量示例以找出最佳方法。
如果问题稍微复杂一些,需要的示例数量就会快速增长,使代理人无法高效运作。更糟糕的是,即使代理人拥有确定最佳策略所需的所有信息,找出策略仍然非常困难和耗时。这使得学习过程变得缓慢而低效。
统计效率和计算效率的不足阻碍了从零开始实现通用强化学习的实际性。当前方法缺乏所需的效率,无法在没有大量计算资源的情况下发挥强化学习在开发多样能力方面的全部潜力。
通过观察高价值信息可以克服统计和计算上的挑战。这种信息能够通过观察本身进行策略改进,而无需直接互动。显然,能够从信息丰富的观察中学习对于高效解决复杂的现实任务至关重要。
高价值信息具有两个独特的特征。首先,它不是独立和同分布的,这意味着它涉及复杂的相互作用和依赖关系,与过去的观察不同。要充分理解高价值信息,必须考虑它与过去信息的关系,并承认其历史背景。
高价值信息的第二个特征是其与计算能力感知的代理相关性。具有无限计算资源的代理可能会忽视高级策略,仅依赖基本规则推导出最佳方法。这些代理会忽视更高级的抽象,可能导致不准确,并将计算效率置于准确性之上。
只有意识到计算权衡并能够欣赏计算有益信息的代理,才能有效地利用高价值信息的好处。
为了使强化学习能够高效利用高价值信息,代理必须以新的方式设计。根据他们对智能决策的规范化,即“有限最佳终身强化学习”。
