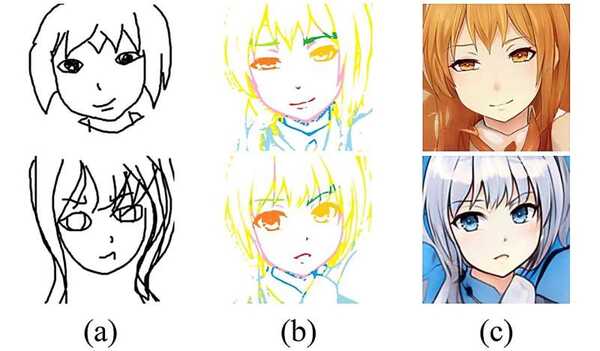
动画,即日本的动画艺术,由手绘的抽象形式组成,具有独特的特点和对现实主题的夸张。虽然生成式人工智能(AI)已被用于动画肖像等内容创作,但其用于增强人类创造力和指导随意画作的使用仍然具有挑战性。
主要挑战在于生成适当的参考图像,以与随意画作过程中产生的不完整和抽象笔画相对应。当在绘画过程中创建的笔画不完整并且提供的信息不足以让生成式AI预测绘画的最终形状时,这一问题尤为明显。
为了解决这个问题,日本高级科学技术学院(JAIST)和日本早稻田大学的一个研究团队试图开发一种新颖的生成式AI工具,该工具提供渐进式的绘画辅助,并帮助从随意素描中生成动画肖像。
该工具基于一个将原始素描与生成模型的潜在向量进行匹配的“sketch-to-image”(S2I)深度学习框架。它采用了一个两阶段的训练策略,通过预训练的Style Generative Adversarial Network(StyleGAN)进行。
研究团队提出了一种名为“stroke-level disentanglement”的新策略,它将随意素描的输入笔画与StyleGAN的潜在结构代码中的边缘相关属性联系起来。
这种方法允许用户操作属性参数,从而对生成的图像属性拥有更大的自主权。在StyleGAN中引入了一种无监督训练策略,用于笔画级别的分离,这使得粗略素描和稀疏笔画可以自动地与动画肖像中的相应局部进行匹配,而无需语义标签。
这项研究将在ACM SIGGRAPH 2023上发布,该会议是计算机图形学和交互技术领域的主要会议,也是全球研究领域唯一的CORE排名 A*会议。
在工具的开发方面,首先使用预训练的StyleGAN模型作为教师编码器,训练了一个图像编码器。在第二阶段,模拟了生成图像的绘画过程,没有额外的数据来训练不完整渐进素描的素描编码器。生成了与教师编码器的分离表示相一致的高质量肖像图像。
为了进一步突出AniFaceDrawing在帮助用户创建动画肖像方面的效果和可用性,团队进行了一项用户研究。他们邀请了15位研究生使用AniFaceDrawing工具绘制数字随意动画风格肖像,可以在线条艺术的粗略和详细引导模式之间切换。
前者为特定面部部位提供提示,而后者则根据用户的绘画进展为整个面部肖像提供提示。参与者可以在与期望匹配后将生成的提示固定,并进一步完善他们的素描输入。该工具还允许参与者选择一个参考图像,以生成其输入素描的彩色肖像。然后,他们通过调查为用户满意度和引导匹配评估了该工具。
团队指出,该系统始终提供高质量的面部引导,并有效支持动画风格肖像的创作,不仅能够提升用户的素描,还能生成理想的对应彩色图像。用户研究表明,即使是新手也可以在该系统的帮助下制作出合理的素描,并得到高质量的彩色艺术作品。
从长远来看,这些发现可以帮助民主化AI技术,协助用户进行创造性任务,并在没有技术障碍的情况下增强其创造能力。
