深度神经网络是生成型人工智能领域取得的许多令人兴奋的进展的主要驱动力。然而,它们的体系结构依赖于一种虚拟的减速器,使得无法实现最大的效率。
神经网络由独立的记忆单元和处理单元构建,这两个组件之间的通信对系统资源要求很高,从而导致速度较慢,效率降低。
IBM研究团队通过借鉴最有效率的数字脑——人脑,提出了一个更高效的数码大脑的新思路。
在一篇名为《基于相变存储器的64核混合信号内存计算芯片用于深度神经网络推断》 的论文中,IBM研究人员在《自然电子学》杂志上表示,他们应用了一种全新的方法来开发一种最先进的混合信号人工智能芯片,承诺提高效率并减少人工智能项目的电池消耗。
研究论文的合著者之一,来自IBM苏黎世研究实验室的Thanos Vasilopoulos表示:“人脑能够在消耗较少能量的情况下实现非凡的性能。”
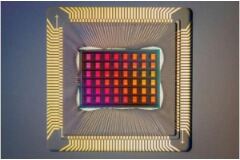
IBM的混合信号芯片与大脑中突触之间相互作用的方式类似,具有64个模拟内存核心,每个核心都有一个包含一系列突触单元的阵列。转换器确保模拟和数字状态之间的平滑过渡。
根据IBM的说法,这些芯片在CIFAR-10数据集上达到了92.81%的准确率,CIFAR-10是一个广泛用于机器学习训练的图像集合。
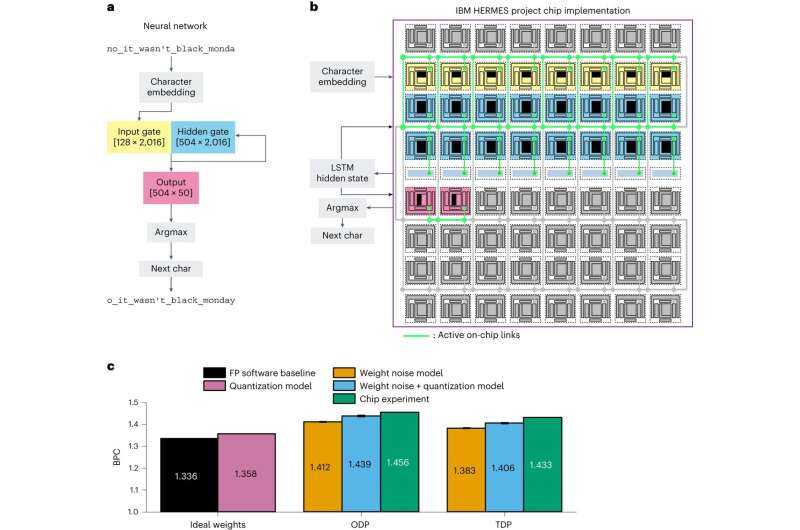
Vasilopoulos表示:“我们展示了使用ResNet和长短期记忆网络具有接近软件等效推断准确性的结果。” ResNet是残差神经网络的缩写,它是一种深度学习模型,可以在神经网络的数千层上进行训练而不影响性能。
他进一步指出:“要在延迟和能耗方面实现端到端的改进,AIMC必须与片上数字操作和片上通信相结合。在这里,我们报道了一款采用14纳米互补金属氧化物半导体技术设计和制造的多核AIMC芯片,该芯片后端集成了相变存储器。”
Vasilopoulos表示,凭借如此出色的性能,“手机、汽车和相机等低功耗或受电池限制的环境中可以执行更大规模和更复杂的工作。”他说:“此外,云服务提供商将能够使用这些芯片来降低能源成本和碳足迹。”。
IBM表示,随着未来数字电路的改进,允许层间激活传输和中间激活存储在本地存储器中,将可以在这些芯片上执行全流水线端到端的推断工作负载。
在他个人的博客上,Vasilopoulos谈到了IBM的最新成就,他说:“通过这项工作,实现了全模拟人工智能所需的许多构件的硅验证,以实现高性能和高能效的人工智能。”
他在一篇名为《模拟内存计算正迈向成熟时代》的独立文章中对芯片进行了技术概述,该文章发表在《电工电子工程》杂志上。
他将该芯片称为“首款完全集成的混合信号内存计算芯片”,并描述其为“基于后端集成的相变存储器(PCM)的14纳米互补金属氧化物半导体(CMOS)工艺。”
在进一步定义该项目时,他说:“该芯片包含64个AIMC核心,每个核心都有一个256x256个单元的存储阵列。单元是由四个PCM设备构成的,总共超过1600万个设备。除了模拟存储阵列外,每个核心还包含一个轻量级的数字处理单元,执行激活函数、累计和缩放操作。”