几十年来,电子工程师一直在努力开发越来越先进的设备,以便能够更快地进行复杂计算且能更节能。在人工智能(AI)和深度学习算法的出现后,这变得更加重要,这些算法通常在数据存储和计算负载方面都有很高的要求。
一种有希望的用于运行这些算法的方法被称为模仿内存计算(AIMC)。顾名思义,这种方法涉及开发能够在单个芯片上进行计算和存储数据的电子设备。为了实现计算速度和能源消耗的双重改进,理想情况下,这种方法还应该支持芯片内数字操作和通信。
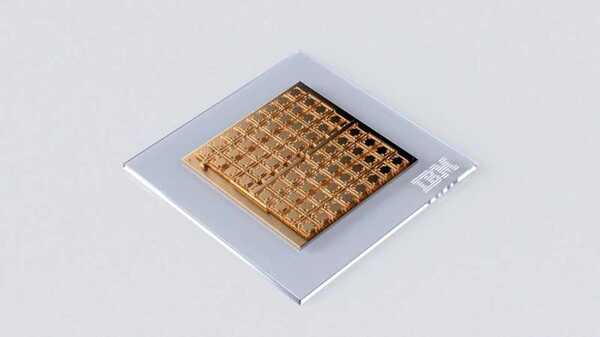
IBM Research Europe的研究人员最近开发出了一款基于相变存储器设备的新型64核模拟内存计算芯片,这款芯片能更好地支持深度神经网络的计算。他们在Nature Electronics上发表的论文中介绍了这款64核芯片,迄今为止已取得非常有希望的结果,保持了深度学习算法的准确性,同时缩短了计算时间和能源消耗。
我们已经研究如何使用相变存储器(PCM)设备进行计算已经有7年多了,从我们最早展示如何使用单个PCM设备实现神经元功能开始。
从那时起,我们表明许多应用程序可以从使用PCM设备作为计算元素中受益,例如科学计算和深度神经网络推断,对于后者使用原型PCM芯片进行硬件/软件实现时,我们证明了几乎没有准确性损失。通过这款新芯片,我们希望迈进一步,实现端到端的模拟AI推断加速器芯片。
为了创建他们的新型内存计算芯片,Le Gallo和他的同事将基于PCM的核心与数字计算处理器相结合,通过芯片上的数字通信网络连接所有核心和数字处理单元。他们的芯片由64个模拟PCM核心组成,每个核心包含一个256×256的突触单位阵列。
我们在每个核心中集成了紧凑的基于时间的模拟数字转换器,用于在模拟和数字世界之间进行转换。每个核心还集成了轻量级的数字处理单元,用于执行整流线性单元(reLU)神经激活函数和缩放操作。芯片中间还集成了一个全局数字处理单元,用于执行长短期记忆(LSTM)网络操作。
该团队芯片的独特特点在于其中的内存核心和全局处理单元通过数字通信网络连接。这使其能够在芯片上执行与神经网络各层相关的所有计算,从而大大降低了计算时间和功耗。
为了评估他们的芯片,进行了一项非常全面的研究,他们在芯片上运行了深度学习算法并测试了其性能。他们评估的结果非常有希望,当在芯片上运行并测试CIFAR-10图像数据集时,用于完成图像识别任务的深度神经网络达到了惊人的92.81%的准确率。
这是当前采用类似技术的所有当前报道芯片中准确性最高的水平。在论文中,还展示了如何将模拟内存计算与多个数字处理单元和数字通信结构无缝结合。芯片的8位输入输出矩阵乘法的面积吞吐量为400 GOPS/mm2,比基于电阻性存储器的以前多核内存计算芯片高出15倍以上,同时实现了可比较的能源效率。
IBM Research Europe最近的工作进一步推进了能够支持深度学习算法需求和要求的AIMC芯片的发展。未来,Le Gallo和他的同事所引入的设计可能会进一步升级,以实现更好的性能。
利用从这款芯片和2021年在VLSI上演示的另一款34核芯片中获得的经验,设计了一种端到端的模拟AI推断加速器架构,该架构于今年早些时候发表在IEEE Transactions on VLSI systems上。愿景是将许多模拟内存计算块与一组与之连接的特殊目的数字计算核心结合起来,并通过大规模并行的二维网格进行通信。结合近年来在硬件意识训练方面的先进技术,预计这些加速器在未来几年内能够以软件等效的神经网络准确度,应用于各种模型。
