多样性和包容是负责任地发展人工智能(AI)技术的关键方面,包括情感计算。情感计算专注于识别、解释和回应人类情绪,可以在医疗保健、教育和人机交互等各个领域引起革命性的变革。然而,通过技术手段捕捉主观状态是具有挑战性的,可能会出现错误,就像测谎仪不能正常工作或性别分类系统在判断用户性别时出现错误那样。
如果用于其他决策过程,这些推断可能对人们产生灾难性后果,其影响可能因应用背景而异,例如在边境管控中将无辜的人标记为潜在的犯罪分子,或者在心理健康护理中对弱势群体造成不利影响。
沿着这样的思路,莱顿大学创新智能实验室的Tessa Verhoef和数字法律与技术中心的Eduard Fosch-Villaronga在arXiv预印服务器上发布了一篇文章,指出目前可用和广泛使用的数据集训练的系统可能不适用于所有人,很可能存在种族偏见、针对(精神)健康问题的偏见以及年龄偏见,因为它们来源于没有完全代表社会多样性的有限样本。
Verhoef和Fosch-Villaronga在麻省理工学院(MIT)媒体实验室举行的2023年情感计算和智能交互(ACII'23)会议上,提出了题为“实现适用于所有人的情感计算”的论文。作为情感计算协会(AAAC)年度会议的一部分,该会议是研究情感和多模式人机交互和系统的主要国际论坛。
他们在论文中认为,情感计算数据集中缺乏多样性、公平和包容的因素,直接影响了不同群体情绪识别算法的准确性和公正性。
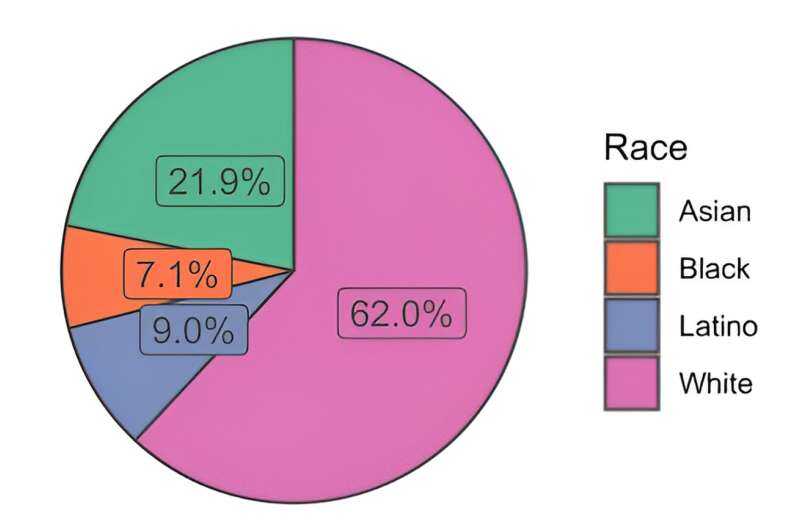
研究人员进行了一项文献综述,揭示了情感计算系统在不同群体中可能有不同工作方式的原因,例如精神健康状况对面部表情和语音的影响,或者与年龄相关的面部外貌和健康变化。为此,他们分析了现有的情感计算数据集,并强调了当前情感计算数据集在种族、性别、年龄和(精神)健康表征方面缺乏多样性的令人不安之处。
通过强调需要更具包容性的抽样策略和对数据集中人口统计因素的标准化文档记录,研究人员提出了建议,并呼吁在情感计算研究中更加关注包容性和社会后果,以促进这一新兴领域的道德和准确结果。
