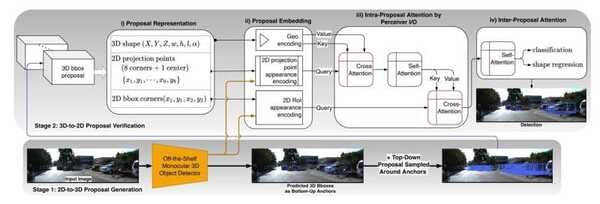
照片是二维的,但是自动驾驶车辆和其他技术需要在三维世界中导航。研究人员开发了一种新方法,可以帮助人工智能从二维图像中提取三维信息,使摄像头成为这些新兴技术中更有用的工具。
北卡罗来纳州立大学的电气与计算机工程学副教授、这项工作的合著者之一吴天夫表示:“现有的从二维图像中提取三维信息的技术不错,但还不够好。”他说:“我们的新方法称为MonoXiver,可以与现有的技术结合使用,并显著提高它们的准确性。”
这项工作对于自动驾驶车辆等应用尤其有用。这是因为相比于使用激光进行距离测量的LIDAR等其他三维空间导航工具,摄像头价格更低廉。由于相机比这些其他技术更实惠,自动驾驶车辆的设计者可以安装多个摄像头,为系统提供冗余。
但是,这只有在自动驾驶车辆的人工智能能够从摄像头拍摄的二维图像中提取三维导航信息时才有用。这就是MonoXiver发挥作用的地方。
现有的从二维图像中提取三维数据的技术(比如吴天夫及其合作者开发的MonoCon技术)利用“包围框”。具体而言,这些技术通过训练人工智能扫描二维图像并在其中的物体周围放置三维包围框,例如马路上的每辆汽车。
这些框体是八个点的长方体,可以想象成鞋盒的角落。包围框可以帮助人工智能估计图像中物体的尺寸,并确定每个物体与其他物体的相对位置。换句话说,包围框可以帮助人工智能确定一辆汽车有多大,并确定其在道路上的位置。
然而,现有程序的包围框并不完美,经常无法包含出现在二维图像中的车辆或其他物体的部分。
新的MonoXiver方法以每个包围框为起点或锚点,使人工智能对每个包围框周围的区域进行第二次分析。这次分析可以产生许多围绕锚点的额外包围框。
为了确定这些次级框体中哪一个最好地捕捉到了物体的“缺失”部分,人工智能进行了两个比较。一个比较是根据每个次级包围框的“几何”形状来确定,是否与锚点框中的形状一致。另一个比较是根据每个次级包围框的“外观”来确定,是否包含与锚点框中的视觉特征相似的颜色或其他视觉特征。
吴天夫说:“这里的一个显著进步是,MonoXiver允许我们非常高效地运行这种自上而下的采样技术,即创建和分析次级包围框。”
为了衡量MonoXiver方法的准确性,研究人员使用了两个二维图像数据集进行测试:经过充分验证的KITTI数据集和更具挑战性的大型Waymo数据集。
吴天夫说:“我们将MonoXiver方法与MonoCon和其他两个设计用于从二维图像中提取三维数据的现有程序结合使用,结果MonoXiver显著改善了这三个程序的性能。”他说:“使用MonoXiver结合MonoCon时获得最佳性能。”
吴天夫说:“重要的是要注意,这种改进带来的计算开销相对较小。”他说:“例如,单独使用MonoCon时,帧率可以达到每秒55帧。当你加入MonoXiver方法时,帧率会降到每秒40帧,但这对实际应用来说仍然足够快。”
“我们对这项工作感到兴奋,并将继续评估和微调以供自动驾驶车辆和其他应用使用。”吴天夫表示。
这篇名为“Monocular 3D Object Detection with Bounding Box Denoising in 3D by Perceiver”的论文已经在arXiv预印本服务器上发表。
