想象一下,当你去外国拜访一位朋友时,你打开他们的冰箱,看看有什么能做出美味早餐的食材。开始时,你会觉得冰箱里的很多东西都很陌生,每个物品都包装在不熟悉的包装盒和容器中。然而,尽管有这些视觉上的区别,你开始理解每样东西的用途,并根据需要选择它们。
受到人类处理陌生物品的能力的启发,麻省理工学院计算机科学与人工智能实验室(CSAIL)的研究团队设计了适用于机器人操控的"特征场"(Feature Fields for Robotic Manipulation,简称F3RM)系统,该系统将2D图像与基础模型特征相结合,生成3D场景,帮助机器人识别和抓取附近的物品。F3RM能够解释人类提出的开放性语言指令,使得该方法在包含数以千计物体的实际环境中(例如仓库和家庭)具有实用性。
F3RM为机器人提供了解释开放式文本提示的能力,使用自然语言帮助机器人操作物体。由此,机器人能够理解人类的不太具体的请求并完成所需的任务。例如,如果用户要求机器人“拿起一个高个子杯子”,机器人可以找到并抓起最符合这个描述的物品。
“在现实世界中使机器人能够真正地做到泛化是极其困难的。”麻省理工学院计算机科学与人工智能实验室和国家科学基金会人工智能研究所的博士后研究员戈·杨说道。“我们真的希望找出如何做到这一点,因此在这个项目中,我们努力推动了一种积极的泛化水准,从仅有的三到四个物体扩展到麻省理工学院斯塔塔中心内的任何物体。我们希望学习如何使机器人像我们一样灵活,因为我们可以抓取和放置物体,尽管我们以前从未见过它们。”
透过视觉学习"事物所在"
这种方法可以帮助机器人在庞大的物品集散中心中处理杂乱无章且难以预料的情况下进行物品拣选。在这些仓库中,机器人通常会被提供一个描述清单的文字,以便它们能够识别出所需的物品。机器人必须将提供的文字与物品进行匹配,无论包装的变化如何,以确保顾客的订单能够正确发货。
例如,主要在线零售商的履行中心可能包含数百万种商品,其中许多机器人以前从未遇到过。为了在这样的规模上运作,机器人需要理解不同物品的几何和语义特征,其中一些物品位于狭小的空间中。利用F3RM先进的空间和语义感知能力,机器人可以更有效地定位物体,将其放入储物箱,并将其发送到包装环节。最终,这将有助于工厂工人更高效地发货客户订单。
"有一件事情常常让人们对F3RM感到惊讶,那就是同样的系统也适用于房间和建筑的规模,可以用于构建机器人学习和大型地图的模拟环境," 杨先生说道。"但在我们进一步扩大这项工作之前,我们希望首先让这个系统运行起来非常快速。这样,我们就可以将这种类型的表示用于更多的动态机器人控制任务,希望能够实时进行,从而使处理更加动态任务的机器人能够用它来感知。"
麻省理工学院团队指出,F3RM能够理解不同场景的能力使其在城市和家庭环境中非常有用。例如,这种方法可以帮助个人化机器人识别并捡起特定物品。该系统帮助机器人在物理和感知上把握周围环境。
"视觉知觉被David Marr定义为通过观察来知道'物体在哪里'的问题," MIT电气工程与计算机科学副教授以及CSAIL主要研究员Phillip Isola如是说道。
最近的基础模型在识别物体方面变得非常出色;它们能够识别数千种物体类别并提供图像的详细文本描述。与此同时,光辐射场在场景中定位物体方面也变得非常出色。将这两种方法结合起来,可以创建一个关于物体在三维空间中的位置的表示。我们的工作表明,这种结合对于需要在三维空间中操纵物体的机器人任务尤其有用。
创造一个“数字孪生”
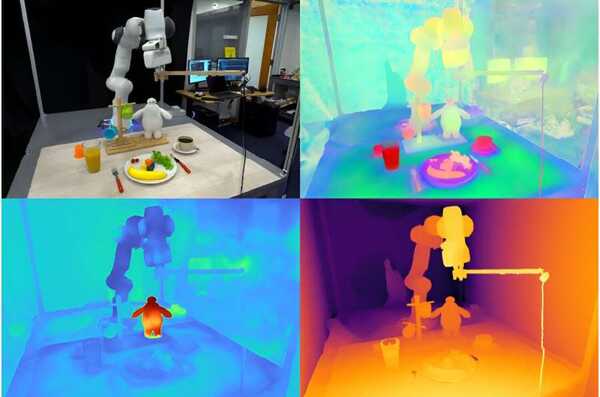
F3RM开始通过使用自拍杆来理解周围的环境。安装的相机拍摄了50张不同姿势的照片,使得它能够构建一个神经辐射场(NeRF),这是一种利用2D图像构建3D场景的深度学习方法。这个由RGB照片拼成的拼贴品形成了周围环境的“数字孪生”,以360度呈现附近的景象。
除了一个高度详细的神经辐射场外,F3RM还构建了一个特征场,以增强几何结构的语义信息。该系统利用CLIP,这是一个在数亿张图像上训练得出的视觉基础模型,以高效地学习视觉概念。通过对自拍杆拍摄的图像进行2D CLIP特征的重构,F3RM有效地将这些2D特征映射到了3D表示中。
保持事情的开放性
在接受了几次演示之后,机器人利用其对几何和语义知识的应用,可以抓取以前从未遇到过的物体。一旦用户提交了文本查询,机器人会在可能的抓取空间中搜索,以确定哪个抓取方式最有可能成功地拾起用户所请求的物体。每个潜在的选项都会根据与提示的相关性、与机器人训练样本的相似度以及是否会发生碰撞进行评分。然后,选择评分最高的抓取方式并执行。
为了展示系统从人类的开放式请求中解释的能力,研究人员要求机器人捡起迪士尼电影《超能陆战队》中的角色“大白”。虽然F3RM从未直接接受过捡起这个卡通超级英雄玩具的训练,但机器人利用其基础模型中的空间意识和视觉语言功能来决定选择哪个物体以及如何捡起它。
F3RM还可以让用户以不同层次的语言细节指定他们希望机器人处理的物体。例如,如果有一个金属杯和一个玻璃杯,用户可以向机器人要求"玻璃杯"。如果机器人看到两个玻璃杯,其中一个装满了咖啡,另一个是果汁,用户可以要求"带咖啡的玻璃杯"。内置于特征领域的基础模型使得机器人可以理解这种开放式的细节要求。
“如果我向一个人展示了如何用嘴唇拿起一个杯子,他们可以轻松将这种知识应用到拿起具有类似几何形状的物体,比如碗、计量烧杯,甚至是胶卷。对于机器人而言,要达到这种适应性水平一直是非常具有挑战性的,"麻省理工学院的博士生、CSAIL成员和共同主要作者威廉·申说道。
F3RM融合了对几何理解和语义的基本模型,在互联网级别的数据上进行训练,从而能够实现从仅有少量演示中的如此激进的泛化水平。
这篇名为《蒸馏特征场在少样本语言引导操控中的应用》的论文已经发表在arXiv预印本服务器上。