研究人员利用了最近发表的人类、黑猩猩、倭黑猩猩、大猩猩和两只猩猩的端粒到端粒的基因组,来预测DNA序列除了传统的双螺旋结构之外,还可能形成哪些替代结构。
某些DNA序列能够形成不同于常见的双螺旋结构。这些替代构象被称为非B型DNA,与细胞过程的调控和基因组进化有关。然而,由于非B型DNA通常出现在基因组的重复区域,因此,一直以来很难准确读取和组装其序列。
现在,宾夕法尼亚州立大学 (Penn State) 生物学家领导的一个研究小组通过系统预测类人猿基因组中非B型DNA结构的位置取得了重大进展。这是理解这些结构在生物功能和进化中所起作用的关键第一步。非B型DNA已被证实与遗传病和癌症有关。
这一突破得益于最近完成的端粒到端粒 (T2T) 基因组组装,这些组装为人类和其他类人猿提供了完整且无间隙的序列。这些组装克服了之前因高度重复的 DNA 区域所带来的局限。发表在《核酸研究》(Nucleic Acids Research)上的这项新研究表明,新测序的基因组区域富含非 B 型 DNA 结构,并指出了潜在且之前未知的功能。
“当人类基因组于2001年首次公布时,其实它并不完整,”宾夕法尼亚州立大学Verne M. Willaman生命科学讲座教授、生物学教授及研究团队负责人卡特里娜·马科娃说道。“由于当时的技术和计算算法无法重建这些区域,因此约有8%的基因组(大部分是重复DNA)仍未确定。2022年和2023年,端粒到端粒联盟付出了巨大努力填补了人类基因组的这些空白,而今年,我们也为所有大猩猩基因组做了同样的事情。”
重复性DNA带来的挑战
对于大多数已测序的基因组,研究人员采用的是短读长DNA测序技术。这些技术的原理是,首先将基因组分解成数百万个微小的片段,这些片段可以测序,然后必须像拼接世界上最复杂的拼图游戏那样被小心翼翼地重新组装起来。
“基因组的大部分由重复 DNA 组成,在一条染色体上,同一个短序列可能连续出现数百次甚至数千次,”宾夕法尼亚州立大学 (Penn State) 生物学博士后研究员、本文第一作者林内亚·斯梅兹 (Linnéa Smeds) 介绍称。“这对于通过短片段读取来组装基因组来说是个难题,因为存在许多看起来相同的拼图碎片。而 T2T 基因组利用新型长片段读取测序技术克服了这一问题,使我们能够用更少的较长片段对基因组进行测序。这样,我们就能首次探索这些区域是否存在有趣的功能元件,比如非 B 型 DNA。”
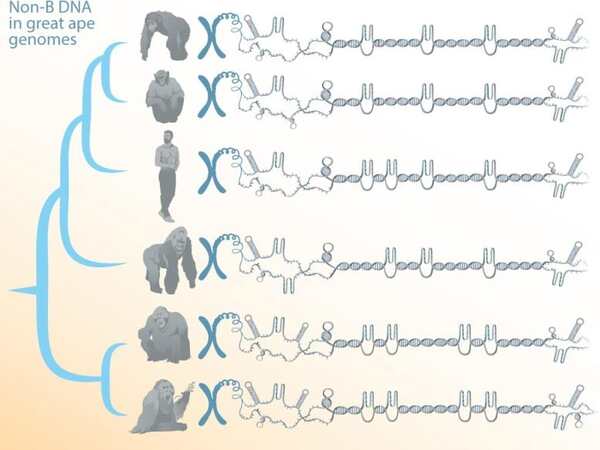
基于某些倾向于重复的序列基序,非B型DNA可以呈现多种形式,包括弯曲DNA、发夹结构、G四联体(G4)和Z型DNA。这些结构最近已被证实与多种细胞过程有关,如细胞分裂期间的DNA复制起始、基因表达调控以及端粒(染色体末端的帽状结构)和着丝粒(在细胞分裂中发挥关键作用的染色体结构)的功能。
研究团队在这些T2T基因组中搜索这些序列基序,以确定人类、黑猩猩、倭黑猩猩、大猩猩、两种猩猩以及作为外群的小猿类合趾猿的基因组中所有潜在的非B构象形成区域。
结构模体的全基因组视图
斯梅德斯(Smeds)说:“我们现在对这些基因组中易于形成非B型DNA的基序有了全面的了解。”
研究团队发现,新解析的基因组序列富含非B型基序,且非B型DNA的分布模式在猿类物种中大体相似。已知大猩猩基因组的重复DNA占比较高,其潜在的非B型DNA基序的数量也更高。
非B型DNA也往往具有较高的突变率且可能不稳定,这可能导致DNA断裂点并允许染色体发生重排,研究人员认为,这对于基因组进化和某些遗传疾病而言可能很重要。
斯梅德斯(Smeds)说:“最近,一种被称为卫星DNA的重复DNA被证实是21号染色体易位的断裂点,这种易位与唐氏综合征的一种类型有关。我们发现,在这个区域,Z-DNA(一种非B型DNA)基序的出现频率比基因组其他部分高出97倍,这可能表明非B型DNA在这些类型的染色体重排中发挥了作用,但要验证这种关系,还需要进行更多的研究。”
目前研究人员仅分析了少数基序,实验证实非B型DNA结构确实存在,但他们强调,其中绝大多数仍有待进一步证实。
马科娃(Makova)说:“在特定基序中形成非B型DNA结构几乎可以肯定地说是依赖于环境的。它可能取决于细胞类型、发育阶段和基因组环境,包括像甲基化这样的DNA修饰。最近,我们对基因组功能的看法发生了转变,从只关注序列到也关注结构。我们希望我们的研究能为进一步研究这些新型基因组结构特征的功能奠定基础。”
参考文献:《2025年4月14日核酸研究》上Linnéa Smeds、Kaivan Kamali、Iva Kejnovská、Eduard Kejnovský、Francesca Chiaromonte和Kateryna D Makova所著的“人类和其他类人猿端粒到端粒基因组中的非规范DNA” 数字对象唯一标识符:10.1093/nar/gkaf298
除了马科娃和斯梅兹之外,研究团队还包括凯万·卡马利(Kaivan Kamali),在研究进行时他是宾夕法尼亚州立大学(Penn State)的计算机科学家;弗朗西斯卡·基亚罗蒙泰(Francesca Chiaromonte),宾夕法尼亚州立大学统计学教授,生命科学统计领域多萝西·福赫尔·哈克与J·劳埃德·哈克讲座教授;以及来自捷克科学院生物物理研究所的伊娃·科伊诺夫斯卡(Iva Kejnovská)和爱德华·科伊诺夫斯基(Eduard Kejnovský)。本研究由美国国立卫生研究院国家普通医学科学研究所(U.S. National Institute of General Medical Sciences)和捷克共和国格兰特机构(Grantová Agentura České Republiky)资助。
不要错过任何一项突破:订阅SciTechDaily新闻简报。
