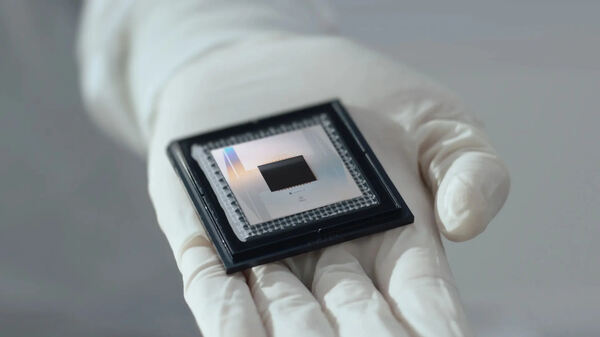
Google在Willow量子处理器上演示了量子上下文性,表明这种量子力学的特殊性质可以在大规模系统中持续存在,并可用于硬件基准测试。
实验测试了量子处理器能否在多项任务中超越经典策略,其中包括一个围绕数学悖论构建的游戏。研究结果有助于理解量子计算优势的来源,并开发更有效的性能度量方法。
Google Quantum AI团队在《Science》发表的论文中报告,其处理器在所谓魔方游戏中的胜率为98.3%,超过经典策略88.89%的最高成功率。研究人员还在涉及最多105个量子比特的任务中展示了量子与经典的分离。
量子优势
量子上下文性描述的是测量结果可能取决于同时执行的其他兼容测量。换言之,量子系统并不总能被描述为具有固定属性、等待观测揭示。
团队用3×3网格说明这一概念:每行乘积必须为正一,每列乘积必须为负一。没有任何网格能同时满足两条规则,因为负项总数必须同时为偶数和奇数。
在魔方游戏中,两名玩家分别收到一行和一列,必须在无法通信的情况下给出交点处的相同取值。预先约定的经典策略最多只能赢下九轮中的八轮。量子关联则原则上允许玩家赢下每一轮。
Google对全部九种游戏版本各测试10万次。Willow处理器取得98.3%的胜率,其余失败归因于硬件噪声。
研究人员还使用Bell-Kochen-Specker不等式测量上下文性。处理器记录值为5.590,明显高于经典极限四,并接近量子极限六。
测试更大系统
团队随后考察上下文性在增加量子比特后能否继续存在。在另一项Greenberger-Horne-Zeilinger(GHZ)奇偶校验游戏中,参与量子比特数量增至71时,处理器性能仍高于最佳经典表现。
研究人员还在最多105个量子比特的处理器网格上,使用浅层量子电路运行隐藏线性函数问题。系统成功概率保持在经典阈值之上,但随着系统规模增大、噪声增加,性能有所下降。
除演示量子行为外,实验还揭示了上下文性测试的实际用途。团队表示,这些任务暴露了传统随机电路基准测试可能忽略的细微相干错误。
这些测试通过将处理器性能与量子力学设定的固定极限进行比较,可提供更严格的硬件质量度量。此类测量可能有助于评估面向结构化算法的系统,包括与化学和材料科学相关的模拟。
研究结果还将上下文性与魔术态联系起来,后者是在纠错量子计算机上运行完整算法的重要资源。Google表示,其结果提供了一种途径,用于研究该性质如何促成量子计算的潜在优势。