摘要
五十多年来,制药业的药物开发成本呈指数级增长,从20世纪50年代的数千万美元增长到今天的数十亿美元,即使数据经过通胀调整也是如此。为了维持在治疗未满足的医疗需求方面取得的进展,必须寻找改进药物开发方法的各种来源。在过去的几十年里,计算方法开始在研究和开发中发挥越来越大的作用。从机器学习和分子动力学到量子力学计算,采用了许多计算方法。尽管如此,模拟化学系统,包括量子力学效应,可能是计算密集型的,其中许多方法由于速度和精度而面临有限的实际适用性。
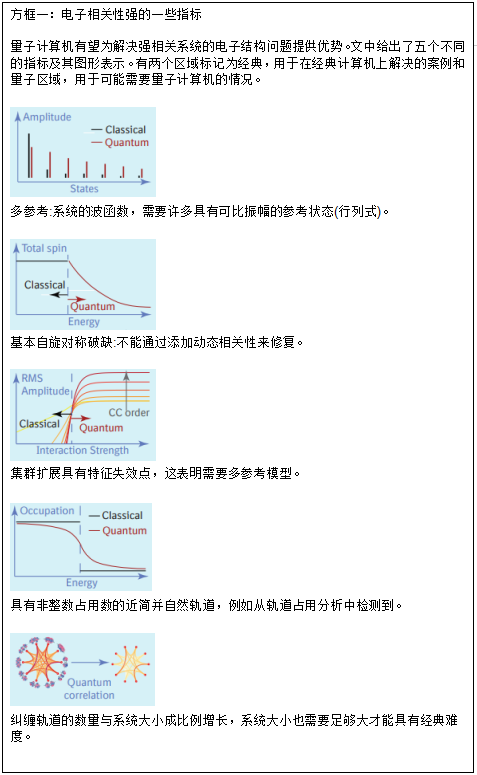
通过利用量子力学特性,量子计算机被提出可以有效地模拟量子系统。受这一前景的启发,近年来量子计算研究激增,量子物理、化学和信息论专家社区带来了量子硬件和算法的改进。最近的发展也吸引了学术界以外的兴趣,在工业中寻找实际应用,这些问题可以预期比经典计算具有最大的可能优势。然而,识别这种具有强电子相关性的系统是困难的,而且只有有限的指标,如方框一所示。虽然解决电子结构问题是许多化学应用的重要步骤,但如果量子计算机的优势仅限于强相关系统,那么它们在药物设计中的实际意义可能有限。来自私人和公共部门的投资。通常,这些投资的理由之一是承诺量子计算机将增强量子化学计算。目前,量子计算的研究工作主要集中在寻找解决最具挑战性的电子结构问题的量子算法,这可能比经典计算具有最大的优势。然而,识别这种具有强电子相关性的系统是困难的,而且只有有限数量的指标,如方框一所示。虽然解决电子结构问题是许多化学应用的重要步骤,如果量子计算机的优势仅限于强相关系统,那么它们在药物设计中的实际意义可能有限。
从这个角度来看,我们讨论了未来量子计算机对药物发现问题的适用性现状; 具体来说,我们专注于量子化学计算,因为我们认为,这将是影响药物设计的第一个可行应用。
虽然我们没有详尽地介绍量子计算的现状,但我们讨论了量子化学中的问题,与经典计算方法相比,量子计算机可以为这些问题提供加速,并将这些问题与计算机辅助药物的实际计算需求进行比较 设计。 最后,我们讨论了使量子计算机成为制药行业必不可少的工具的研究方向。
1.现状:量子计算机
量子计算领域在过去的十年中得到了快速的发展。尽管如此,要实现实用的量子优势,还需要在硬件和算法方面取得重大进展。量子算法发展最重要的衡量标准是其计算成本的估计。这些估计定义了解决感兴趣问题所需的量子计算资源(量子位和运行时间)。它们为量子硬件提供了具体的工程目标,并阐明了算法的哪些方面需要改进。
目前,只有噪声中间尺度量子(NISQ)计算硬件存在,以其噪声性质和有限数量的量子比特而命名。大多数NISQ算法,如变分量子特征求解器(VQE),严重依赖经典的优化启发式方法,并且实际运行时间很难估计。此外,最近的结果表明,在NISQ中,实现给定误差尺度所需的测量数量与电路的深度呈指数关系。出于这些原因,本文将讨论集中在容错量子计算机(FTQCs)上。
FTQCs利用量子纠错来指数级抑制错误,但代价是大量额外的量子比特和运行时间。例如,模拟经典的具有挑战性的分子,如铁钼配合物(FeMoco),将需要大约200个逻辑(纠错)量子比特,这将在200万个物理量子比特中实现,远远超出当前量子硬件所能实现的。
量子计算机有望在寻找分子哈密顿量的基态能量(即解决电子结构问题)方面为所有可处理的经典方法都失败的强相关系统提供明显的优势。要识别这些系统,需要满足几个条件(见方框一),验证这些条件可能非常苛刻和耗时,并且严重依赖化学专业知识。在过去的二十年中,已经开发了一些技术来研究各种从头计算方法如何以及何时失败,提供了强相关性指标。这种情况下需要昂贵的多参考处理的典型例子是多金属系统,其中金属处于相似的电子环境和相互作用。
如果初始态接近基态,量子计算机可以在多项式时间内完成此类计算,而无需进行任何不可控的近似。基态能量的计算结合了态制备和量子相位估计(QPE)。QPE是求哈密顿量本征态和本征值的一种非常有效的算法,是许多量子计算方法的核心。在图1中,我们给出了如何在化学系统的量子计算机上执行这些计算的示例。本文提出的工作流程从一台经典计算机开始,这有助于细化化学系统的几何形状,识别系统的良好初始状态,并合成纠错量子电路。量子计算从内部准备这个经典确定的初始态开始。工作流的下一步是将QPE应用于初始状态。估计正确基态能量的成本直接取决于初始态与基态的重叠程度,并且随着与正确基态的重叠程度的减少,成本会变得越来越高。对该工作流的修改允许计算其他可观测值,例如分子力。
尽管FTQC算法还不能执行,但已有许多方法来评估其计算成本。例如,对于FeMoco的基态能量,通过算法改进,运行时间估计已从年减少到天。进一步的改进肯定会到来,未来我们将能够在FTQC上进行这样的计算。在接下来的部分中,我们将讨论药物设计的现状,以及量子计算机可用于解决相关药理系统的电子结构部分问题。
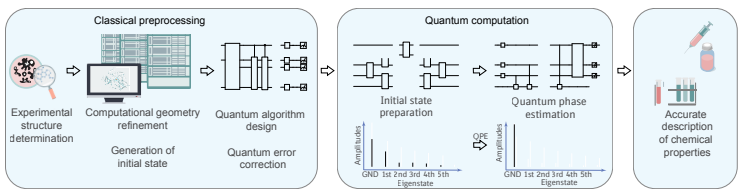
图1.在量子计算机上使用量子相位估计(QPE)算法进行电子结构计算的工作流程。第一步包括经典的预处理,以优化几何和哈密顿量。然后,生成量子电路。在量子计算机上的计算从初始态的产生开始,然后是使用QPE计算更昂贵的基态能量。量子计算容器的下半部分:初始制备的态由许多本征态的叠加组成,但与基态有很高的重叠。当测量基态(GND)能量时,初始状态被投影到基态。
2.计算机辅助药物设计
制药业生产的化合物是一个长期发现和提炼过程的结果。图2总结了这些步骤。药物发现过程从识别与疾病病理有关的靶蛋白开始。该靶点的药理调节被认为有利于治疗该疾病,并通过与靶点的分子结合来实现。确定口服候选药物(最首选的药物管理形式)需要很长时间,从非常弱的结合剂开始,并需要数年的时间来优化有效和安全的分子。
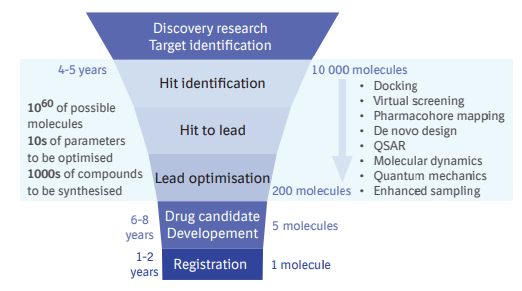
图2.药物发现过程中的工作流程。一旦确定了生物目标,该过程就从 个分子的潜在空间中的hit finding阶段开始。通过设计、分析、合成、硅内和体外测试的重复循环,通过设计和选择具有最佳预测和测量性能的化合物,有希望的化合物的数量从10 000个减少到几百个。只有极少数高度优化和安全的分子进入临床试验的开发,只有一种分子最终被医药机构选择批准。右侧列出了 [3] 中药物设计过程的不同阶段所采用的计算方法。
从 个潜在分子中初步筛选出数百万种化合物。在过程的初始阶段,许多不同的属性(例如,结合亲和力)必须被优化。因此,在hit- lead和lead-optimisation项目中,在确定下一步临床开发的合适候选人之前,需要合成数千个分子。每个合成的分子都要经过体外测试(生化、生物物理、细胞),如果性质良好,也要进行体内(有机体)测试;因此,目标是用尽可能少的优化周期实现临床候选。在药物发现的这一阶段,计算方法通过指导正确分子的设计而具有高度价值,最近已经报道了一些计算设计的惊人成功。
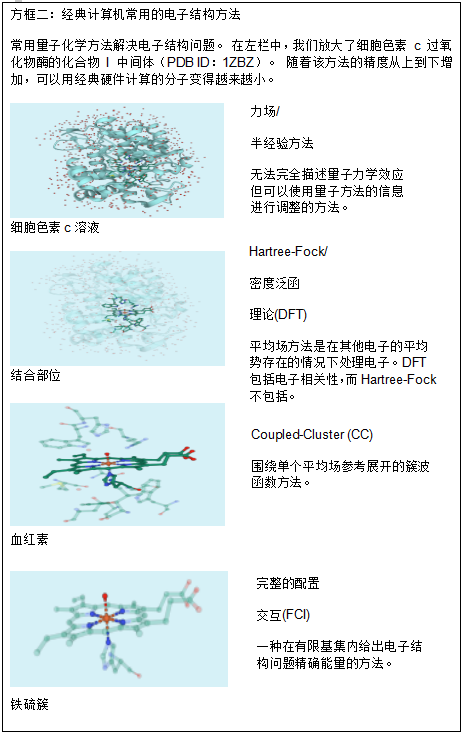
已经确定了计算化学可以支持药物设计的两个主要领域:(1)药代动力学特性的预测(化合物如何从体内吸收、分布、代谢和排泄),通常通过在制药公司项目遗产的大量实验数据上训练的机器学习模型来实现;(2)计算化合物与靶点的结合强度或结合亲和力,这是候选药物最重要的特性之一。结合亲和力相当于药物与靶标之间的结合自由能。它直接对应靶点所需的局部药物浓度,决定药物的疗效。因此,它转化为预期的人体治疗剂量,这是药物设计中最重要的一个参数。在复合优化中,结合强度的计算必须准确。然而,基于经典力场的分子动力学模拟的最先进方法的性能并不可靠。目标是实现较高的准确性(在1.0千卡/mol到实验范围内),因为在生理温度下,1.5千卡/mol的偏差已经转化为错误一个数量级的剂量估计。在原子尺度上,一个系统可以在经典计算机上处理,对于不同的大小,可以有许多不同的近似级别;见方框二,其中报告了一些常用方法。与力场相反,密度泛函理论(DFT)或耦合簇(CC)是基于量子力学的方法,可以更好地描述分子相互作用,但计算成本高得多。
这些计算中的其他困难来自化合物性质的热力学性质。分子可以通过许多不同的方式与蛋白质结合。人们必须考虑不同的可访问系统几何形状和绑定路径。我们需要确定具有最小自由能的构型,这是统计上最常观察到的构型。在图3中,一个分子结合到一个蛋白质的过程被图形描述。许多不同的配置,因此必须计算许多单点计算。
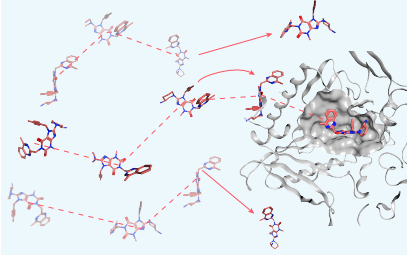
图3.药物结合事件的示意图(pdb ID: 2RGU)。配体以构象/几何形状和方向的集合存在(左)。配体接近靶点时,有些会结合,有些则不会,如箭头所示(右)。最终,对溶液中非结合结构和结合结构的集合进行采样,产生药物-靶标结合的自由能。同样,结构相似的配体束缚系综的能量差异直接关系到它们结合强度的差异。
在评价许多具有相似化学结构的化合物的结合倾向时,直接计算化合物之间的结合强度差异往往更快;这一任务通常通过金化学摄动方法来完成,在这种方法中,已知的化合物逐渐转变为一种新的化合物,从而适应相应的电子结构。在这方面,通过药物-靶标复合物的自然时间演化来模拟集合特性是一个关键步骤,从中可以直接推导出有关热力学特性的知识。
该系统包括靶标、药物和溶剂,由数千个原子组成(见方框二),自由能计算需要数十亿单点计算,其中进行能量和力评估,见图3。此外,在模型中必要地包含显式溶剂(水)可以大大增加自由度和复杂性,使运行时间往往不切实际。在经典计算机上计算小分子与目标蛋白的结合自由能可能需要数小时。提高精度,例如通过利用DFT,将计算成本增加几个数量级,使自由能计算的完整DFT处理变得难以实现。因此,需要更多计算资源的更高层次的理论处理,例如 CC,完全超出了范围,只能应用于小型系统。
量子计算在药物开发中的其他潜在用例包括用于优化药物合成条件的反应机制的计算和优化,以及用于核磁共振(NMR)、红外(IR)或振动圆二色性(VCD)光谱识别结构的分子光谱计算。然而,如果与药物设计阶段更好更快的计算(先导优化)的潜在影响相比,量子计算对药物设计的这些用例的影响将是相当温和的。例如,通常情况下,药物合成成本不是非仿制药市场价格的主要驱动因素。其原因是平衡大量失败的优化方案和临床试验的经济需求。此外,对于核磁共振谱的预测,精度较低的方法(如DFT)在许多情况下都取得了很好的结果。
总之,在药物设计中,大多数量子力学计算的用例将受益于对DFT和CC方法的加速,这些方法对于在药物开发过程中更广泛的应用仍然太慢,但对于大多数系统来说已经提供了足够的准确性。这是因为大多数口服药物是小的封闭壳有机分子(需要通过肠壁才能被吸收),通常缺乏很强的相关性,少数例外情况下,如药物代谢中的细胞色素P450相互作用,由于其一般的元素组成,可以采用较低精度的方法进行治疗。然而,很少有以金属为中心的药物分子存在,例如,用于癌症治疗或组织的对比增强成像。一个开放的、未探索的问题是,这种潜在强相关性药物的稀缺是否是由于含金属药物的某些固有的有害特性。这可能在于它们不期望的药代动力学行为或潜在的毒性,这将使它们不适合作为药物。另一种可能性是,由于计算优化方面的挑战,它们已被避免。
3.挑战与展望
目前量子化学在药物设计中的局限性要么来自缺乏准确性(对于少数描述的困难系统),要么来自生物分子集合的DFT计算的大计算成本。对于这两个限制,尽管有希望的想法已经开始出现,但量子计算机还不能立即解决问题。
目前,量子计算机有望利用已知的量子算法(例如 QPE)加速强关联系统的电子结构计算。 例如,这可用于更好地理解细胞色素 P450 的物理学。 然而,如果人们能够超越计算强相关系统的单点能量,那么最大的影响将会到来。
在过去的30年里,无论是在硬件方面,还是在算法方面,都有了显著的改进。尽管这些改进使我们目前拥有的令人印象深刻的量子计算能力成为可能,但要使量子计算在药物发现方面变得实用,还需要做更多的事情。
关于算法的运行时,量子纠错是执行容错量子算法的空间和时间开销成本的主要来源之一。错误纠正需要为每个逻辑量子比特提供数千个物理量子比特,从而导致计算FeMoco基态能量需要数百万个量子比特。为了减少这些开销,不仅需要开发具有更低错误率和更高量子比特连通性的更好硬件,而且还需要探索量子纠错的新的进一步改进。
在算法方面,尚未解决的主要挑战之一是准备初始状态,因为 QPE 的运行时间直接取决于该状态。尽管运行时间随着时间的推移有所改善,但对初始和目标状态重叠的依赖无法规避。已经提出了几种启发式解决方案,但需要进一步研究才能完全了解这个问题的程度。对于弱相关系统,一种潜在的解决方案是将系统分解为更小的子系统,在这些子系统上应用一系列 QPE 以保持整体重叠。
另一个重要的研究方向是减少总体计算成本,例如通过寻找系统哈密顿量的更紧凑的表示,这直接影响量子算法的运行时间。同时,类似于经典算法,应该有可能找到基于启发式的特定情况下的量子算法,该算法的可扩展性比一般算法好得多。然而,由于缺乏纠错量子计算机,目前无法对启发式算法进行彻底的基准测试。然而,可能有更系统的方法来分析特定输入参数的启发式方法的比例因子和常数因子。
目前的量子算法专注于以最高精度提供加速,这并不总是与工业应用相关。与近似的经典方法相比,大量的运行时间改进将产生更大的中期影响。然而,在量子计算机上加速近似技术似乎相当具有挑战性。DFT和HartreeFock已经在经典计算机上实现了线性扩展,在量子计算机上很难超越它们。相反,量子计算机可以为系统的物理提供新的见解,以改进经典方法。例如,我们可以使用量子计算为DFT设计更好的泛函。或者,也可以使用量子计算机来加速收缩张量网络中的经典计算。在量子计算机上实现CC方法可以实现优化阶段的二次加速。另一种可能是利用量子计算机上的微扰理论来节省计算成本。最近的结果也表明,量子计算机在模拟电子动力学方面可以优于经典的平均场方法。未来,人们可以探索在精度和成本之间进行权衡的新途径,例如,调整哈密顿量模拟的数值精度或截断哈密顿量中的信息量。
在药物设计方面,虽然单点计算可以深入了解系统的物理学,但我们通常需要数十亿次单点计算来确定热力学量,例如结合亲和力。这种大量的计算,加上其中一个按天顺序的量子计算运行时间,使得无法在合理的时间内获得结果,更不用说与高度优化的实验的运行时间竞争了。在量子计算机上同时模拟一个波函数中的经典原子核和电子,可能是一条更实用的热力学量计算的潜在途径。人们可以设想直接在量子计算机上通过生成几何的热系综来计算热力学性质,例如自由能。此外,量子力学处理原子核将有助于解释分子光谱。
从更具推测性的角度来看,应用于量子计算结果的量子机器学习算法有可能预测药代动力学特性 。 当大型量子计算机可用时,我们可能能够计算许多分子系综的波函数,然后在这些波函数上运行量子机器学习算法。
4.结论
目前经典计算方法在制药行业的相关时代无法准确描述量子系统,限制了量子化学在药物设计中的适用性。只要计算成本低于实验成本,更精确的计算可以用硅计算代替许多劳动密集型的实验,从而为制药行业带来巨大的价值。量子计算可以利用直接从波函数导出性质的方法,使对化学系统的关键的、实验上无法获得的洞察成为可能。
为了对制药行业产生深远的影响,量子计算机需要解决更广泛的问题,而不是经典计算机无法解决的少数问题。典型的相关系统有数千个原子,例如大型蛋白质结构及其周围环境,很少需要精确的准确性。然而,在许多医药使用案例中,必须确定依赖于大型热力学系综的热力学性质,因此需要许多单点计算。找到新的方法,在量子计算机上权衡精度与时间,或避免采样,可能是有益的。理想情况下,量子计算机应该为强相关和弱相关系统提供准确性和鲁棒性,其速度目前只能通过较低精度的方法获得。通过摆脱目前的一些近似值,量子计算在药物设计中将变得真正具有预测性,并得到更广泛的应用。
在过去的几年中,用于电子结构问题的量子算法的主要进展降低了计算成本,而在工业上的实际应用还需要进一步改进。此外,需要对硬件、纠错码和算法(如状态准备)进行根本性的改进,以超越单点能量计算。
人们已经采取了一些措施解决其中一些挑战,并且存在实现这些目标的几种途径。我们相信,将学术界和工业界结合起来的开放研究将有助于使量子计算成为一种必不可少的工具,以更快地设计出更好的药物。
