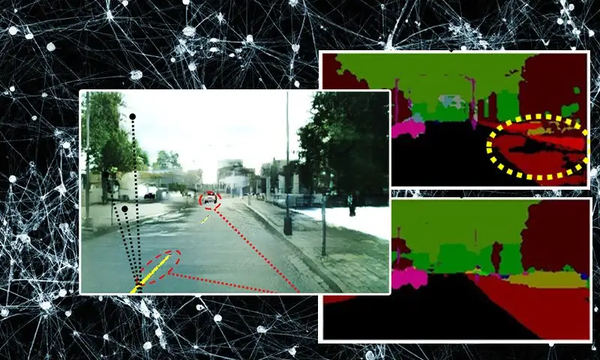
美国和中国之间的一项新研究合作计划提出使用生成对抗网络 (GAN) 来提高驾驶模拟器的真实性。在挑战产生逼真的 POV 驾驶场景的新挑战中,研究人员开发了一种混合方法:通过将基于 Cycle GAN 的系统更逼真的输出与更传统生成的元素混合,从而发挥不同方法的优势,这需要更高级别的细节和一致性,例如,道路标记和从驾驶员的角度观察到的实际车辆情况。
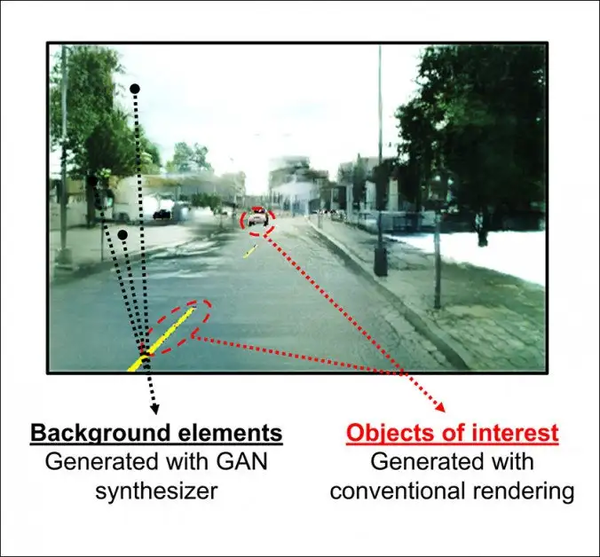
混合生成神经图形 (HGNG) 为驾驶模拟提供了一个新方向,它保留了基本元素(如道路标记和车辆)的 3D 模型的准确性,同时发挥了 GAN 在生成有趣且非重复的背景和环境方面的细节优势
该系统被称为混合生成神经图形(HGNG),它将传统的基于CGI的驾驶模拟器高度有限的输出注入GAN管道,其中NVIDIA SPADE框架接管了环境生成的工作。
作者表示,这样做的优势在于,驾驶环境可能会变得更加多样化,创造出更加沉浸式的体验。目前来看,即使将CGI输出转换为照片级真实感渲染输出也不能解决重复的问题,因为进入神经管道的原始镜头受限于模型环境的限制,以及它们重复纹理和网格的倾向。
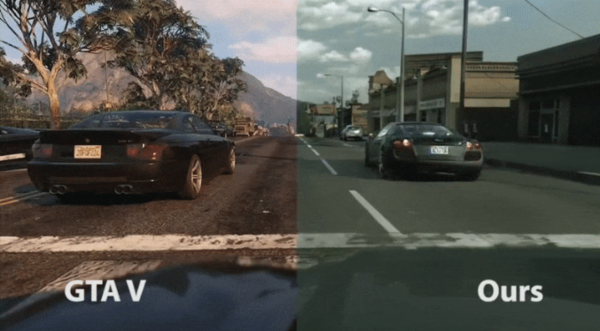
2021年论文“《Enhancing photorealism enhancement》’(《增强真实感增强》)”的转换镜头,这仍然依赖于CGI渲染的镜头,包括背景和一般环境细节,限制了模拟体验中环境的多样性。
该论文指出:“传统驾驶模拟器的保真度取决于它的计算机图形管道的质量,其中包括3D模型、纹理和渲染引擎。高质量的3D模型和纹理需要手工制作,而渲染引擎必须运行复杂的物理计算才能真实地呈现光照和阴影。”
现在这篇新论文名为《Photorealism in Driving Simulations: Blending Generative Adversarial Image Synthesis with Rendering》(《驾驶模拟中的真实感:混合生成对抗图像合成与渲染》),出自于美国俄亥俄州立大学电气与计算机工程系和中国重庆长安汽车有限公司的研究人员。
背景材料
HGNG通过混合部分渲染的前景材料和GAN生成的环境来转换输入CGI生成的场景的语义布局。尽管研究人员尝试了各种数据集来训练模型,但事实证明,最有效的是KITTI视觉基准套件,它主要以捕捉来自德国卡尔斯鲁厄镇的驾驶员POV材料。
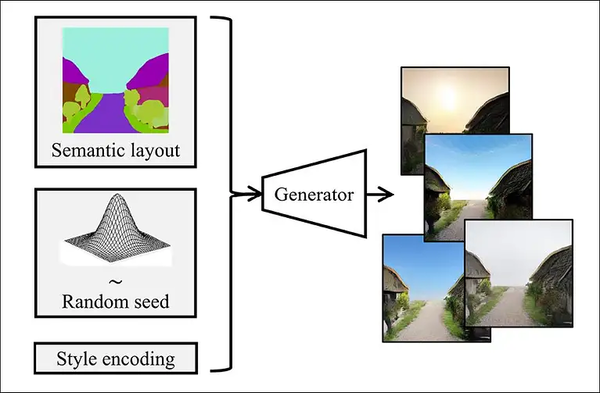
GNG 从 CGI 渲染输出生成语义分割布局,然后插入具有不同风格编码的 SPADE,以创建随机且多样化的逼真背景图像,包括城市场景中的附近物体。新论文指出,资源受限的 CGI 管道中常见的重复模式会“破坏”人类驾驶员使用模拟器的沉浸感,而 GAN 可以提供的更多样化的背景可以缓解这个问题。
研究人员实验了条件GAN (cGAN)和CYcleGAN (CyGAN)作为生成网络,最终发现每个都有优点和缺点:cGAN需要配对的数据集,而CyGAN不需要。然而,CyGAN目前的性能不能超过最先进的传统模拟器,有待进一步改进的领域适应和循环一致性。因此,cGAN在对配对数据有额外要求的情况下,获得了目前最好的结果。
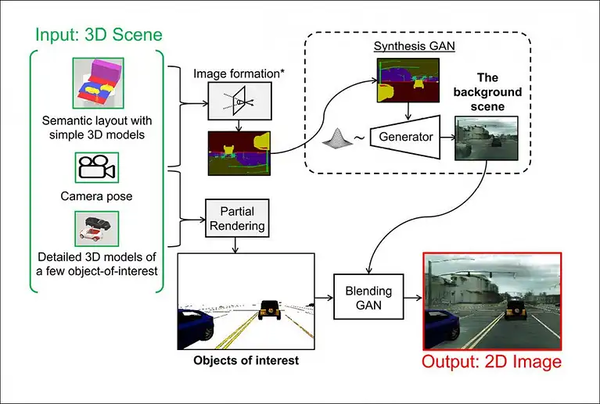
HGNG 的概念架构
测试
为了测试该系统,研究人员使用在Cityscapes上训练的 SPADE将场景的语义布局转换为逼真的输出。该CGI源来自开源的驾驶模拟器CARLA,它利用虚幻引擎4 (UE4)。
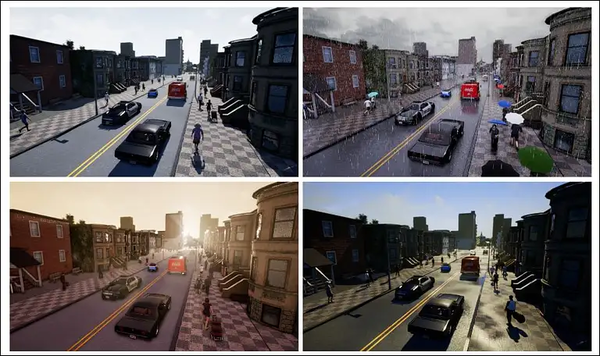
开源驾驶模拟器 CARLA 的输出
UE4的阴影和照明引擎提供语义布局和部分渲染图像,只输出车辆和车道标记。混合是通过在瞬态属性数据库上训练的GP-GAN实例实现的,所有实验在8 GB GDDR6 VRAM的NVIDIA RTX 2080上运行。
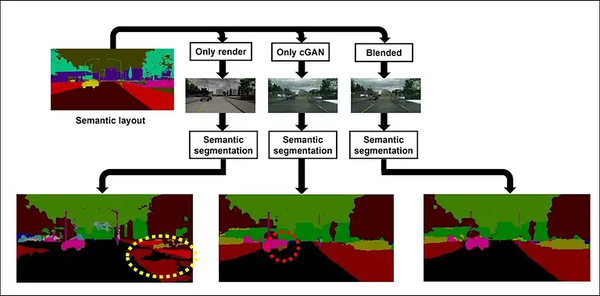
在上面的测试图像中,我们看到在“只渲染”图像(左下)中,完整的渲染并没有获得可信的阴影。研究人员注意到,这里(黄色圆圈)落在人行道上的树木阴影被DeepLabV3(用于这些实验的语义分割框架)错误地归类为“道路”内容。
在中间的柱流中,我们看到cGAN创建的车辆没有足够一致的定义,无法在驾驶模拟器中使用(红圈)。在最右边的列流中,混合图像符合原始语义定义,同时保留基本的基于CGI的元素。
为了评估真实性,研究人员使用了Frechet Inception Distance (FID)作为性能指标,因为它可以对配对数据或非配对数据进行操作。
使用三个数据集作为地面真实数据:Cityscapes、KITTI和ADE20K。
输出图像使用FID评分进行比较,并与基于物理(即CGI)的管道进行比较,同时还评估了语义保留。
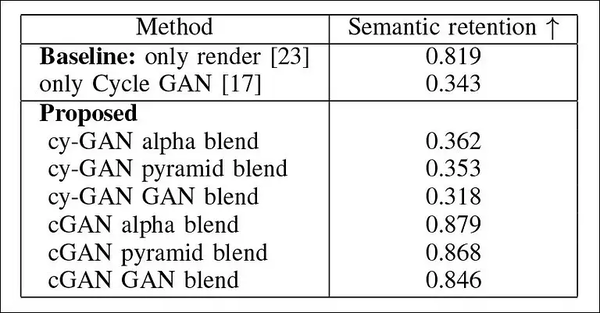
在上述与语义保留相关的结果中,分数越高越好,基于 CGAN 金字塔的方法(研究人员测试的几个管道之一)得分最高。

上图直接显示的结果与 FID 分数有关,HGNG 通过使用 KITTI 数据集获得最高分数。
“仅渲染”方法与 CARLA 的输出有关,CARLA 是一种 CGI 流程,预计不会像照片般逼真。
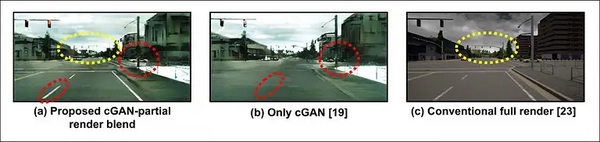
在传统的渲染引擎上的定性结果(在图片正上方的C)显示不现实的遥远背景信息,如树木和植被,而需要详细的模型和实时网格加载,以及其他处理器密集的过程。在中间(b),我们看到cGAN未能获得基本元素、汽车和道路标记的充分定义。在建议的混合输出 (a) 中,车辆和道路的清晰度很好,而周围环境则多样且逼真。
这篇论文的结论是,通过使用更大的城市数据集,可以提高GAN生成的渲染管道部分的时间一致性,并且未来在这个方向上的工作可以为基于 CGI 的昂贵的神经转换提供真正的替代方案,同时提供更大的真实感和多样性。
