数据可谓是机器学习模型的命脉,但是当这种宝贵资源的访问受到限制时会发生什么?正如许多项目和公司开始展现的那样,这时候合成数据就算不是一种出色的选择,也是一种可行的选择。
什么是合成数据(Synthetic Data)?
合成数据可以定义为人工制造的信息,而不是通过直接测量获得的。从本质上说,“伪造”数据的想法并不是一个新的或革命性的概念,它实际上是一种为缺乏可用或必要信息的模型生成测试或训练数据的方法的不同标签。
在过去,由于缺乏数据,人们只能方便地使用随机生成的一组数据点,尽管这对于教育和测试目的来说已经足够了,但是随机数据并不是任何类型的预测模型的训练对象,这就是合成数据的不同之处,它是可靠的。
从本质上说,合成数据是一种独特的想法,即我们可以聪明地产生随机数据。因此,这种方法可以应用于更复杂的用例,而不仅仅是测试。
如何生成合成数据?
虽然合成数据的创建与随机数据没有什么不同——只是通过更复杂的输入集——但合成数据确实有不同的目的,因此具有独特的需求。
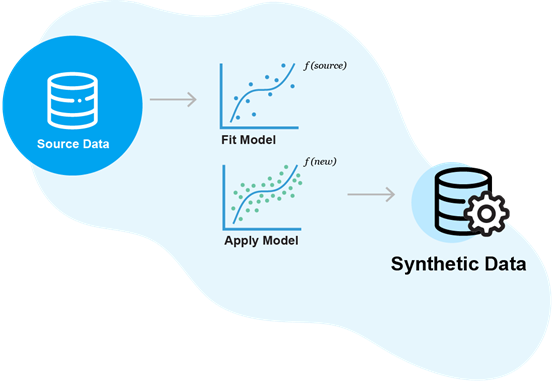
合成方法基于并仅限于预先作为输入而馈入的某些标准。实际上,它不是随机的。它基于一组具有特定分布和标准的样本数据,这些标准决定了数据点的可能范围、分布和频次。大致说来,目的是复制真实数据以填充更大的数据集,然后该数据集将足够庞大,以便训练机器学习模型。
在探索用于提炼合成数据的深度学习方法时,这种方法变得特别令人关注。算法可以相互竞争,目的是在生成和识别合成数据的能力方面相互超越。实际上,这里的目的是搞一场人工军备竞赛,以生成超现实的数据。
为什么需要合成数据?
如果我们不能收集到推进我们文明所需的宝贵资源,就会找到一种创造宝贵资源的方法,这个原则现在同样适用于机器学习和人工智能的数据领域。
在训练算法时,拥有非常大的数据样本是至关重要的,否则算法识别的模式对于真实世界的应用程序来说就有太过简单的风险,这其实很符合逻辑。就像人类智能倾向于采取最简单的方法来解决问题一样,在训练机器学习和人工智能时也经常发生同样的情况。
例如,让我们将此应用于一个对象识别算法,该算法可以准确地从一组猫的图像中识别出一只狗。由于数据量太小,人工智能可能会依赖于一些模式,而这些模式不是它试图识别的对象的基本特征。在这种情况下,它可能仍然工作,但是当遇到不遵循最初确定的模式的数据时,它就会停止工作。
合成数据为何能解决日益受到关注的数据隐私问题?
全世界目前正在经历一场非常剧烈的转变,尤其是在欧盟:隐私和所生成的数据越来越受到保护。在机器学习和AI领域,加强数据保护是老大难问题。受限制的数据常常正是训练算法为最终用户执行和提供价值所需要的数据,尤其是对于B2C解决方案而言。
个人决定使用解决方案并因此批准使用他们的数据时,隐私问题通常会得到解决。这里的问题是,在您拥有提供足够价值的解决方案、因而愿意交出个人数据之前,很难让用户向您提供其个人数据。因此,供应商常常会陷入先有鸡还是先有蛋的困境。
合成数据就是解决方案,公司可以通过早期采用者获得数据子集。之后,它们可以使用这些信息作为基础,以便生成足够的数据用于训练机器学习和AI。这种方法可以大大减少对私有数据的费时又费钱的需求,仍可以为实际用户开发算法。
对于医疗保健、银行和法律等某些行业而言,合成数据提供了一种更容易访问以前无法获得的大量数据的方法,消除了新的和更先进的算法通常面临的制约因素。
合成数据能否取代真实数据?
真实数据的问题在于它不是为了训练机器学习和AI算法而生成的,它只是我们周围发生的事件的副产品。如前所述,这显然限制了收集数据的可用性和易用性,还限制了数据的参数和可能破坏结果的缺陷(异常值)的可能性。这就是为什么可以定制和控制的合成数据在训练模型时更高效。
然而,尽管非常适用于训练场景,但合成数据将不可避免地始终依赖至少一小部分真实数据用于自身的创建。所以合成数据永远不会取代它所依赖的初始数据。更现实地说,它将大幅减少算法训练所需的真实数据量,这个过程需要比测试多出一大截的数据——通常80%的数据用于训练,另外20%的数据用于测试。
最后,如果处理得当,合成数据提供了一种更快捷、更有效的方式来获取我们需要的数据,成本比从现实世界获取数据的成本更低,同时减少了烦人的数据隐私问题。
原文链接:https://www.techrepublic.com/article/synthetic-data-viable-for-machine-learning/