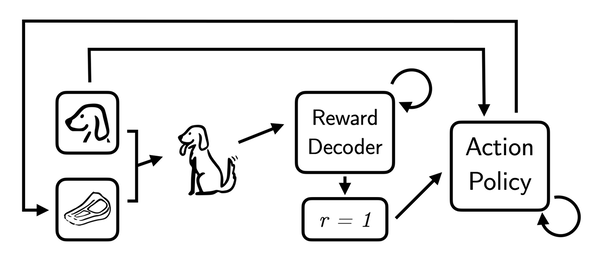
奖励在强化学习 (RL) 中起着至关重要的作用。奖励函数的良好选择会激励代理探索和学习哪些行为是有价值的。代理人通过奖励收到的反馈使他们能够更新自己的行为并学习有用的策略。然而,设计奖励函数既复杂又繁琐,即使对于领域专家也是如此。
对于与系统交互的最终用户来说,自动推断奖励功能更为可取。例如,ChatGPT 使用人类反馈强化学习 (RLHF) 来学习奖励函数,它利用明确的人类反馈来更好地使对话响应与人们喜欢的响应保持一致。
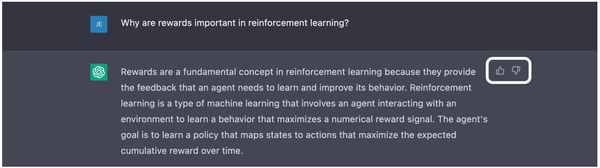
用户可以通过提供明确的赞成/反对反馈来帮助 ChatGPT 改进
最近的基于交互的学习(IGL,Interaction-Grounded Learning)范式是另一种推断奖励函数的方法,可以捕捉最终用户的意图。在IGL设置中,代理通过交互过程本身推断奖励函数,利用任意反馈信号而不是明确的数字奖励。虽然没有明确的奖励信号,但反馈依赖于潜在的奖励。智能体必须学习一种策略,通过使用环境的反馈来最大化未观察到的潜在奖励。
代理人怎样才能在IGL充满挑战的环境中取得成功?我们用下面的玩具问题来演示。
玩具问题: Lassie喜欢什么?
你领养了一条新狗,Lassie!当Lassie在新家安顿下来时,你要确保她快乐舒适。不幸的是,你不能直接问Lassie是否喜欢狗粮或雪或邻居吵闹的割草机,你能做的就是观察她对这些刺激的反应。根据反应,你可以对她的经验奖励做出有根据的猜测。
或者,您可以使用IGL来了解Lassie的偏好,而不是猜测。IGL的成功需要两个标准:
(1)稀有的奖励和(2)持续的沟通。
稀有奖励要求表明,如果你随机选择行动,Lassie就不太可能喜欢这些行动。如果Lassie一直对你的随机行为感到满意,那就没什么好学的了!为了满足持续沟通的要求,Lassie的反馈应该取决于她潜在的奖励。如果Lassie高兴时和不高兴时都随机叫,我们就不可能知道她的喜好。
这两个要求保证了与潜在奖励相关的反馈很少被观察到,然后IGL能够了解哪些动作会导致很少被观察到的反馈信号,这是通过学习奖励解码器和最优行动策略来完成的。奖励解码器将每个反馈信号与潜在的奖励状态相关联,然后将推断出的潜在奖励用于最优行动策略的目标中。
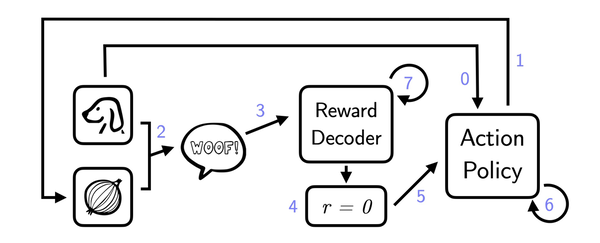
展示IGL如何优化潜在奖励的流程图。动作策略观察上下文并预测哪些可用动作将使潜在奖励最大化。接下来,环境发出反馈信号以响应该动作。奖励解码器推断潜在奖励是什么,并将值传递给相应更新的动作策略。由于Lassie经常吠叫,因此吠叫与 r=0 潜在状态相关。然后,行动政策得知Lassie不喜欢洋葱。
我们的贡献:IGL-P
我们的工作扩展了IGL的文献。之前关于IGL的研究假设奖励是0或1——Lassie要么不开心,要么开心。如果出现罕见的不良状态,这种假设会带来灾难性的后果。例如,如果Lassie害怕你邻居的割草机,两个潜在状态模型会将她罕见的抖动解释为积极的反馈信号,并寻求最大化这种类型的反馈。为了解决这个问题,我们引入了一个三元潜在模型。我们的算法IGL-P使用三种潜在状态和部分标记的示例来消除极端正反馈信号和极端负反馈信号的歧义。
IGL-P还允许个性化的奖励学习。如果你收养了一只与Lassie交流方式不同的加菲猫,交流方式的差异并不会阻止你使用IGL-P了解每只宠物的喜好。我们的算法通过学习哪些反馈信号是罕见的来个性化,这取决于上下文(你是在与Lassie还是加菲猫互动?)IGL-P的个性化不需要额外的计算。相比之下,传统的奖励工程需要广泛的研究和建模。
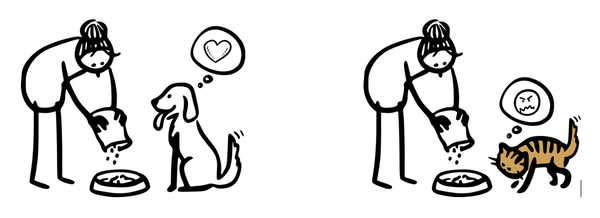
Lassie 狗摇着尾巴表达她对晚餐的兴奋!猫加菲猫摇着尾巴表达他对粗磨食物而不是千层面的愤怒。
推荐系统的IGL-P:一个成功的故事
由于数据稀疏性的挑战,推荐系统是IGL-P的自然候选(你上一次在Netflix上对电影评分是什么时候?)如果没有明确的反馈,推荐系统就无法确定用户是否喜欢所显示的内容。点击或停留时间等隐式信号通常被用作用户满意度的代理。然而,任何一种选择的隐含信号都不是真正的潜在奖励信号。即使是点击率(CTR)指标,推荐系统的黄金标准,也是一个不完美的奖励,它的优化自然会促进标题党。目前最先进的解决方案成本很高,要么依赖于广泛的用户建模,要么依赖于精心调整的奖励信号。
IGL-P 对推荐系统的好处
我们将在 ICLR 2023 上发表的论文《基于交互的个性化奖励学习 (IGL)》展示了 IGL-P 可以成功解决现实环境中昂贵的奖励工程和不公平表现的挑战。首先,我们证明 IGL-P 能够在 Microsoft 的图像推荐场景中胜过最先进的技术。最先进的政策是使用人工设计的奖励函数进行训练的,该奖励函数是非直观的,是产品工程师和数据科学家多年来昂贵的试错研究的结果。通过大规模实验,我们表明 IGL-P 可以实现与当前生产策略一样多的理想反馈和更少的负反馈信号。换句话说,IGL-P 消除了手动设计奖励函数的需要.
对于第二个实验,我们考虑一个 Facebook 新闻推荐场景。我们使用一个大型真实世界数据集 ,该数据集展示了不同 Facebook 新闻页面的读者使用不同的基于点击的表情符号反应信号偏好。我们证明了 Facebook 奖励函数的先前迭代以其他类型为代价向某些类型的读者提供了不成比例的更好推荐。然而,IGL-P 能够为不同的读者类型学习定制的奖励函数,从而为所有用户类型提供一致的良好推荐。我们的结果表明IGL-P 为不同的用户提供了更高的公平性。
由于不同类型的用户与推荐系统的交互方式不同,奖励功能的选择变得更加复杂。越来越多的研究表明,推荐系统不能在不同的细分人群中提供一致的表现,这种不公平的根源在于用户参与风格。换句话说,奖励功能可能对一种类型的用户有效,但对另一种类型的用户却可能表现不佳。
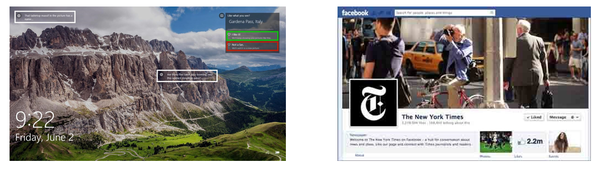
IGL-P 在两个真实世界的推荐场景中取得了成功:(1) Windows 用户的图像推荐和 (2) Facebook 读者的新闻推荐
超越推荐系统的个性化奖励学习
尽管我们考虑了推荐系统的应用,但个性化奖励学习可以使任何遭受一刀切方法困扰的应用程序受益。例如,聊天机器人依靠交互式用户反馈来校准它们的性能和自我改进。然而,不同的用户可能会提供不同类型的有偏见的反馈。IGL-P 可用于针对用户特质进行调整,以便对话代理在结合人类反馈时不会矫枉过正。个性化奖励学习在人机界面方面也具有巨大潜力。凝视辅助工具等技术可以利用 IGL-P 进行自校准眼动仪,以适应以满足用户的需求。最后,个性化奖励学习可以为自动简历筛选等应用提供更高的公平性和消费贷款 。
