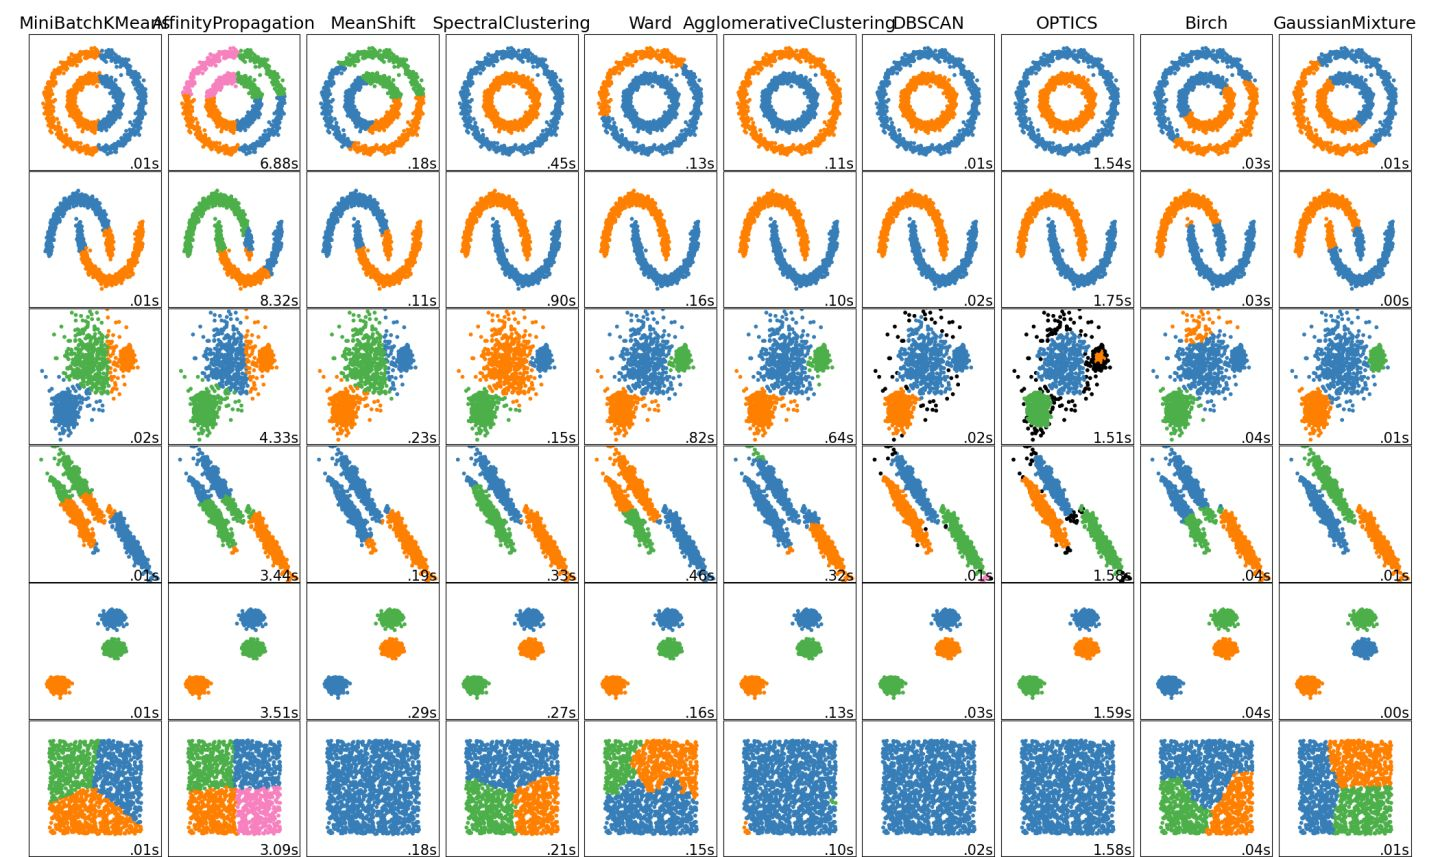
层次聚类是另一种无监督机器学习算法,用于将未标记的数据集分组为一个簇,也称为层次聚类分析(Agglomerative Hierarchical Clustering,HCA)。
在这个算法中,我们以树的形式发展了集群的层次结构,这种树形结构被称为树状图。
有时KK-means聚类算法(K均值聚类算法)和分层聚类的结果可能看起来相似,但它们的不同取决于它们的工作方式,因为不需要像我们在K-Means算法中那样预先确定集群的数量。
分层聚类技术有两种方法:
- 1,Agglomerative: Agglomerative是一种自下而上的方法,在这种方法中,算法首先将所有数据点作为单个集群,并将它们合并,直到剩下一个集群。
- 2,分裂:分裂算法是聚合算法的反向,因为它是一种自上而下的方法。
为什么要层次聚类?
既然我们已经有了其他的聚类算法,比如K-Means聚类,那么为什么我们还需要层次聚类呢?所以,正如我们在K-Means聚类中看到的,这个算法有一些挑战,这是预先确定的聚类数量,它总是试图创建相同大小的聚类。为了解决这两个挑战,我们可以选择分层聚类算法,因为在这种算法中,我们不需要知道预先定义的聚类数量。
在这个主题中,我们将讨论Agglomerative分层聚类算法。
Agglomerative层次聚类
聚类分层聚类算法是HCA的一个流行的例子。为了将数据集分组到集群中,它遵循自下而上的方法。它的意思是,这个算法一开始把每个数据集看作一个单独的集群,然后开始把最近的一对集群组合在一起,它一直这样做,直到所有的集群被合并到一个包含所有数据集的集群中。
这种聚类层次结构以树状图的形式表示。
Agglomerative层次聚类是如何工作的?
AHC算法的工作原理可以用以下步骤来解释:
- 第 1 步:将每个数据点创建为一个集群,假设有 N 个数据点,那么聚类的数量也将是 N。
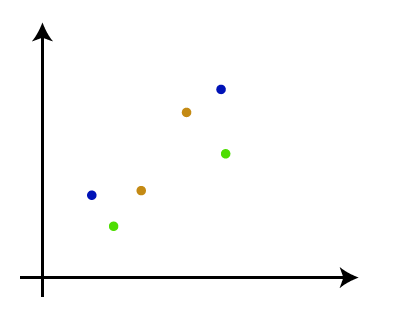
- 第 2 步:取两个最接近的数据点或簇,合并它们形成一个簇。因此,现在将有 N-1 个集群。
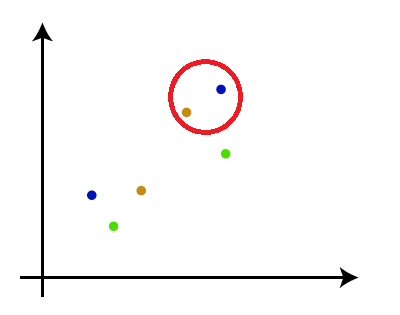
- 第 3 步:同样,取两个最近的集群并将它们合并在一起形成一个集群。将有 N-2 个集群。
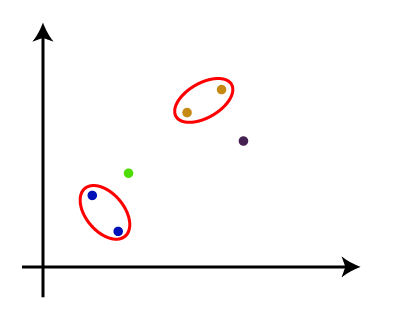
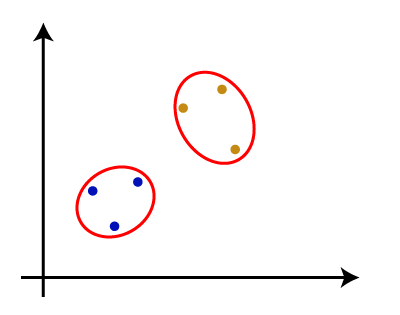
- 第 4 步:重复第三步,直到只剩下一个集群。因此,我们将得到以下集群。考虑以下图像:

- 第 5 步:一旦所有集群组合成一个大集群,开发树状图以根据问题划分集群。
测量两个聚类之间的距离
正如我们所看到的,两个聚类之间的最近距离对于分层聚类是至关重要的。计算两个聚类之间的距离有多种方法,这些方法决定了聚类的规则,这些度量称为Linkage方法,下面是一些流行的链接方法:
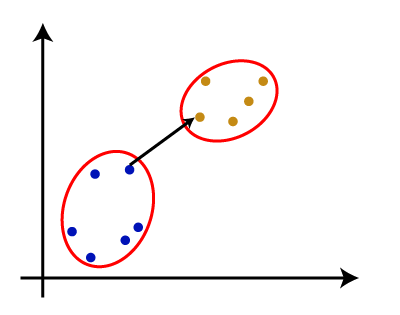
- 1.Single Linkage:聚类中最近点之间的最短距离。考虑下图:
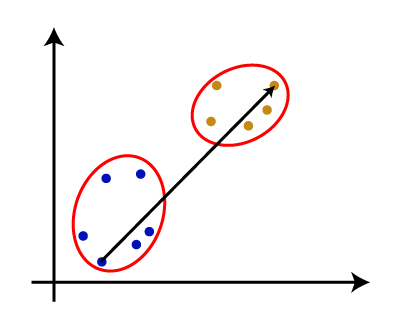
- 2.Complete Linkage:是两个不同集群的两点之间的最远距离。它是一种流行的链接方法,因为它形成比单链接更紧密的集群。
- 3.Average Linkage:将每对数据集之间的距离相加,然后除以数据集总数,计算出两个聚类之间的平均距离的链接方法,它也是最流行的链接方法之一。
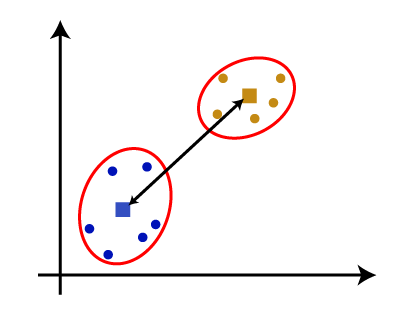
- 4.Centroid Linkage:这是一种计算聚类质心之间距离的链接方法。考虑下图:
从上面给出的方法中,我们可以根据问题的类型或业务需求应用其中的任何一种。
树状图在层次聚类中的工作原理
树状图是一种树状结构,主要用于将每个步骤作为HC算法执行的内存存储。在树状图中,Y轴表示数据点之间的欧氏距离,X轴表示给定数据集的所有数据点。
可以使用下图解释树状图的工作原理:
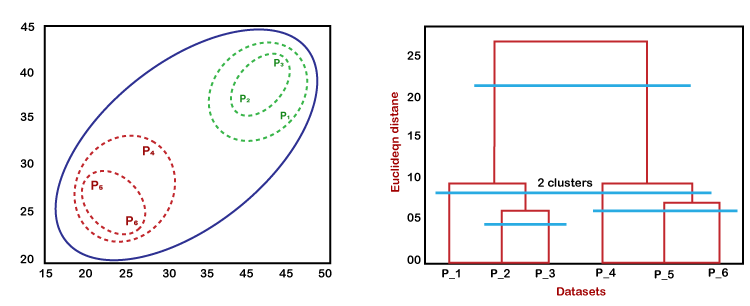
在上图中,左侧部分显示了如何在凝聚聚类中创建集群,右侧部分显示了相应的树状图。
- 正如我们上面所讨论的,首先,数据点 P2 和 P3 组合在一起形成一个簇,相应地创建一个树状图,它以矩形连接 P2 和 P3,高度根据数据点之间的欧氏距离决定。
- 在下一步中,P5 和 P6 形成一个簇,并创建相应的树状图,它比以前的更高,因为 P5 和 P6 之间的欧几里得距离比 P2 和 P3 稍微大一点。
- 同样,创建了两个新的树状图,将 P1、P2 和 P3 组合在一个树状图中,将 P4、P5 和 P6 组合在另一个树状图中。
- 最后,创建将所有数据点组合在一起的最终树状图。
我们可以根据需要在任何级别切割树状图树结构。
Agglomerative层次聚类的Python实现
现在我们将看到使用Python实现Agglomerative聚类算法的实际实现。为了实现这一点,我们将使用在前面的K-means聚类主题中使用的相同的数据集问题,以便我们可以轻松地比较这两个概念。
该数据集包含到购物中心购物的顾客的信息。因此,商场老板希望使用数据集信息找到客户的某些模式或某些特定行为。
使用Python实现AHC的步骤:
实施步骤将与K-means聚类相同,除了一些变化,例如查找聚类数的方法。以下是步骤:
1.数据预处理
2.使用树状图找到最佳簇数
3.训练层次聚类模型
4.可视化集群
步骤1:数据预处理:
在此步骤中,我们将为我们的模型导入库和数据集。
- 导入库
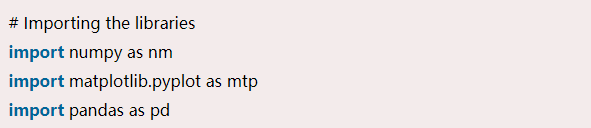
上面几行代码用于导入执行特定任务的库,例如numpy
对于数学运算,matplotlib用于绘制图形或散点图,以及pandas用于导入数据集。
- 导入数据集
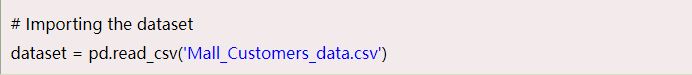
如上所述,我们导入了Mall_Customers_data.csv 的相同数据集,就像我们在 k-means 聚类中所做的那样,考虑以下输出:
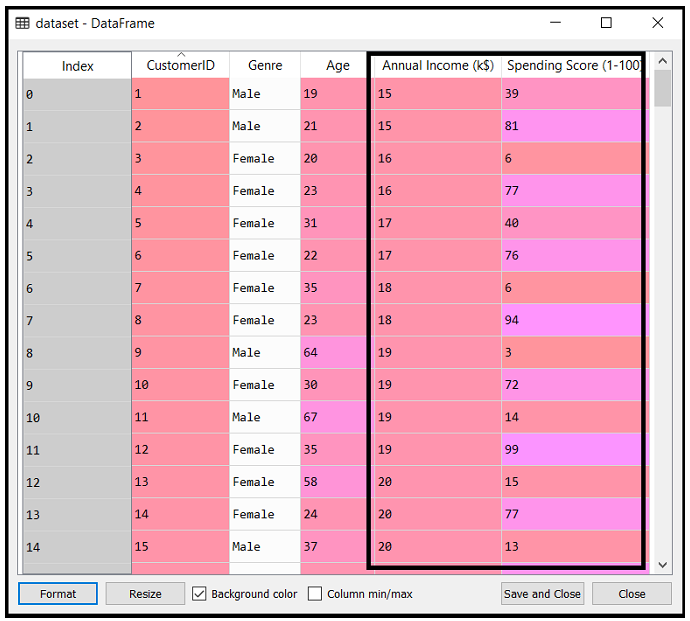
- 提取特征矩阵
这里我们将只提取特征矩阵,因为我们没有关于因变量的任何进一步信息。代码如下:

这里我们只提取了 3 列和 4 列,因为我们将使用 2D 图来查看集群。因此,我们将年收入和支出分数视为特征矩阵。
步骤2:使用树状图寻找最佳集群数量
现在,我们将使用模型的树状图找到最佳的集群数量。为此,我们将使用scipy库,因为它提供了一个函数,将直接返回我们代码的树状图。考虑以下代码行:
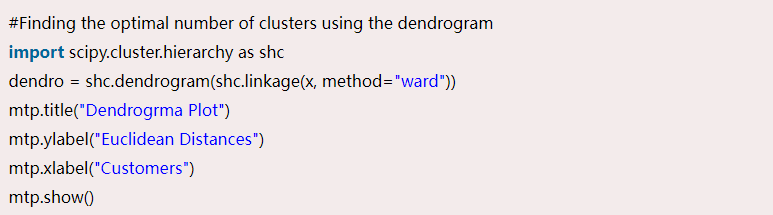
在上面几行代码中,我们导入了scipy库的hierarchy模块。该模块为我们提供了一个方法shc.denrogram(),它将linkage()作为参数。链接函数用于定义两个聚类之间的距离,因此这里我们传递了 x(特征矩阵)和方法“ ward ”,这是层次聚类中流行的链接方法。
其余代码行用于描述树状图的标签。
输出:
通过执行上面的代码行,我们将得到以下输出:
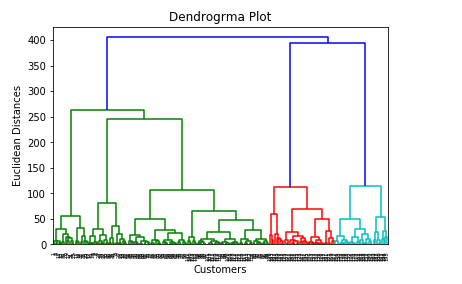
使用此树状图,我们现在将为我们的模型确定最佳聚类数。为此,我们将找到不切割任何水平条的最大垂直距离。参考下图:
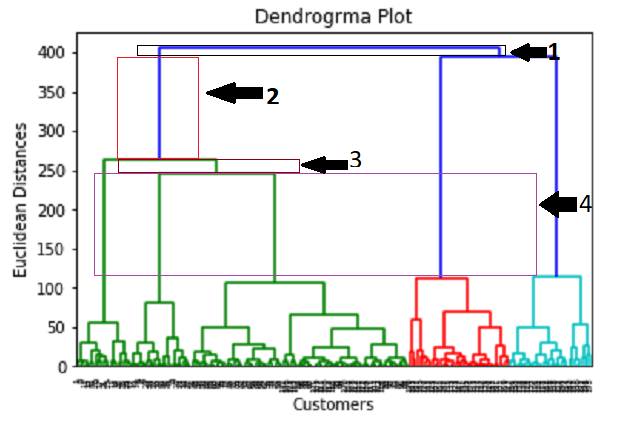
在上图中,我们显示了未切割水平条的垂直距离。正如我们可以想象的那样,第 4个距离看起来最大,因此据此,簇数将为 5(此范围内的垂直线)。我们也可以取第二个数字,因为它大约等于第四个距离,但我们将考虑 5 个聚类,因为我们在 K 均值算法中计算的相同。
因此,最佳簇数为 5,我们将在下一步中使用相同的方法训练模型。
步骤3:训练层次聚类模型
由于我们知道所需的最佳簇数,我们现在可以训练我们的模型。代码如下:
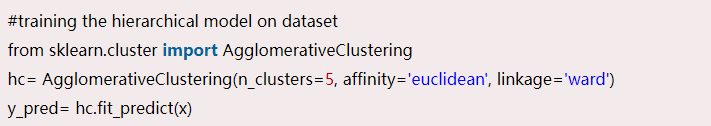
在上面的代码中,我们导入了scikit learn库的集群模块的Agglomerative Clustering类。
然后我们创建了这个类的对象,命名为HC。AgglomerativeClustering 类采用以下参数:
- n_clusters=5:它定义了集群的数量,我们在这里取 5 因为它是集群的最佳数量。
- affinity='euclidean':它是用于计算链接的度量。
- linkage='ward':它定义了链接标准,这里我们使用了“ward”链接。这种方法是我们已经用于创建树状图的流行链接方法。它减少了每个集群中的方差。
在最后一行中,我们创建了因变量 y_pred 来拟合或训练模型。它不仅训练模型,还返回每个数据点所属的集群。
执行上述代码行后,如果我们通过 Sypder IDE 中的变量浏览器选项,我们可以检查 y_pred 变量。我们可以将原始数据集与 y_pred 变量进行比较。参考下图:
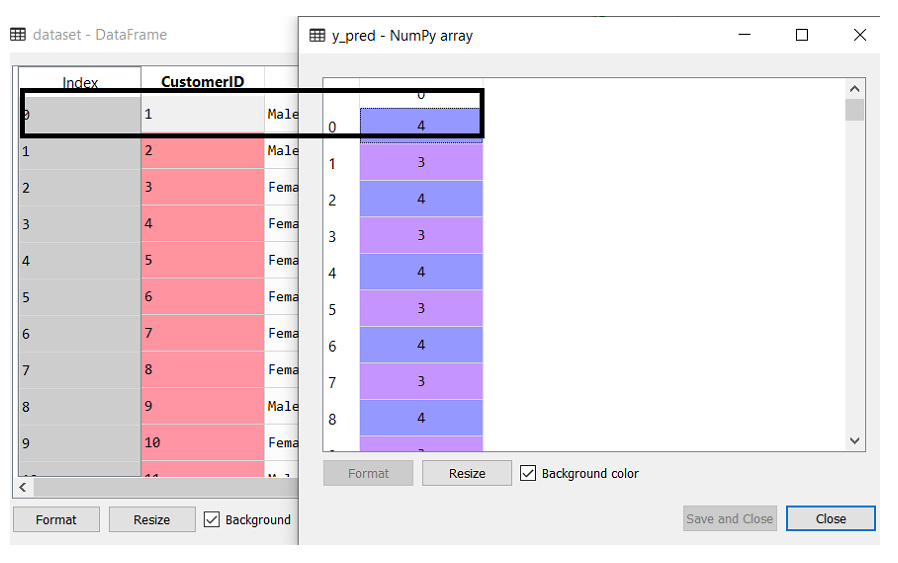
正如我们在上图中看到的,y_pred显示了聚类值,这意味着客户 id 1 属于第 5个聚类(因为索引从 0 开始,所以 4 表示第 5个聚类),客户 id 2 属于 4 th集群,依此类推。
第 4 步:可视化集群
由于我们已经成功地训练了我们的模型,现在我们可以可视化与数据集对应的集群。
这里我们将使用与 k-means 聚类中相同的代码行,除了一个变化。这里我们不会绘制我们在 k-means 中所做的质心,因为这里我们使用树状图来确定最佳聚类数。代码如下:
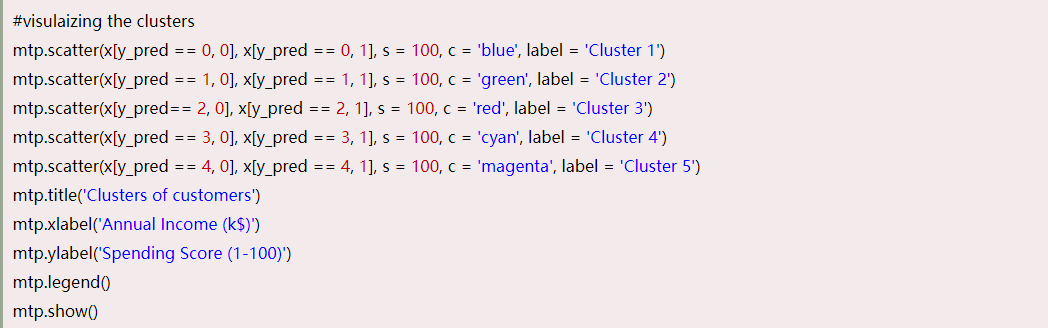
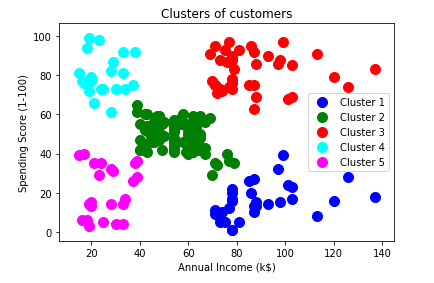
最终输出:通过执行上面的代码行,我们将得到以下输出:
原文链接:https://www.javatpoint.com/hierarchical-clustering-in-machine-learning
---煤油灯科技victorlamp.com翻译整理---