NIALM(非侵入式设备负载监测)可以“感知”使用电力的设备。NIALM用于家庭和小型建筑,为此,NIALM可能需要来自每种设备类型的数百个标记电源信号图像进行训练,但有一种比“传统”机器学习更快、更划算的方法。
来自约翰内斯堡大学的研究人员为NIALM部署了小样本学习(Few Shot Learning ,FSL),经典的FSL只需要10个标记分类的图像,以非常高的准确性识别电器。
他们调整了这一过程,使AI(人工智能神经网络)能够自己选择最好的训练图像,这使得训练过程更快。当他们还调优了一些超参数时,只需7张测试图像就足以让FSL识别出97.83%的设备,一张训练图像(一次性学习)的准确率在88.17到91.343%之间,这取决于测试期间的类数。
目前他们的研究发表在《计算智能与神经科学》《Computational Intelligence and Neuroscience.》上。
FSL:当机器学会学习时
教人工智能识别设备的电源信号通常需要大量的数据。通常情况下,人工智能将需要数百张由人类标记的图像,以识别每种设备类型,尽管其功能和运行状态不同,一个设备的两种运行状态的例子是洗衣机的洗涤和旋转循环。
人工智能的所有训练数据都必须由人类创建和标记,这就会变得缓慢和昂贵。
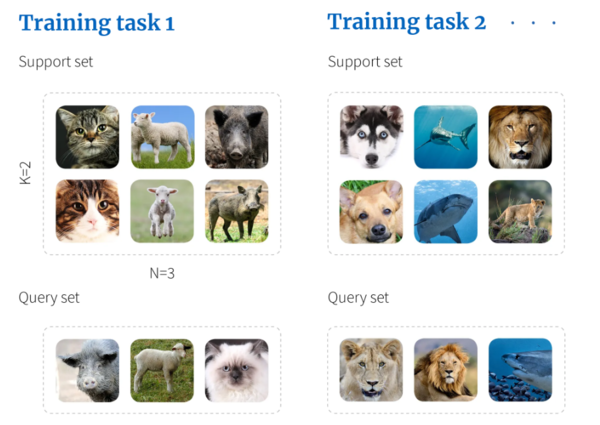
但还有一种方法可以让人工智能学习,只需要很少的标记数据,只需10个标记的训练图像就足以进行具有极高精确度的图像分类。
例如,假设一个人工智能用大象、老虎和熊各10张图像来训练,当AI使用未标记的大型雄狮图像进行测试时,AI应该识别出狮子与老虎相似,但又不相同,然后AI应该自己决定为狮子创建一个新的对象类。
此外,当人工智能面对一只幼狮的未标记图像时,它应该能够将幼狮与雄狮归为同一类。
这种类型的AI机器学习(ML)算法被称为小样本学习(FSL),它是元学习或“学会学习”的一种形式。
FSL 已经为占主导地位的全球科技公司提供了巨大的语言模型,在一些机场检查护照与旅客面部的计算机视觉系统也使用 FSL。
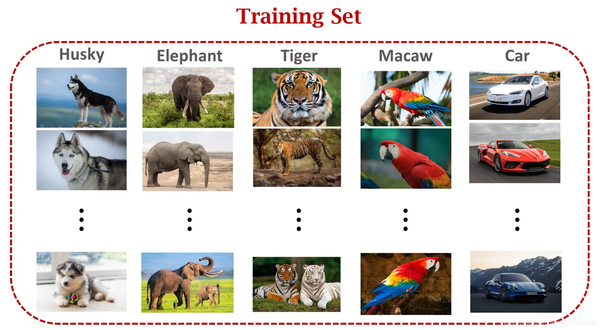
UJ 电气与电子工程科学系的 Yanxia Sun教授表示,“小样本学习”实际上是用一些数据训练人工智能神经网络,甚至是关于对象类的不完全数据。” Sun是这项研究的第一作者。
“当我们用训练过的图像训练神经网络时,人工智能会自己学习每个动物或物体的特征。”
在老虎对狮子的例子中,FSL AI从老虎的图像中学习胡须、猫的眼睛、皮毛和猫的尾巴,它以前从未见过狮子,但当AI使用狮子的图像进行测试时,它应该将狮子识别为与老虎相似但不相同的对象类。
NIALM:用于许多电器的一个功耗表
NIALM用于小型商业建筑或家庭,用来测量每一个电器或设备的耗电量。
NIALM使用功率分解来分离在同一时间、同一电气相位上打开的许多设备的组合功耗信号。NIALM只使用一种测量设备,这比把电能表依次连接到每个电器上要容易得多,也快得多。
在一些国家,家用智能电表会储存每件电器的耗电量数据,并将其发送给电力公司。在其他国家,智能电表也能让房主获得能源消耗数据。
功率消耗信号转数字图像
在这项研究中,研究人员在各种家用电器的电力负载信号的NIALM图像上训练他们的FSL AI。
他们通过插入功率分析仪(Tektronix PA1000)和每个设备依次变成一个多插头电源扩展来获得功耗信号,然后他们打开了功率分析仪,然后打开和关闭设备,同时功率分析仪记录随时间的功耗,对于笔记本电脑和台式电脑,整个启动序列都被记录下来。
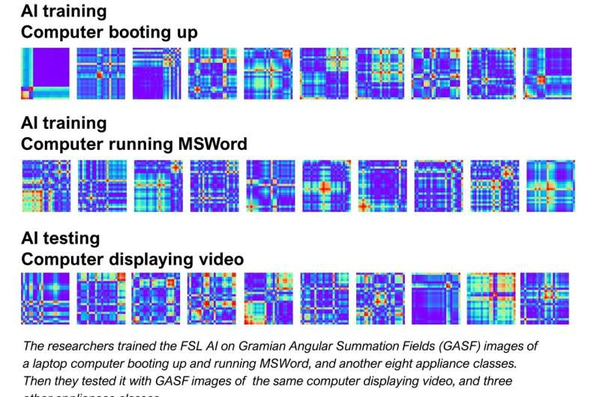
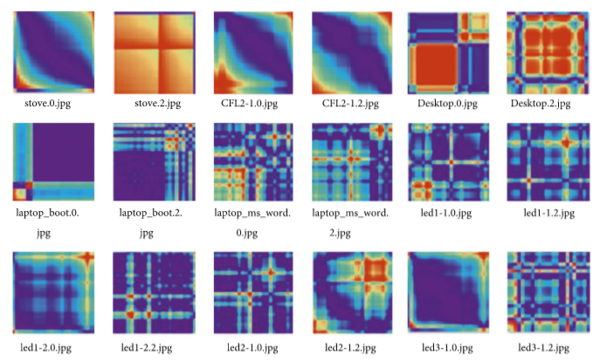
功率分析仪将电器的模拟功耗信号转换为数字数据,然后将该数据转换为格拉姆角求和场 (GASF),它看起来像色彩鲜艳的瓷砖。
然后将 400 X 400 像素的彩色 GASF 图像转换为灰度图像,并将尺寸缩小为 28 X 28 像素,这降低了算法的复杂性并使用了更少的计算资源。
加快训练
经典的FSL是一个两阶段的过程——训练和测试。在这项研究中,研究人员增加了一个微调,以加快选择非常适合训练的数据,这也将加快训练过程本身。
“我们通过对我们的数据用于度量学习的易用性或适用性进行初步评估,提高了FSL算法的准确性。我们称之为相似度测试,”该研究的作者Liston Matindife博士说。
在研究期间,Matindife是约翰内斯堡大学的博士研究生,他目前在津巴布韦国立科技大学任教。
“如果一个GASF图像没有通过相似度测试,这意味着在转换成GASF图像之前,数据需要更多的预处理,特别是在时间序列或波形格式,通过相似性测试的图像使我们的模型学习得更快。”Matindif补充道。
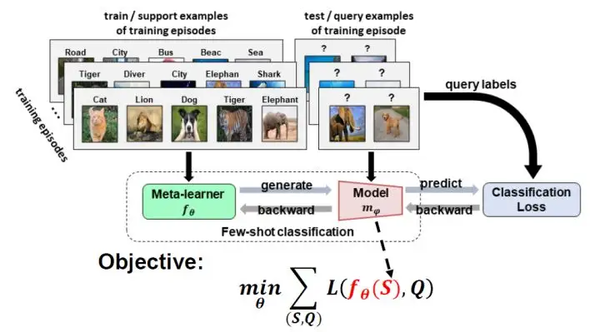
小样本学习方法(FSL)演变过程
训练和测试FSL AI
为了训练FSL AI,研究人员给它输入了研究中14类家电中的10类的GASF图像,他们使用每个家电类的10张图片:一台正在开机的笔记本电脑、一台运行MSWord的笔记本电脑、一台台式电脑、一台冰箱、一个两板炉和各种低能耗灯。
然后,他们对FSL AI进行了测试,看它在识别或分类家电方面的学习情况如何,还学会了为从未见过的电器创建新类。
在测试中,他们向FSL AI输入了4个新类别的图像,每个类别10个图像:显示视频的笔记本电脑、微波炉、水壶和紧凑型荧光灯(CFL)。
精度高,图像少
在笔记本电脑测试图像的情况下,FSL算法对来自笔记本电脑功耗信号的测试图像进行分类(识别)的准确率为97.83%,但处于新的工作状态,这个新的操作状态是显示视频,而不是像训练图像中那样启动或运行MSWord。
FSL AI仅用7张用于启动的测试图像和另外7张用于运行MS Word的测试图像就达到了这一精度。
从小样本学习到单样本学习
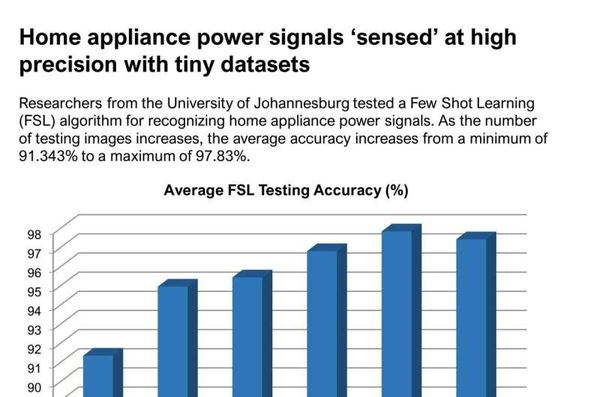
研究人员还改变了训练图像的数量,然后测量算法的分类精度。测试结果表明,随着每个类测试图像数量的增加,平均准确率从最低的91.343%提高到最高的97.83%,这表明FSL可以应用于NIALM的识别。
“NIALM算法的开发是数据广泛的,对于具有不同激活周期的设备,我们将为每个设备生成不同数量的数据集图像。不同设备的训练图像数量的不平衡通常会影响训练算法,”Matindife说。
“我们的算法减少了设备特定数据的昂贵获取需求,使用原型网络FSL算法可以毫无困难地输入具有不同数量样本图像的设备数据集,”他补充说。
该研究表明,当使用基于计算机视觉的Siamese和原型FSL算法应用于GASF图时,每个类只需要一张训练图像就可以达到90%的平均准确率。当一个训练图像得到足够的精度时,称为单样本学习,Matindif说,单样本学习可以解决NIALM中的一个巨大挑战——需要大量的训练图像。
这种FSL NIALM AI可以用来识别那些无法正常工作的高价值电器, Sun说,例如电脑或冰箱的电源或压缩机电机开始缓慢地走向故障。
一个FSL人工智能可以通过一些功能良好的家用冰箱的电源信号图像进行训练,第一个冰箱是A品牌,容量是B。
她说,然后,在家庭或小型商业建筑中,如果人工智能看到一台带有C品牌和容量D的压缩机电机问题的家用冰箱的电源信号,它应该能够标记出第二台电器的电源信号有问题。
原文链接:https://techxplore.com/news/2022-11-few-shot-ai-accurately-home-appliances.html
论文链接:https://www.hindawi.com/journals/cin/2022/2142935/
---煤油灯科技victorlamp.com翻译整理---
