摘要
随着深度学习模型变得越来越大、越来越复杂,稀疏性可以说是探索效率和可扩展性的最关键维度。毕竟,深度学习从中汲取灵感的生物神经网络自然是稀疏且高效的。
我们提倡通过一种名为 Tensor-with-Sparsity-Attribute (TeSA) 的新抽象来构建稀疏模型的端到端方法,该抽象增强了从根本上为密集模型设计的默认 Tensor 抽象。TeSA 能够指定稀疏属性和模式(例如,用于修剪和量化),在整个深度学习模型中向前和向后传播,并用于创建高效、专业的算子,同时考虑不同稀疏模式的执行效率在不同的(稀疏感知)硬件上。由此产生的 SpartTA 框架可以适应各种稀疏模式和优化技术,与具有更小内存占用的七种最先进(稀疏)解决方案相比,推理延迟平均加速 1.7 倍至 8.4 倍。作为一个端到端的模型稀疏框架。
1 介绍
随着深度神经网络(deep neural network, DNN)模型变得庞大和复杂,为了提高效率,它们不可避免地会变得稀疏,正如高度稀疏的生物神经网络所表现的那样。一个DNN模型通常被建模为一个数据流图(DFG),其中每个节点是一个具有一个或多个输入和输出张量的操作符。模型稀疏性包括在张量上引入一些稀疏模式;例如,量化一些精度较低的张量(例如,16位到8位);通过将某些张量的某些(或全部)部分的值设为零(如块稀疏度或细粒度稀疏度)来修剪模型;或将修剪与量化相结合应用于模型。通过仔细的修剪和量化,可以将DNN模型压缩到更小的内存占用空间,而不会失去太多的准确性。通过为稀疏模式定制的DNN操作符,得到的模型有望具有更低的推理延迟。
不幸的是,深度学习系统还不能有效地利用稀疏性:由于各种原因,稀疏性的增加可能无法转化为效率的实际提高。首先,一般稀疏操作的计算核还远远没有达到最优。例如,cuSPARSE用于稀疏矩阵操作的CUDA库,已被证明不如cuBLAS,它的密集对等体,即使在矩阵的稀疏性达到98%(表1)。其次,由于DNN计算通常需要多个阶段,稀疏性模式可能会在各个阶段发生显著变化,使得很难开发稀疏感知优化端到端增益。最后,任何有效的稀疏感知优化都可能涉及到跨垂直堆栈的额外支持,从深度学习框架、编译器、优化器、操作符和内核,一直到硬件。任何层次的支持不足都可能导致效率低下。
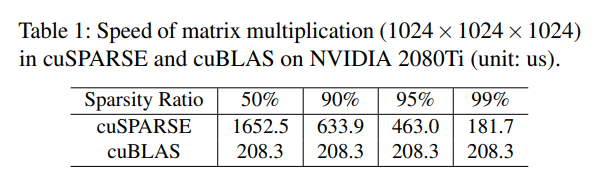
表1 在NVIDIA 2080Ti上使用cuSPARSE和cuBLAS的矩阵乘法速度(1024×1024×1024)(单位:us)。
因此,我们提出了SparTA,一个新的框架,将稀疏视为首要,并遵循以下设计原则。该设计是可定制和可扩展的,以适应新的创新模型稀疏性;它是端到端的覆盖整个栈,而不是局限于一个操作符或一个层;它的目标是在不牺牲普遍适用性的前提下达到极致的性能;它可以促进现有的稀疏算法更有效地探索稀疏模型。
SparTA的核心是一个新的抽象,即TeSA,它增加了标准张量的属性来描述稀疏性和模式。示例包括低精度权重、块(结构化)稀疏性和细粒度(非结构化)稀疏性。一套TeSA传播规则指导稀疏性属性的向前和向后传播,实现端到端覆盖。规则可以由提出的TeSA代数定义,也可以以概率的方式推断。
利用TeSA中的稀疏属性,SparTA可以在一定的稀疏模式和条件下,考虑到稀疏感知硬件和特定的稀疏算子/核,生成一个高效的执行计划。SparTA可以转换执行计划,将复杂的稀疏性属性分解为已知有效优化的简单属性的组合。在执行计划中,SparTA可以执行代码专门化,为简单而规则的稀疏属性生成高效的内核,而不是诉诸于通用但效率较低的稀疏内核,这就是SparTA如何在不牺牲一般性的情况下获得极大的效率。
由于全栈支持(一直到加速器上的代码生成器),SparTA能够提供最基本的性能指标(例如,延迟),可以帮助评估具有固定稀疏属性的TeSA的不同执行计划,并为实践者提供有价值的反馈,以便在性能和准确性之间寻找理想的稀疏属性集。
SparTA是高度可定制和可扩展的。使用TeSA,我们可以定义新的稀疏性属性和模式,用于开发稀疏性的新方法,提供新的TeSA传播规则,并合并新的稀疏感知算子、内核和(稀疏感知)硬件加速器。
我们已经实现了基于Rammer的SparTA, Rammer是一种最先进的开源DNN编译器,对稀疏性没有特殊的支持。我们在三种常见的DNN模型上(即CUDA GPU, ROCm GPU,Intel CPU)对SparTA进行了广泛的评估。我们的评估表明,与7个最先进的解决方案相比,SparTA在模型推断延迟方面的平均速度提高了8.4倍,而内存消耗更少。我们还使用SparTA来加快稀疏DNN模型的训练速度,比之前的解决方案提高了2倍以上。通过开源SparTA1,我们希望这项工作可以将社区聚集在这个可扩展和统一的框架中,以加速模型稀疏性的创新。
2 背景与动机
在过去的几年里,深度神经网络的规模显著增长,这带来了较大的推理延迟和沉重的记忆负担,模型稀疏性可以说是探索效率和可伸缩性的最关键维度。
- Various forms of sparsity 各种形式的稀疏。深度学习模型的稀疏性是一个活跃而被广泛研究的研究课题。目前,有多种稀疏模式正在研究中。结构化(粗粒度)稀疏,包括通道粒度稀疏和块稀疏,涉及到修剪与某些运算符相关的通道或张量的子块(如权值或激活张量)。使用非结构化(细粒度)稀疏性,张量的任何元素都可以被修剪。量化算法表示不同精度级别的模型(例如,二值化模型、8位模型),甚至跨神经网络层或单个张量的混合精度不同。一些研究进一步将修剪和量化相结合,以在严格的延迟和内存约束下获得较高的精度。总的来说,修剪和量化已经被证明可以有效地降低某些深度学习模型的规模和计算复杂度,有时可以降低10倍以上,而不损失很多精度。
- The myth of FLOPs FLOPs的神话。模型稀疏性并不能直接转化为性能优势。现有的使用“代理度量”(例如FLOPs或浮点操作)来评估其建议的效果(如模型推断延迟)的实践是有缺陷的,会导致不准确的结果。例如,当使用细粒度稀疏性将一个操作符的权值修剪50%时,即使在理论上它的FLOPs可以减少一半,但使用默认的稀疏内核,实际的推理延迟可能会更高。
原因之一是当前通用稀疏核的实现不够理想。一个通用的稀疏内核倾向于对任何稀疏张量应用一些默认的稀疏编码方案(例如,压缩稀疏行)。这可能会在具有特定稀疏模式(如结构化稀疏)的张量中错过优化机会。因此,像cuSPARSE这样的通用稀疏内核库可以超过密集内核库cuBLAS,只有在某些极端稀疏的情况下(98%),如表1所示。这促使我们需要找到一个通用的框架来实现为个别稀疏性方案量身定制的专用内核。
- The diminishing end-to-end returns 端到端回报递减。稀疏性算法通常专注于探索某一DNN算子的稀疏性(如卷积)。然而,当放置在一个端到端深度学习模型中,整个模型的稀疏模式可能会受到模型中每个算子的影响。这可能会引入复杂的稀疏模式,使现有的解决方案难以理解或优化,导致稀疏性带来的端到端回报递减。
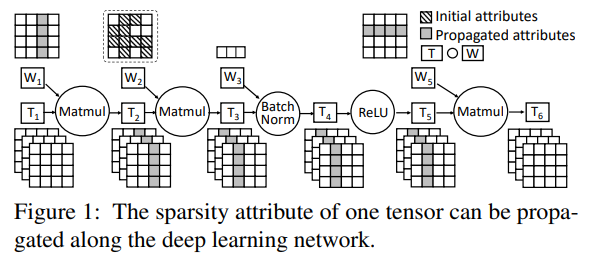
图1 一个张量的稀疏性属性可以沿着深度学习网络传播
在图1中,张量W 说明了一个细粒度稀疏模式(63%稀疏)。W 的这种初始稀疏模式会引起连锁反应。W 将稀疏属性传播到下游和上游张量,包括W 、T 、T 、T 、T 和W 。例如,因为W2的第二列被修剪,T 的第二列注定为零,因此也可以被修剪(如T ×W = T )。同样,当W 的第三行被修剪后,T 的第三列也可以被修剪。因此,深度学习编译器需要理解这种稀疏性的传播,以便进一步进行稀疏感知优化。
- Across-stack sparsity innovations in silos 竖井中的跨堆栈稀疏性创新。由于上述限制,稀疏性创新要么局限于个体算子,在不知道端到端效果的情况下使用代理指标进行评估,要么必须在少数几个神经模型上手工实现,难以移植到其他模型。更麻烦的是,单个解决方案难以扩展或与其他方案结合。所有这些都激励着SparTA,一个促进稀缺性创新的共同基础,它可以被端到端的评估。
3 SparTA的设计
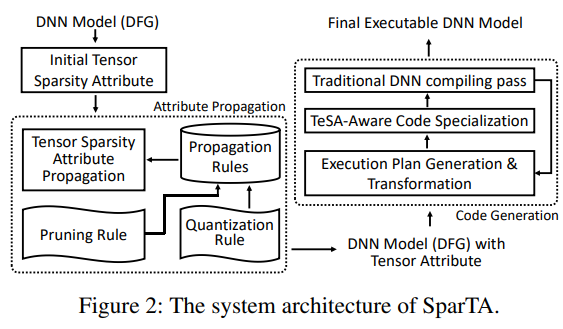
图2:SparTA的系统架构
图2总结了SparTA的整体架构。SparTA的核心是TeSA抽象,它在已有的张量抽象基础上增加了稀疏性属性。算法设计者可以指定深度学习模型中所选张量的稀疏模式为“初始张量稀疏属性”。
给定初始的稀疏性属性,SparTA进行属性传播,根据传播规则推断出深度学习模型中所有其他张量的稀疏性属性。稀疏性属性传播比原始稀疏张量暴露出更多的优化机会,如图1所示。
在属性传播之后,SparTA运行一个多道编译过程来生成高效的端到端代码。与传统的DNN编译器相比,SparTA进行了两次额外的编译以充分利用模型的稀疏性。第一步将DNN模型的原始执行计划转换为利用给定稀疏模式的新执行计划。然后,进一步的编译过程执行稀疏感知的代码专门化。对张量稀疏性模式的意识允许SparTA生成高度定制的代码。这个过程可以反复进行,以进一步改进。
最后,使用最终编译的代码,模型设计人员可以分析DNN模型,以获得真实的性能指标,包括内存消耗和推断延迟。有了反馈,模型设计者可以进一步更新某些张量中的稀疏性属性,并迭代地重复这个过程以找到最佳折衷。因此SparTA使反馈回路成为可能,促进了模型稀疏性的创新。
3.1 TeSA抽象
TeSA将一个传统张量增宽为一个具有相同形状的额外张量,其中每个元素都是标量值,表示原始张量中相应元素的稀疏性属性。这允许用户在一个张量中指定任意的稀疏模式,这是模型稀疏性研究的一个关键要求。图3显示了TeSA的一个示例。左边是原始稠密张量。右边显示了相应的稀疏性属性,其中修剪张量的第二行,使用8位量化右下角的元素,4位量化其余的元素。这个例子表明,TeSA可以在一个抽象中统一张量量化和剪枝。统一的抽象有利于剪枝和量化的协同优化,例如:,选择合适的块大小来覆盖(表示)剩余的(非修剪的)元素,同时与低位硬件指令(例如,wmma)对齐。使用TeSA, SparTA可以在编译时理解稀疏模式,从而支持进一步的优化。注意,稀疏属性只会在编译阶段使用,因此它不会给实际的计算阶段带来额外的资源负担。
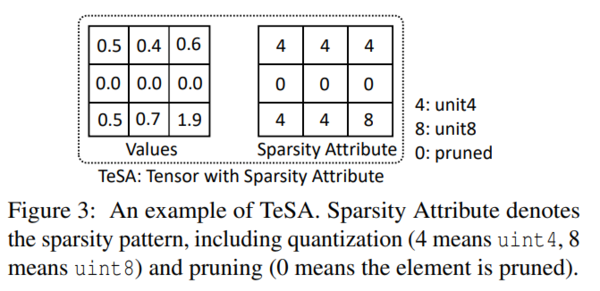
图3 以TeSA为例,稀疏性属性表示稀疏性模式,包括量化(4代表uint4, 8代表uint8)和剪枝(0代表元素被剪枝)
3.2 稀疏性属性传播
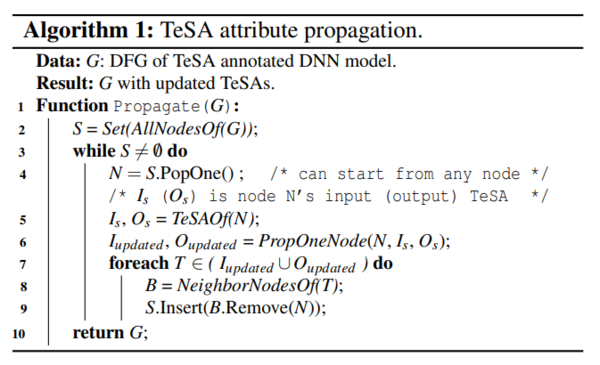
深度学习模型中的张量通常很大,用户只能为张量的一个子集设置稀疏性属性。为了最大化端到端稀疏性,SparTA沿着DNN模型的DFG进行属性传播,推导出其他张量的TeSA,如算法1所示。给定一个节点,如果一个节点的任何输入或输出张量的TeSA被更新(第5行是TeSAOf),那么根据一定的传播规则(稍后讨论,传播可以是双向的),PropOneNode(第6行)更新与该节点相关的其他张量的TeSA,传播重复,直到没有TeSA需要进一步更新为止。
算法1:TeSA属性传播
注意,如果被传播多次,稀疏性属性将被更新以增加稀疏性,直到收敛。多个剪枝更新会导致所有更新中剪枝元素的并集(图4(c)中的张量W 就是一个例子)。对于量化,属性将收敛到最少的量化位(或0位,即被修剪)。由于每次传播都是单调地增加稀疏性,且修剪和量化的传播都是交换性和结合性的,算法1保证终止。
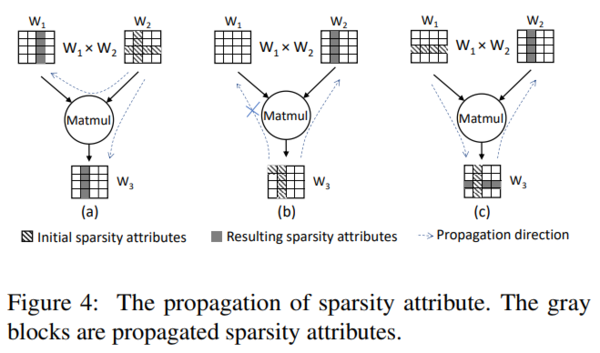
图4:稀疏性属性的传播,灰色块是传播稀疏性属性
- Intra-operator传播。在不同类型的算子和属性中,PropOneNode 的传播行为是不同的。在图4(b)中,张量W 中修剪P后的元素[0,0]不能通过运算符Matmul传播到W 和W ,而如果运算符是像ReLU这样的单元级计算,则可以传播到上游张量,传播可以是双向的。图4(a)显示输入W 可以影响输出W 和另一个输入W 。在图4(b)中,由于输出W 的TeSA, W 变得稀疏。
量化类型的稀疏性属性传播方式不同。如果一个输出张量精度较低(如4bit),而输入张量精度较高(如16bit),则输入可能使用较少的量化位,对输出的影响较小(如信息瓶颈)。
接下来,我们展示了SparTA用于裁剪和量化属性的两个传播规则。请注意,可以像算法2的第27行-第36行那样扩展PropOneNode以支持更多的规则,新的传播规则可以在PropOneNode中注册和调用。
- Pruning rule 修剪规则。剪枝属性的传播依赖于运算符的计算逻辑(如Matmul中的+、×)。为了获取这样的属性,SparTA定义了一个TeSA代数,它将算子的元素级计算映射到一个包含两个元素的集合, {pruned, non-pruned}{修剪,非修剪}。TeSA代数如表2所示。给定一个输入TeSA,它的输出TeSA可以使用TeSA代数计算,遵循与操作符相同的计算流程。注意,可以对表2进行扩展以支持新的操作符。
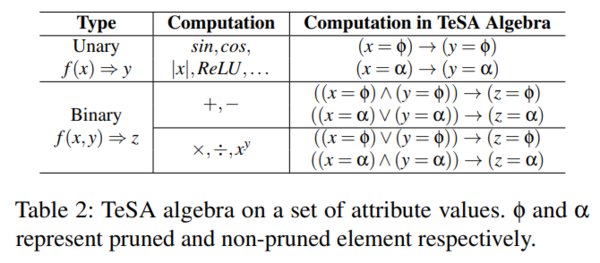
表2:关于一组属性值的TeSA代数,φ和α分别表示修剪过的和未修剪过的元素
SparTA还提出张量置乱(Tensor Scrambling),这是一种概率传播规则,用于处理黑匣子或复杂运算子,在这些情况下,详细的计算逻辑不可用或不明确。该规则通过置乱其他相关张量的值来得到张量的剪枝元素。具体来说,该规则将输入张量中经过修剪的元素设置为0,并将随机值赋给其余元素(即置乱)。然后它运行运算子来获得它的输出张量(假设至少有稠密版的运算可用)。通过多次重复这个过程,该规则将那些始终保持为0的元素视为输出张量中修剪过的元素。
此外,稀疏性也从输出传播到输入,或者从一个输入张量传播到另一个。为了实现这一点,SparTA利用了DNN计算的自动分化(AD)。运算子的向后运算子也可用于AD中的反向传播。让I 和O 分别表示运算的输入和输出。它的反向运算的输入是I 和gO,其输出为gI ,前缀g表示对应张量的梯度。根据AD的属性,gI 和gO 应该具有I 和O 相同的TeSA(形状和价值)。为了推断TeSA从张量I (或O )传播到I , SparTA将TeSA代数或张量置乱应用到向后算子:使用I 的TeSAs和gO 作为输入,SparTA应用这两种规则来计算(PropOneNode)gI 的TeSA,它的形状和值与I 相同
修剪后元素的传播规律可以在算法2的第11行实现。计算节点N的每个输入/输出TeSA(第14行),即将其他TeSA(即(i ∪O )\T)中的稀疏度传播到这个TeSA(即T)。该函数分别返回更新后的输入和输出TeSA(即第17行)。注意这里张量置乱可以用张量代数代替。
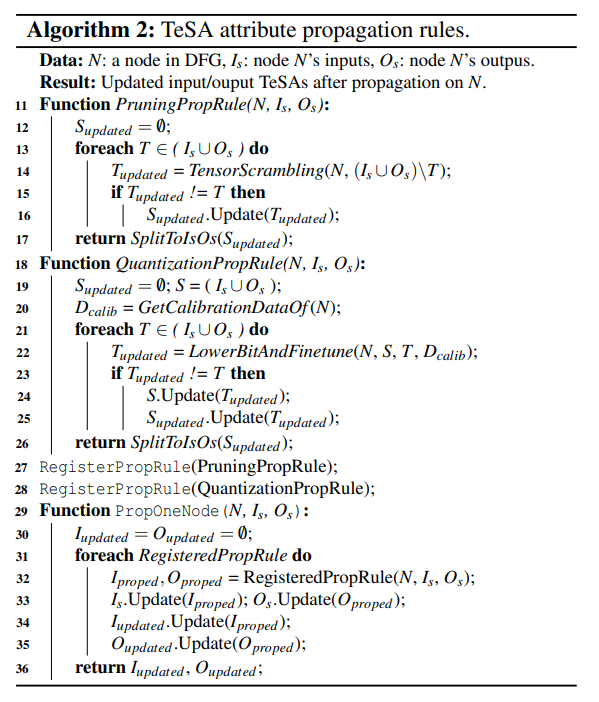
算法2:TeSA属性传播规则
- Quantization rule量化规则。对于量化属性的传播,关键是找到不必要的高量化精度的张量。SparTA定义了一个量化规则(算法2的第18行),它借用了知识蒸馏的思想来识别这些张量,即确定通过算子传递的信息是否可以被提炼成精度较低、信息损失可接受的信息。由于信息损失可以通过算子的输入和输出张量来测量,所以我们首先使用train/test数据集对对应的DNN模型进行推理,并收集该算子的输入和输出张量结果来构建校准数据(第20行)。接下来,我们逐渐降低这个算子的一个张量的量化精度(例如,32位到16位),同时保持其他张量不变。然后,在新的精度下,利用校准数据对操作员进行量化和微调。微调是降低精度后,使校准数据中输出张量与该算子输出张量之间的均方误差(Mean Squared Error, MSE)最小。如果模型精度下降小于预定义的阈值(例如,在我们的实验中为1%),则接受该操作符的新的量化属性(第22行)。对运算符中的其他张量重复这个过程,直到所有张量都求值为止。为了减少收集校准数据的成本,SparTA在DNN模型中按拓扑顺序遍历所有算子,并缓存在早期量化传播中计算的激活。收集操作符的校准数据只需要从最近的缓存激活到该操作符的部分推断。例如,考虑一个有两层L 和L 的序列模型。L 上的传播在其校准数据中收集了其输出激活。在对L 进行工作时,可以通过收集到的L 的输出激活进行部分推断来收集其校准数据。
3.3 使用TeSA生成代码
经过属性传播后,DNN模型中的张量可能呈现出不同稀疏模式的混合。这种复杂的模式使得生成有效的内核代码变得困难。因此SparTA将一个具有复杂稀疏模式的张量转换为多个张量,每个张量具有更简单的稀疏模式。相应地,SparTA重写了相关算子的执行计划,以适应计算变换张量的新算子。最后,SparTA使用稀疏感知专门化,为转换后的执行计划执行代码生成。
图5显示了Matmul这种两步编译过程的示例。权张量W是一个具有混合精度的张量,其中两个结构化块使用8位量化,一个细粒度元素使用32位量化。SparTA将W转换为W 和W ,每个都使用更简单的量子化方案。为此,引入了两种算子,分别对W ×I和W ×I进行计算,并采用适合于稀疏性属性的硬件指令。结果,原来只有一个算子的执行计划变成了一个需要更多张量操作的新计划。
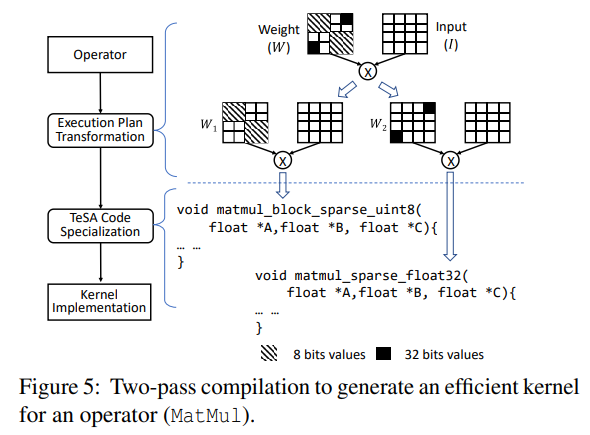
- Execution-plan transformation 执行计划的转变。这个编译过程将具有复杂稀疏模式的张量转换为“规则的”(简单的)稀疏模式,这有助于在以后的编译过程中进行进一步的优化。在SparTA中,规则稀疏模式意味着一个张量的TeSA只显示一种量化属性和一个块大小的剪枝属性。
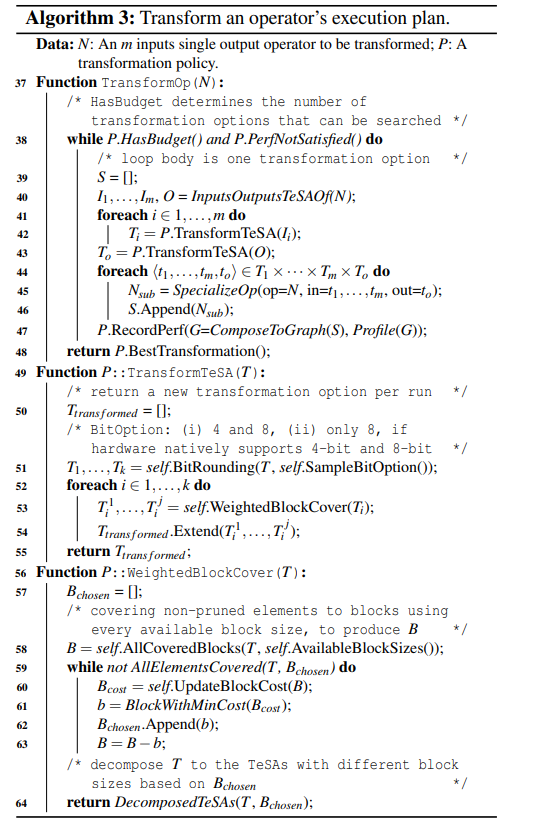
一个DNN模型的详细执行计划转换是逐个操作员执行的,如算法3所示。为了简单起见,我们假设该算子有m个输入和一个输出。该过程从算子的输入和输出TeSAs开始,使用TransformTeSA可以将每个TeSAs转换为一个或多个TeSAs。对应地,将算符转化为| T |∏ |T |子算符,即分解后的这些TeSAs的笛卡尔积。子算子通常与原始算子具有相同的计算逻辑(如可以用爱因斯坦求和表示的算子),这种方法在DNN模型划分中也被采用。系统为每个子算子执行代码生成(第45行),分析实际硬件中产生的内核,并记录分析结果(第47行)。
注意,转换是一个重复的搜索过程。给定一个TeSA, TransformTeSA可能有多个转换计划。该过程遍历每个计划以找到满意的计划(第38行)。图6显示了一个示例。在左边,一个混合精度的TeSA可以分解为多个TeSA,每个TeSA有一个精度。它还可以转换为一个TeSA,其中所有元素都对齐到最高精度。同样的,对于正确的例子,稀疏的TeSA可以分解为两个TeSA,一个块大小为2x2,另一个块大小为1x1。它也可以被转换为一个块大小为2x2的TeSA,并将修剪后的元素置为0,或者被转换为一个块大小为1x1的TeSA。需要注意的是,算法可能会决定不分解一个张量,并选择1x1的块大小,这表明TeSA具有细粒度的稀疏性,很难转换为规则稀疏性。
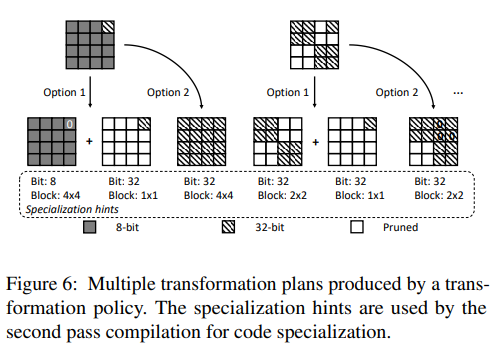
图6:一个转换策略产生的多个转换计划,专门化提示用于代码专门化的第二遍编译
TransformTeSA(第49行)实现了转换TeSA的逻辑。首先,根据TeSA所包含的量化位宽和硬件支持的可能量化位宽,对TeSA进行比特舍入分解。例如,如果硬件同时支持4位和8位指令,那么至少有两个舍入选项:(i)舍入到4位和8位,(ii)全部舍入到8位。对于bit舍入返回的每个TeSA,函数WeightedBlockCover选择一个或多个适当的块大小来覆盖非修剪的元素,我们将其作为一个加权集覆盖问题。每个块大小的权重对应于底层硬件上块大小的计算成本。我们使用一个简单的算法来挑选成本最低的块,直到覆盖所有未修剪的元素(第56行)。
转换策略P可以进一步定制,以纳入新的优化。为了帮助代码生成,每个经过转换的TeSA都附加了有关位宽和块大小的信息,称为专门化提示(如图6所示)。提示将传递给接下来详细阐述的第二次传递。
TeSA code specialization TeSA代码专业化。第二个编译过程专门用于每个算子(即算法3中的第45行)的内核代码。从前一次编译过程中生成的专门化提示指导专门化策略。例如,操作符的位宽建议是否利用特定的硬件指令(例如DP4A)。为了有效地消除死代码(DCE),操作符的循环平铺应该与块大小对齐。此外,SparTA可以利用传统的DNN编译器进行密集计算。例如,某些块内计算是密集的,因此可以使用现有DNN编译器生成的密集实现。
专门化过程从操作符的密集版本开始,实现为由传统DNN编译器生成的多级循环。它首先在专门化提示中的块大小指导下专门化。它从最外层循环开始搜索,直到内部循环体的级别与块大小对齐。由于修剪稀疏性属性是在块大小的粒度上指定的,所以在l级内的许多循环体运行都是死计算。为了消除死计算,我们引入了一种新的调度原语分解,它联合执行循环展开和DCE。当在一个回路上应用拆卸时,这个回路及其所有外部回路都是展开的,并具有给定的稀疏属性。图7(b)显示了一个示例。在第三个环上应用拆卸,从而展开前三个环,产生8个小Matmuls(即[2,2]x[2,2])。根据图7(a)的稀疏模式,其中6个是死计算,可以被消除。本质上,拆解将一种特定的稀疏模式嵌入到代码中,从而消除了对稀疏编码的需要,例如,压缩稀疏行(CSR)。由于对非修剪块/元素的索引在代码中是专用的,因此删除了对索引进行间接寻址的开销。
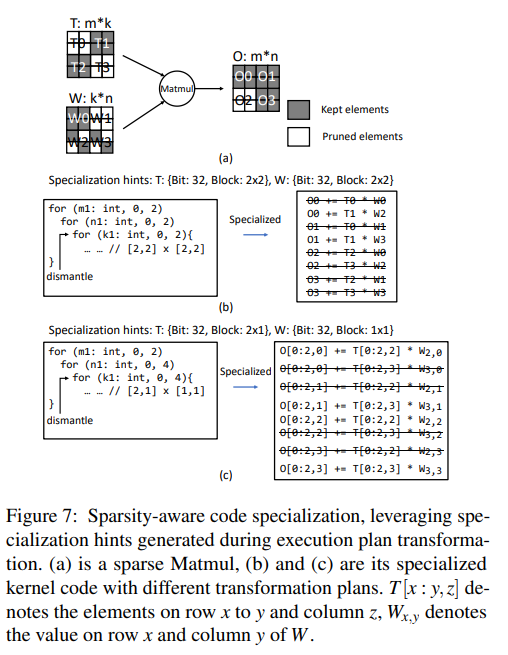
图7:稀疏性感知的代码专门化,利用执行计划转换期间生成的专门化提示。(a)是一个稀疏的Matmul, (b)和(c)是其具有不同转换计划的专用内核代码。T[x: y,z]表示x到y行z列的元素,W 表示W的x行y列的值。
给定不同的转换计划(以及规范提示),代码可以以不同的方式专门化。图7(c)中的提示显示了一个较小的块大小。在本例中,循环体是一个较小的Matmul(即[2,1]x[1,1]),它支持更多的DCEs。除消除了前一种情况下的死计算外,还可以消除四次小Matmul的计算。此外,由于小Matmul只访问W中的一个值,该值可以直接特化到代码中(即W ),而无需在内存中维护一个稀疏张量W。
特化提示还可以指定块大小等于张量的形状(即,一个块覆盖整个张量)。在这种情况下,SparTA可以直接使用现有的最先进的通用稀疏内核实现(例如cuSPARSE,taco),如果性能更好,甚至可以使用密集内核实现。SparTA的专门化框架通常包含任何与稀疏相关的技术,包括现成的稀疏内核,甚至它的密集版本。
具有量化属性的专门化算子也适用于多级循环,但从最内层循环开始。SparTA根据TeSA中表示的位宽选择合适的硬件指令,例如DP4A或wmma为8bit, wmma为4bit。然后将最内层循环的专门平铺与指令的计算形状对齐。例如,一个支持的wmma计算形状是Matmul [16,16]x[16,16]。为了专门化该指令,平铺应该重新排列最内层的循环体以与形状对齐,然后用该指令替换重新排列的循环体。对于形状为[1,4]x[4,1]的指令DP4A,可以采用类似的平铺操作。
4 实施
我们在Rammer上实现了SparTA, Rammer是一种最先进的开源DNN编译器,对稀疏性没有特殊支持。我们将稀疏性属性传播实现为Rammer上的专用编译传递。在编译之前,DNN模型被转换为ONNX图。每个TeSA元素都有一个两个字节的属性:7位记录元素的位宽,4位指定元素的数据格式(例如:unsigned int, float32, bfloat16),其余5位保留。位宽为0表示元素被修剪。TeSA只在编译时存在,因此不会产生运行时内存成本。我们在Rammer中实现了执行计划转换,通过额外的编译过程,用更好的执行计划重写了图。专门的子操作符被注入到Rammer的内核DB中,用于构造整个可执行文件。
为了在执行计划转换中高效地执行加权块覆盖,SparTA计算不同大小块的权重。具体来说,我们实现了一个用于块稀疏性的内核模板,并在该模板上评估了13个不同大小的块。每个块大小的开销是通过以零稀疏度测量内核的延迟并将延迟与块的数量进行分割来分析的。该开销被用作块大小的权重。当作业者过于稀疏而无法饱和可用岩心时,权重的准确性可能会降低。在这种情况下,我们枚举所有的块大小组合来运行加权块覆盖算法,并选择最佳的一个。对于内核专门化,我们实现了基于循环展开的拆解原语。当一个循环通过拆卸展开时,我们读取相应的TeSA,并相应地消除死计算。
SparTA作为模型稀疏性的全栈解决方案,目前已支持21种模型稀疏性算法,包括16种剪枝算法和5种量化算法(由于页数限制,省略完整列表)。这些算法可以在SparTA上运行,只需要很少的代码修改,并且受益于SparTA不仅在稀疏性探索上,而且在模型微调上。
5 评估
我们在三种流行的DNN模型上评估了SparTA,在NVIDIA GPU、AMD GPU和Intel CPU上使用了四种不同的稀疏模式。总的来说,我们的主要发现包括:
- SparTA显著降低了稀疏DNN模型的推断延迟,同时减少了内存消耗。加速高达10.6x, 5.0x, 7.5x, 20.1x, 5.8x, 5.6x, 1.7x的PyTorchJIT, TensorRT, TVM, TVM sparse2, Rammer, Rammer sparse3和OpenVINO (CPU),分别。平均加速是3.8倍、2.6倍、4.2倍、8.4倍、3.0倍、3.2倍、1.7倍。
- 稀疏性属性传播增加端到端稀疏率高达39.7%。通过执行计划转换和代码专门化,对于具有复杂稀疏模式的稀疏DNN算子(如Matmul), SparTA可以实现比最先进的稀疏内核实现高达6.7倍的速度。
- SparTA促进了稀疏DNN模型的开发和探索,产生了具有更低的推理延迟和/或更高精度的DNN模型。
5.1 端到端实验
我们评估了SparTA在不同任务域上三种流行的DNN模型的推断延迟和内存使用情况,如表3所示。我们评估了四种代表性的稀疏模式,包括不同的剪枝和量化方案及其组合。非结构化稀疏梅恩斯模型在权重张量中元素的粒度中加权,以达到期望的稀疏比。结构化稀疏性根据特定的模型,在列、行、通道或块的粒度中删除权重。我们将不同的稀疏模式应用于所选的三个模型,以展示SparTA在不同模式下的有效性。BERT按行结合大小为32x32的块进行修剪;MobileNet在输出信道中进行修剪,HuBERT则是Conv层的信道修剪和变压器层的头部修剪相结合。为了进一步证明TeSA的强大表达能力,我们采用了结构化稀疏性,在此基础上,对剩余的张量元素进一步进行8bit量化,构建第三个稀疏模式,即结构化+8bit。最后,我们引入了一种更为复杂的BERT混合稀疏性。在结构化+8比特稀疏性的基础上,我们对0.01%的修剪后的元素应用了32比特量化的非结构化稀疏性,这导致了总稀疏率为94.99%。
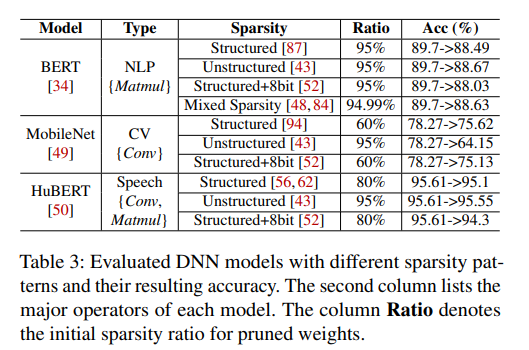
表3:评估不同稀疏模式的DNN模型及其结果精度。第二列列出每个模型的主要操作符。Ratio列表示修剪后权重的初始稀疏率
我们应用上述稀疏模式训练模型(BERT在数据集QQP上,MobileNet在ImageNet-Dogs上,HuBERT在SUPERB上),这些稀疏模型的精度变化如表3 Acc列所示。总的来说,准确性下降与相应论文中报道的一致,稀疏BERT的准确率下降约1%。混合稀疏度在稀疏度为94.99%的情况下,准确率为88.63%,与非结构稀疏度基本相同,但更容易加速。对于MobileNet来说,非结构化稀疏性的准确率下降更高,因为它的稀疏性很高(即95%)。HuBERT算法中95%非结构化稀疏度优于80%稀疏率的结构化稀疏度。
5.1.1 SparTA在CUDA GPUS
- Structured sparsity 结构化稀疏。图8的第一行显示了三个模型对结构化稀疏度的推断延迟。PyTorch、TensorRT、TVM和Rammer将它们视为三个密集模型。其中,TensorRT表现最好。与TensorRT相比,SparTA在BERT、MobileNet和HuBERT上分别快3.7倍、2.9倍和2.4倍。TVM-S和RammerS意识到稀疏性。TVM-S带来了很高的推断延迟,因为它使用的内核模板不能有效地支持不同的稀疏模式。Rammer-S在MobileNet和HuBERT上的表现略好于TensorRT。SOTA稀疏内核使用Sputnik,在这些模型上比cuSPARSE和taco性能更好。SparTA的性能比Rammer-S快1.7倍、2.6倍和2.3倍。它的性能增益主要来自于稀疏传播,这增加了整个模型的稀疏性(见§5.2)和稀疏变换,也就是说,在不同的层上覆盖不同的块大小。
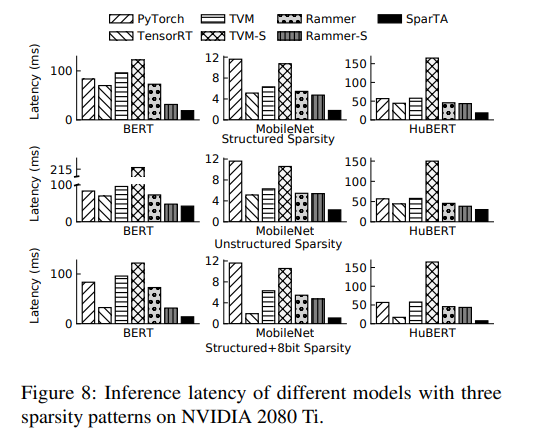
图8:NVIDIA 2080 Ti上三种稀疏模式下不同模型的推断延迟
推断中的内存占用如图9的第一行所示,SparTA的足迹最小。对于MobileNet, PyTorch和TensorRT消耗更多的内存,因为它们使用cuDNN,这需要额外的内存来存储权重和激活。由于稀疏传播,SparTA的内存占用比TVM- S和Rammer-S小,增加了稀疏比。
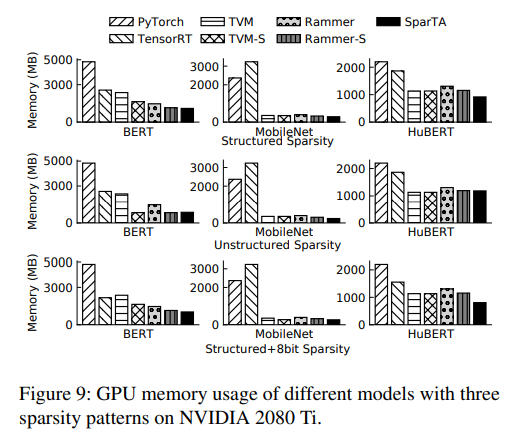
图9:NVIDIA 2080 Ti上三种稀疏模式下不同型号的GPU内存使用情况
- Unstructured sparsity 非结构化稀疏。对于非结构化稀疏性(即图8中的第二行),TensorRT在这些密集基线中表现最好,略优于Rammer。SparTA在BERT、MobileNet和HuBERT上分别比TensorRT快1.6倍、2.2倍和1.5倍。“Rammer- s”仍然使用“Sputnik”。SparTA的性能比Rammer-S分别高出1.13倍、2.4倍和1.3倍。在MobileNet上的加速是高的,因为即使在非结构化稀疏性下,稀疏性也更容易在深度和点向卷积中传播。在BERT和HuBERT上,相对于Rammer-S的性能提升主要来自于代码专门化(即权重值嵌入到内核代码中)。对于内存使用情况(即图9的第二行),SparTA显示了类似于TVM-S和Rammer-S的使用情况,并且比其他基线性能更好。
- Structured+8bit 结构化+ 8bit。如图8的第三行所示,TensorRT的性能比PyTorch、TVM和Rammer好得多,因为它支持张量核心(Tensor Cores)的低位计算。SparTA在BERT、MobileNet和HuBERT上的表现分别是TensorRT的2.3倍、1.7倍和2.2倍。这是因为,除了利用Tensor Core的硬件指令wmma之外,SparTA还进一步结合了结构化稀疏性的优化。与Rammer-S(同样使用Sputnik)相比,SparTA在BERT、MobileNet、HuBERT上分别快2.3倍、4.3倍、5.6倍,因为Rammer-S对每个稀疏算子的优化有限(如缺少低位指令),而SparTA对模型进行了整体优化,如稀疏传播、算子变换和专业化。加速显示了结构化稀疏性(即图8的第一行)和低位指令的综合增益。SparTA的内存使用(即图9的第三行)是最低的:内存节省来自低位值和修剪后的元素。这突出了SparTA的优点,尤其是TeSA,它使用统一的抽象进行修剪和量化,从而使这种联合优化成为可能。
- Mixed sparsity混合稀疏。图10左边的图显示了混合稀疏BERT的延迟。SparTA比PyTorch、TensorRT、TVM、tms、Rammer、Rammer- s分别快5.9x、5.0x、6.8x、8.7x、5.2x、2.2x。与结构化+8bit不同,TensorRT在混合稀疏性上比其他基线略有优势,尽管大多数元素都是8位的。
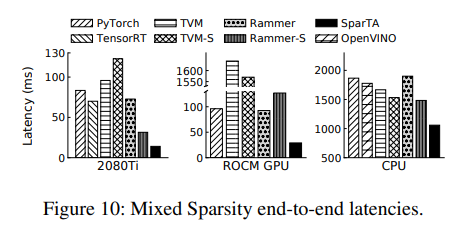
图10:混合稀疏端到端延迟
- Latency Breakdown延迟崩溃。图11显示了BERT在四种稀疏模式上的性能分解。“+稀疏核”应用我们生成的稀疏核,遵循原始的稀疏比,没有算子变换和核特殊化。它可以被视为Rammer-S。“+传播”在模型上应用稀疏传播,不需要变换和特殊化就能再生稀疏核。“+Transformation”调整块的大小,以覆盖每个稀疏算子的非剪枝元素,并为混合稀疏性,它还将稀疏张量分解为多个。“+专门化”调整块内实现,并在必要时将值嵌入代码。
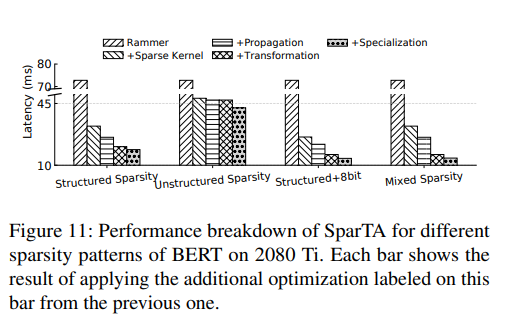
图11:SparTA在2080 Ti上不同稀疏模式下的性能分解,每个条都显示了应用上一个条所标记的额外优化的结果
对于混合稀疏性,每次优化带来的延迟减少分别为55.8%、19.7%、37.7%和12.6%。其他三种稀疏模式可以看作是混合稀疏的一种分解。在结构化稀疏性和结构化+8bit时,变换的延迟降低分别为20.5%和26.5%,传播的延迟降低为19.7%,延迟分别减少15.8%。最后,块内专门化为结构化、非结构化和结构化+8bit分别减少了8.2%、11.4%和13.7%的延迟。某一优化的意义取决于DNN模型和稀疏模式。对于图11中的BERT,“+稀疏内核”平均带来2.1倍的增益,SparTA带来额外的2倍增益。对于MobileNet来说,“+传播”带来了最大的收益(例如,将稀疏性从50%增加到89.7%)。
- Latency of different batch sizes不同批处理大小的延迟。图12显示了在NVIDIA 2080Ti上不同批处理大小下BERT的性能。当批量大小从8到64时,SparTA在三种稀疏模式上平均分别比PyTorch、TensorRT、TVM、TVM、Rammer、Rammer- s快4.1x、2.4x-2.7x、4.2x-6.3x、5.9x-13.8x、3.6x-4.1x、2.2x-2.6x。对于不同的批处理大小,SparTA的总体加速是相似的。在TVM- s上的加速范围相对较大,因为较大的批处理大小会导致较大的调优空间,从而降低TVM中的内核调优的效率。
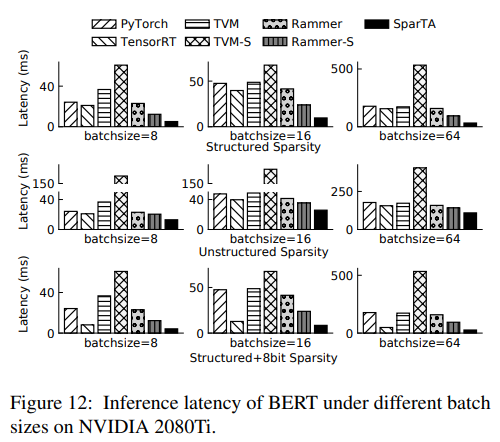
图12:NVIDIA 2080Ti上不同批处理大小下BERT的推断延迟
- Compiling overhead 编译开销。SparTA的开销来自编译阶段,该阶段包括三个部分:传播、转换和专门化。开销与模型中操作符的数量呈正相关。以BERT为例,使用单个线程,传播、转换和专门化分别需要3分钟、2小时和1.5小时。通过利用转换策略和预先调优的内核中的更多先验知识,可以减少开销。我们把它留作以后的工作。
5.1.2 SparTA在其他加速器上
- ROCm GPU。图13显示了三种模型在AMD Radeon VII上的推理延迟。SparTA比PyTorch在三种稀疏模式上的加速分别为3.5倍、4.2倍、2.2倍,对于BERT、MobileNet和HuBERT。在ROCm gpu上TVM的内核调优不正常(总是停留在Debug模式),TVM和TVM- s在BERT和HuBERT上的性能受到很大影响。它们在MobileNet上表现出了合理的性能,因为它们为一些流行的DNN模型(包括MobileNet)提供了相当不错的默认内核调度。与Rammer相比,SparTA在三种稀疏模式上分别比BERT、MobileNet和HuBERT快3.4倍、4.1倍和2.4倍。Rammer-S在ROCm GPU上使用了hipSPARSE, SparTA比Rammer-S的加速速度分别为4.7倍、4.6倍、5.0倍(对于BERT、MobileNet和HuBERT)
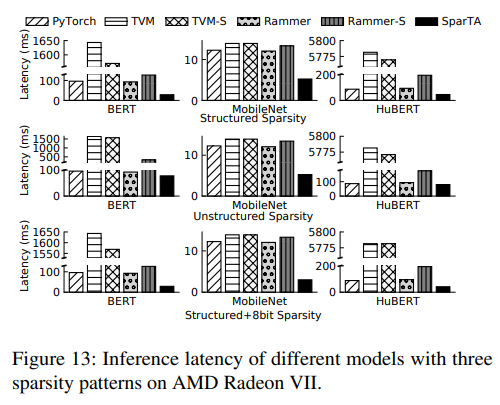
图13:AMD Radeon VII上三种稀疏模式下不同模型的推断延迟
对于图10中间所示的BERT混合稀疏度,SparTA分别比PyTorch、TVM、TVM- s、Rammer和Rammer- s快3.3倍、56.7倍、54.1倍、3.2倍、4.4倍。虽然使用hipSPARSE的Rammer- s比Rammer有更高的延迟,但是它占用的内存更少。
- 英特尔CPU。我们对BERT在CPU上的混合稀疏模式进行了评估,结果如图10的右侧所示。与Intel CPU上的高性能推理引擎OpenVINO相比,SparTA的速度提高了1.7倍。对于PyTorch, TVM, TVM- s, SparTA的加速分别是1.8x, 1.6x, 1.5x。Rammer-S使用MKL库,它利用了稀疏性,因此比其他基线更快。SparTA仍然比Rammer-S有1.4倍的性能增益,因为它利用了低位指令(即AVX512 VNNI),并通过稀疏传播和执行计划的整体转换进一步优化了模型。
5.2 稀疏性属性传播
- Propagation of pruned elements 剪枝元素的传播。在BERT上传播所带来的性能增益如图11所示。由于卷积的滤波器尺寸较小(例如3x3),因此在MobileNet上的传播具有较高的电位。图14显示了稀疏性是如何在MobileNet上跨层传播的,这增加了每一层的稀疏率。在本实验中,我们测试了三种稀疏率,分别为50%、70%、90%,这三种稀疏率都是由端到端实验中使用的相同算法修剪而成。对于每个稀疏比,我们修剪每一层的MobileNet到目标比,然后应用传播规则。由于剪枝元素的传播规则不影响计算逻辑,因此在传播前后对train/test数据集的推理精度结果完全相同。
对于结构稀疏性,传播后的总稀疏率从50%提高到89.7%。在MobileNet中,交错深度卷积和点向卷积的传播电位不同,导致了曲线的曲折。有趣的是,当原始稀疏率为90%时,传播后稀疏率变为100%,这就解释了一个异常现象,即尽管在每个卷积(传播前)上留下了10%的滤波器,但模型的精度类似于随机图像分类器。该算法对非结构稀疏性的传播能力较低。只有高稀疏比才能使稀疏比明显增加。例如,原稀疏度为90%,传播后总稀疏度增加到95.3%。通过张量置乱,我们的经验表明256个随机抽样张量可以正确地识别稀疏性。
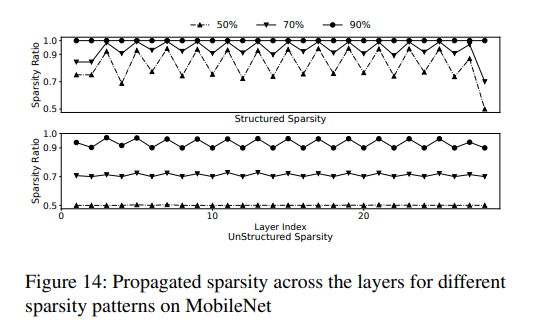
图14:在MobileNet上不同稀疏模式的层间传播稀疏性
- Propagation of quantization bit 量化比特的传播。在这个实验中,我们评估了量化传播规则。我们采用HAQ中提出的相同方法来量化MobileNet。具体来说,它使用强化学习来探索每个权值和激活张量上的位宽。候选位宽度在0到8之间。在探索了50种不同的位宽配置后,我们选择了最好的一种,其在ImageNet上的准确率为64.6%。然后将传播规则应用于该配置。实验结果如图15所示:28层中有18层的比特宽度减小(从7bit减小到4bit左右),而传播后的模型精度仅略有下降,从64.6%下降到64.2%。从另一个角度来看,我们的量化传播规则是对量化比特上的搜索算法(如强化学习,模拟退火)的补充。它们的适当组合可以提高搜索效率,这是一个有趣的未来工作。
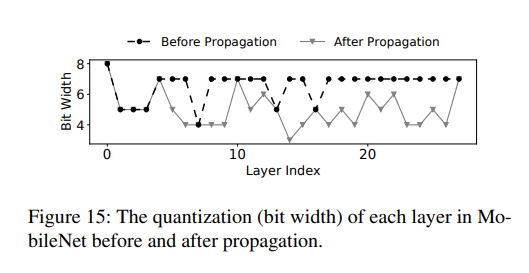
图15:MobileNet中每一层在传播前后的量化(位宽)
5.3 使用TeSA高效生成代码
- Effectiveness of execution plan transformation执行计划转换的有效性。SparTA中的稀疏感知执行计划转换可以有效地处理复杂的稀疏模式。我们测试了两种复杂的稀疏模式:(1)块大小为32x32的结构化稀疏和非结构化稀疏(即1x1)的混合。非结构化元素占1%,结构化稀疏率在70% ~ 90%之间。(2)在第一个稀疏模式的基础上,我们进一步将结构化稀疏度设为8bit,非结构化稀疏度设为32bit。为了展示转换的有效性,我们将SparTA与两个基线进行了比较:一个是我们专门用于结构化稀疏性的内核(由BlockSparse表示),其中非结构化元素由32x32块覆盖;另一种是Sputnik,它针对非结构化稀疏性进行了优化。
结果如图16所示,对于第一个稀疏模式,SparTA将该算子分别转化为具有结构稀疏性和非结构稀疏性的两个子算子。经过变换后,SparTA在三个稀疏比上分别比BlockSparse快2.5倍、3.3倍、5.4倍。BlockSparse的性能变化不大,因为覆盖非结构化元素的块构造了计算中的主要块。SparTA比Sputnik的速度分别为3.2倍、3.1倍、2.8倍。Sputnik在70%块上表现最差,因为它将每个块视为1024个非结构化元素,从而错过了优化机会。对于第二个稀疏模式,SparTA的性能增益要高得多,即比BlockSparse快4.1倍、5.1倍、6.7倍,比Sputnik快5.2倍、4.7倍、3.5倍,这是因为SparTA进一步利用低位指令来计算32x32块。
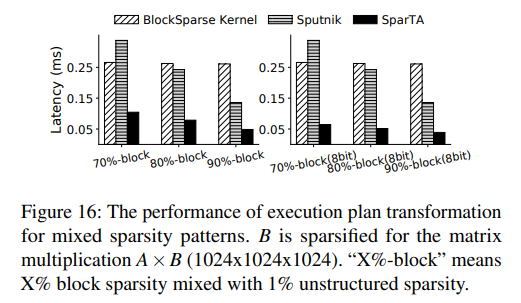
图16:混合稀疏模式的执行计划转换的性能。B对矩阵乘法进行稀疏化A×B (1024x1024x1024)。“X%-block”表示X%块稀疏度与1%非结构化稀疏度混合
这种转换可以有效地利用像稀疏张量核心这样的特殊硬件。稀疏张量核(Sparse Tensor Core)对张量的稀疏模式有严格的要求,例如:在[1×2] tile中要修剪一个元素(稀疏率为50%)。为了利用稀疏张量核获得一般的非结构化稀疏性,我们提出了一种新的转换策略,将一个非结构化稀疏张量分解为两个:一个遵循稀疏张量核的稀疏性要求,另一个包含第一个张量核中不包含的元素。第一个使用稀疏张量核,而另一个使用我们专门的稀疏核。为了评估该变换,我们随机生成一个非结构化稀疏张量,其稀疏率在一个Matmul输入的50%到90%之间。实验运行在NVIDIA A100上,结果如图17所示,SparTA的性能比BlockSparse和Sputnik都要好,因为它利用了一个为SparseTensor Cores优化的库cuSPARSELt,而sub-Matmul的成本约为40美元。其他子Matmul的稀疏率分别为12.5%、8%、4.5%、2.0%、0.5%。BlockSparse展示了与cuBLAS相似的性能。由于稀疏性是随机引入的,它实际上计算了一个密集的Matmul。
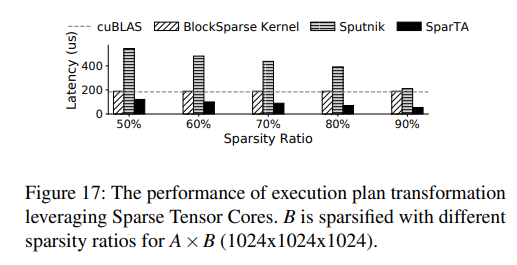
图17:利用稀疏张量核心的执行计划转换的性能,B用不同的稀疏率对A×B (1024x1024x1024)进行稀疏化。
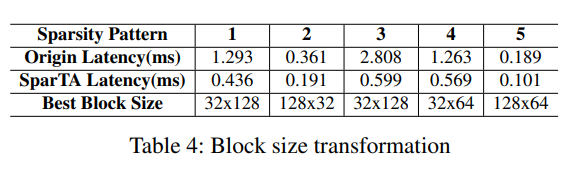
在转换过程中,SparTA还会找到覆盖那些未修剪的元素的最佳块大小。我们在BERT中选取了5个具有不同稀疏模式的稀疏张量,应用WeightedBlockCover来寻找这5张量的最佳块大小。表4显示了找到的块大小,所选择的块大小都不同于原来的32x32块大小,它们的性能都比使用原始块大小实现的内核要好得多。从本质上讲,块覆盖在为底层硬件优化某个块大小的效率和使用该块大小浪费的计算比率之间进行权衡。
- Effectiveness of TeSA code specialization TeSA代码专门化的有效性。我们评估了SparTA的矩阵乘法核在不同的非结构化稀疏率(50% ~ 99%)下的性能。我们将专用内核与cuSPARSE、taco和Sputnik进行比较。结果如图18所示,在99%的稀疏度下,cuSPARSE优于cuBLAS,但在95%的稀疏度下会导致2.2倍的减速。在大多数情况下,cuSPARSE在延迟方面的表现比cuBLAS差得多,尽管由于编码的稀疏张量,它的内存占用更少。taco的性能比cuSPARSE差,因为它对共享内存的低效利用。在99%的稀疏度下,它比cuSPARSE慢15.6倍;当稀疏度为50%时,减速降低到4.0x,SparTA比cuSPARSE快6.0倍。当稀疏度仅为70%时,其性能优于cuBLAS。Sputnik的性能也比cuSPARSE和taco好,SparTA比Sputnik快1.7倍。

图18:cuSPARSE、taco、Sputnik和SparTA在不同稀疏比下细粒度稀疏矩阵乘法(1024x1024x1024)的比较,B是A×B的稀疏
5.4 增强模型稀疏性探索
SparTA作为模型稀疏性的全栈解决方案,促进了现有模型稀疏性算法的探索。在本节中,我们将从以下两个方面对此进行说明。实际延迟vs. FLOPS作为减少模型剪枝延迟的代理度量。在本实验中,我们使用模拟退火对MobileNet进行修剪,分别减少30%和40%的推断延迟,即图19中的两条虚线。我们的基线使用FLOPS作为过滤不合格模型的度量标准:FLOPS大于原始FLOPS的70%的模型。相反,SparTA使用真实的延迟来过滤模型。结果如图19所示。两种方法找到的最优稀疏模型具有相似的精度。然而,通过FLOPS发现的模型不满足延迟目标,分别比目标高23.8%和51.4%。这表明FLOPS不能真实地反映真实的推断延迟。相比之下,在SparTA上通过算法找到的稀疏模型成功地满足了延迟要求。
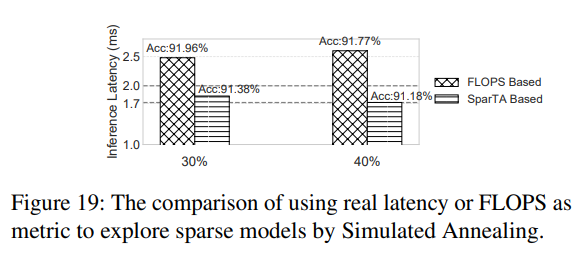
图19:使用真实延迟或FLOPS作为度量来通过模拟退火探索稀疏模型的比较
- Speeding up sparsity exploration加速稀疏探索。SparTA具有高性能的稀疏核,可以加快稀疏算法的探索过程,稀疏算法通常是迭代搜索一个稀疏模式[。在每次迭代中,该算法将模型的一部分(如30%)“稀疏化”,并对其进行微调。它重复迭代,直到达到目标稀疏度(如90%)。在此过程中,模型微调会消耗大量的探索时间。使用SparTA,可以加速模型的微调。图20在ResNet50上运行了一种迭代稀疏性算法——模拟退火。该算法在每次迭代中删减50%剩余的权值,并微调300个epoch。与始终使用原始密集模型的基线相比,SparTA减少了31.8%的总勘探时间。
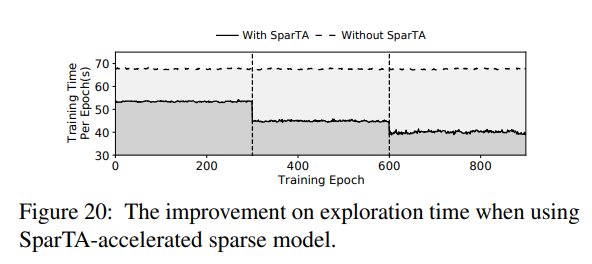
图20:使用SparTA加速稀疏模型对勘探时间的改进
5.5 加速稀疏模型训练
除了模型修剪和量化,一些DNN模型从一开始就被设计为稀疏的,如稀疏注意,SparTA也可以用来加速这种稀疏模型的训练过程。
我们通过将SparTA应用于NÜWA的训练来证明这一点。NÜWA是一种最先进的视觉合成预训练模型,采用了一种新颖的3D附近注意力(3DNA)机制。在3DNA中,每个标记在一个小的3D窗口内计算对附近标记的关注,而不是对所有标记(即完全关注)。
我们使用SparTA实现了3DNA,并将其性能与之前的PyTorch实现(密集版本)和另一个使用OpenAI的Triton (v1.1.1)实现的版本进行了比较,这是一个支持稀疏关注的编译器。由于两个基线是基于PyTorch的,所以我们将基于SparTA的3DNA集成到PyTorch中进行公平的比较。结果如图21所示,Triton和SparTA的执行速度都比默认的PyTorch版本快得多,并且消耗更少的GPU内存。当批处理大小超过16时,默认的PyTorch版本会遇到内存不足。在不同的批处理大小上,SparTA比Triton快2.15 ~ 2.24倍,这主要是因为SparTA擅长块大小(例如: 32x64, 32x32)覆盖3DNA矩阵乘法中的非零值。SparTA和Triton的内存使用是相似的。由于基于SparTA的版本目前依赖于PyTorch来管理一些中间张量,因此通过将其移到SparTA端来进一步提高内存使用是可能的。
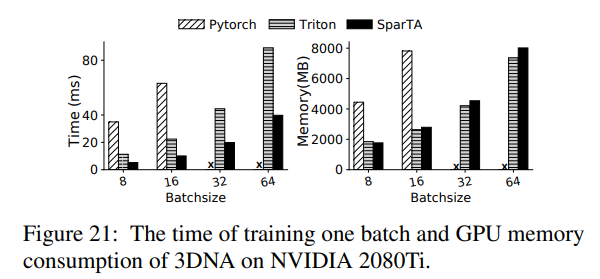
图21:NVIDIA 2080Ti上训练一批的时间和3DNA的GPU内存消耗
6 相关工作
- Sparsity support in DNN frameworks and compilers DNN框架和编译器的稀疏性支持。深度学习框架,如PyTorch和TensorFlow或编译器,如TVM/Ansor,通过供应商特定的库(如cuSPARSE/cuSPARSELt或用户提供的稀疏性内核模板)利用稀疏性。缺乏对稀疏模型中特定稀疏模式的理解会导致性能不佳。相比之下,使用TeSA, SparTA可以捕获任意的稀疏模式,并支持各种稀疏感知优化来生成高效的端到端代码。
SparTA的设计融合了几种经典的编译技术。例如,稀疏性属性传播类似于类型限定符和类型推断。OpenMP还通过不同的机制在不同的问题域中利用属性传播。基于值分析的代码专门化也是一种众所周知的技术。Zeroploit和PGZ也使用类似的想法,但侧重于游戏应用。SparTA使用更通用的属性来专门化代码,而不是值,SparTA为DNN模型的稀疏性提供了一个完整的框架。
- Sparsity acceleration of DNN models DNN模型的稀疏性加速。稀疏矩阵乘法在科学计算中已经被研究了几十年,随着新兴加速器的出现(如GPU, TPU, FPGA , GraphCore),一些研究针对某类硬件优化稀疏矩阵乘法。另一类研究一种高效的稀疏数据格式(如CSR、CSB和DIA),以减少内存占用和提高缓存效率。Taco用统一的表达式概括了各种稀疏数据格式,它使用最适合一类稀疏模式(例如,99%稀疏)的适当数据格式生成稀疏内核代码。与taco不同,SparTA为稀疏性提出了一个整体框架,包括稀疏传播、执行计划转换和代码专门化。
为了优化GPU上的稀疏核,SparseRT将稀疏权值嵌入到内核代码中,而不是以稀疏数据格式存储。它可以被视为SparTA中代码专门化的一种特殊情况,即展开所有循环。Hong等将稀疏张量中的元素重新排序,并采用自适应平铺策略来提高稀疏矩阵乘法的性能,这些优化是对SparTA的补充。
一些工作与硬件共同设计稀疏性算法,平衡稀疏性以在GPU上高效并行执行,类似的设计也被纳入到稀疏张量核中。EIE设计了一种新的数据编码/解码节点和一种新的处理元素(Processing Element, PE)来加快矩阵向量乘法的速度。SCNN设计了PE的另一种架构,它支持压缩格式的稀疏卷积。SparTA可以通过新的转换和专门化途径来利用这些新的加速器。
- Sparsity exploration on DNN models DNN模型的稀疏性探索。神经科学和深度学习的研究都表明,深度神经网络是稀疏的。各种模型压缩算法被展示来构造精度退化很小的稀疏模型,非结构化剪枝剪枝模型的权值没有规律的模式,而其他的工作则以规律的粒度剪枝DNN模型,如CNN中的过滤器、通道和块级。量化是另一种稀疏化模型的方法,包括单精度、层间的混合精度和每个张量内的混合精度。最近的研究进一步结合了修剪和量化技术。SparTA的TeSA抽象可以捕获所有这些作品中的稀疏模式,并为稀疏模型生成高效的代码。
7 结论
SparTA在深度学习中采用了原则性的系统方法来建模稀疏性,以新的TeSA抽象为中心。SparTA旨在适应丰富的稀疏模式集,端到端和跨栈工作,以支持稀疏模式的传播和利用这些模式的优化,并利用编译器技术和硬件支持,所有这些都在一个可扩展的框架中,SparTA不仅可以提供卓越的稀疏诱导加速,而且首次在一个统一的框架内加速模型的稀疏创新。
原文链接:https://www.usenix.org/conference/osdi22/presentation/zheng-ningxin