摘要
深度学习是当今机器学习中使用的最成功、影响最深远的策略之一。然而,神经网络的规模和效用仍然受到目前用于训练它们的硬件的很大限制。随着传统计算机的物理性能迅速接近极限,这将在未来几年延缓性能的提高,这些担忧变得越来越紧迫。出于这些原因,科学家们已经开始探索替代计算平台,比如量子计算机,用于训练神经网络。近年来,变分量子电路已经成为噪声中等尺度量子器件上最成功的量子深度学习方法之一。我们提出了一种混合量子经典神经网络架构,其中每个神经元是一个变分量子电路。我们利用模拟通用量子计算机和最先进的通用量子计算机对一系列二进制分类数据集进行了混合神经网络性能的实证分析。在仿真硬件上,我们观察到,与单个变分量子电路相比,混合神经网络实现了约10%的高分类精度和20%的最佳最小化成本。在量子硬件上,我们观察到只有当量子比特和门计数足够小时,每个模型才能表现良好。
1.引言
机器学习彻底改变了现代世界。目前,机器学习模型被用于几乎所有可以想象到的任务之中,从医疗诊断到欺诈检测到营销。机器学习在许多学科中的出现在很大程度上是由于最近相对强大的计算机的可访问性。根据摩尔定律,在过去的 60 年中,计算机硬件的规模和速度呈指数级增长。不幸的是,尽管最近取得了成功,现代硬件仍然极大地限制了某些机器学习模型的实用性。机器学习,特别是深度学习,计算成本非常高,有时需要在当前的计算机上花费数小时、数天甚至数月的训练时间。此外,传统计算机开始接近物理限制,这将减缓它们在未来几年的改进。由于这些原因,许多人开始研究用于训练机器学习模型的替代计算平台。在这些平台中,量子计算机已经成为一个特别有趣的候选者。
量子计算机的吸引力很大程度上是由于量子纠缠和量子叠加的特性,而这些特性在传统计算机上是无法有效模拟的。这些特性非常有用,例如Shor的质因数分解算法和Grover的搜索算法,它们分别提供了指数和多项式的速度,分别优于现有的最佳经典算法。这两种算法让我们看到了大型高保真量子计算机在未来几年可能为计算机科学领域提供什么。目前我们仍然处于嘈杂的中等规模量子 (NISQ) 计算机时代,但已经有一些量子机器学习算法被提出。我们之前研究过线性回归、支持向量机和平衡 k 均值聚类的量子方法。此外,我们提出了一个量子学习模型,可用于通用量子计算机上的二进制分类。在本文中,我们提出了一种混合量子经典神经网络架构,并实证分析了它在几个二进制分类数据集上的性能。据我们所知,我们的研究首次使用模拟或量子硬件测试了这种混合神经网络架构。
神经网络已经被证明在传统计算机上学习是成功的,但它们有一些严重的局限性。它们容易过度拟合,即使是小型神经网络的训练也是一个 NP 完全问题。这些限制激发了许多人提出深度学习的量子方法。不幸的是,这些提议中的许多不能在现代硬件上实现,而那些能够实现的提议与传统的人工神经网络没有一一对应的关系。出于这个原因,人们对在近期量子计算机上表现良好的深度学习方法越来越感兴趣。为此,变分量子电路 (VQC) 已被证明是一种有前途的人工神经元量子模拟物。变分量子电路可以使用经典的优化技术进行训练,并且它们被认为比传统的神经网络架构具有一些可表达性优势。Liu等人使用变分量子电路实现了他们自己的混合量子经典神经网络,他们的研究为类似于我们模型的训练动力学提供了详细的见解。
2.量子神经网络
变分量子电路由三个关键部件组成。首先,特征映射 将实值经典数据点 映射到 量子比特量子态 :
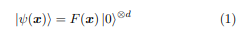
接下来,ansatz 通过一系列纠缠和旋转门操纵制备的量子态。ansatz旋转的角度用向量 参数化。
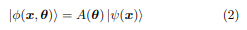
最后,测量一个可观测的 ,并记录对应于所得量子态的特征值。 在大多数机器学习应用中,变分量子电路使用特定的输入 和参数向量 运行多次,以便可以近似用 表示的电路的期望值。
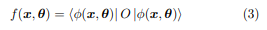
当变分量子电路用于机器学习时,这个近似的期望值通常被视为模型的输出。
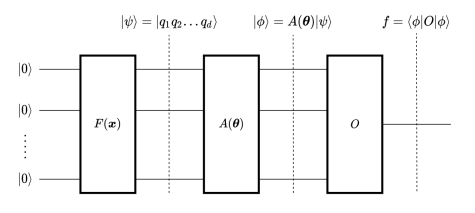
图1. 变分量子电路示意图
众所周知,变分量子电路的特征图在模型的表现力中发挥了一定的作用。一般来说,数据的编码方式应该是,通过量子比特旋转和测量的某种组合从准备好的量子态中提取特征值。这确保了每个可能的输入 在传递给 ansatz 之前都具有唯一的量子比特编码。 在现代硬件上,使用深度有限的特征图也很重要,因为每个额外的门都会给量子态引入噪声。 我们通过缩放每个特征 以适应区间 来满足这两个要求,然后将其值编码为相应量子位的相对幅度:
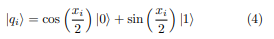
值得注意的是,存在更复杂的特征图。 然而,对于本手稿中分析的数据集,这个简单的特征图实现了高精度,同时避免了更复杂方法引入的许多复杂性。
Qiskit电路库包含由两个量子比特纠缠和参数化的单个量子比特旋转组成的几个ansatzes。我们为第四节中研究的每个变分量子电路选择了realamplitude ansatz(具有一次重复和完全纠缠)。这是Qiskit的变分量子电路实现(TwoLayerQNN)使用的默认ansatz。它还被用于一种变分量子电路,在容量和可训练性方面已证明优于传统的前馈神经网络。我们还选择了Qiskit变分量子电路实现中使用的默认可观察对象。在数学上,这个可观察性可以描述为 矩阵( )的张量积,其中 是量子态中的量子比特数:
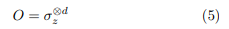
这个可观测量有一个有趣的性质,如果测量的量子态有奇校验,记录的特征值为 ,如果测量的量子态有偶校验,记录的特征值为 。这意味着电路的期望值总是 在区间 内。
已有许多研究使用变分量子电路进行二进制分类。这可以通过将电路的期望值与一个点属于给定类别的概率相关联来完成。考虑一个二进制分类问题,其中每个数据点 被标记为 。我们使用以下等式将可观察到的奇偶校验的期望值与点 标记为 的概率相关联:
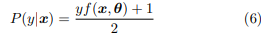
训练变分量子电路分类器等于确定一个参数向量 ,它使训练数据集上的概率分布的负对数似然最小化。 我们的二进制分类器使用的确切成本函数由以下等式给出:
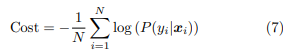
其中 是训练数据集中的点数, 是训练集中的第 个数据点, 是第 个点的标签。
使用诸如梯度下降之类的经典优化器可以最小化成本。 在计算成本函数的梯度时,变分量子电路的期望值相对于 ansatz 的每个参数的导数是使用参数移位规则计算的:
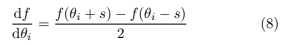
其中 是由 参数化的门的特征值确定的宏观偏移。 对于 Qiskit 库中可用的所有旋转门和相位门, 。
在许多方面,上述变分量子电路分类器类似于传统神经网络中使用的逻辑单元。该电路有一个输入向量 和一组经典优化参数 。此外,变分量子电路的输出(期望值)是连续可微的,并被限制在一个小的实值范围内。这些相似性促使我们使用变分量子电路作为单个神经元来构建一个小型混合量子经典前馈神经网络。为了在现代量子硬件上实现合理的训练时间,我们将神经网络结构限制为仅包含单个隐藏层和单个输出单元。
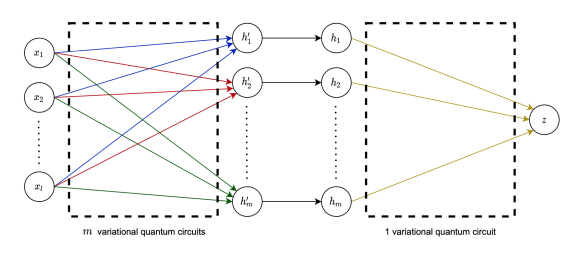
图2. 单隐层量子神经网络的架构。 特定变分量子电路的输入和相应输出由相同颜色的箭头连接。 输入数据点 的维度为 。 整个网络的输出用 表示。
使用图 2 所示的架构,我们的混合神经网络包含 个变分量子电路。 前 个电路构成前馈网络的隐藏层。 这些电路中的每一个都有自己的参数向量 ,并且它们都共享相同的输入 。 隐藏层中每个电路的输出被堆叠以创建一个 维向量 。 总的来说,我们将隐藏层的 个电路表示为函数 。
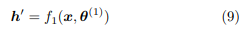
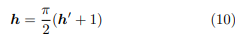
在 被传递到最终变分量子电路的特征图之前,应用了一个变换,使得每个值都在区间 内:
最后一个变分量子电路以输入 和参数向量 运行。我们将这个量子电路表示为函数 。综上所述,混合神经网络由以下复合函数表示:
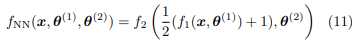
混合神经网络的输出可用于学习点 被标记为 的概率分布,使用等式 6 描述的相同方法:
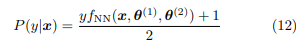
在二进制分类问题上训练混合神经网络类似于训练个体变分量子电路分类器。 我们最小化相同的成本函数(由等式 7 给出),并且我们仍然使用参数移位规则来计算每个电路的梯度。 然而,现在我们必须计算成本函数相对于输出层的参数向量 以及隐藏层中的每个参数向量 的梯度。 使用反向传播最有效地执行此操作。
3.研究方法
3.1振幅编码特征图
幅度编码特征图是通过首先初始化 个量子位的量子寄存器来实现的,每个量子位都处于 状态。 接下来,将单个量子位参数化 门应用于每个量子位。 选择每个门的参数,使得第 个量子位旋转角度 。 应用特征图后,在 状态下测量第 i 个量子比特的概率 由以下等式给出:
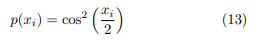
请注意,如果 被限制在区间 内,则 是一个一对一函数,其范围涵盖从 0 到 1 的所有可能概率。此特征图保证每个唯一输入 将具有一种独特的量子编码,不需要大量的量子门。
3.2真实振幅Ansatz
Qiskit 库中的 RealAmplitudes ansatz 完全由单个 qubit RY 旋转门和两个 qubit CX 纠缠门组成。首先,将参数化的 RY 门应用于每个量子位。 这些 RY 门的参数是 ansatz 的前 个参数。 接下来,将两个量子比特 CX 门应用于量子态中每个可能的量子比特组合。按照惯例,每次都使用最低有效量子位作为控制位。 最后,每个量子比特受制于另一个参数化的 RY 门。这些门的参数是ansatz的第二个 参数。通过调整重复次数,可以将额外的 CX 纠缠和 RY 旋转添加到 ansatz 中。 然而,为了避免长时间的训练,我们对每个变分量子电路使用了一次重复。 使用此规范,RealAmplitudes ansatz 始终具有精确的 参数。
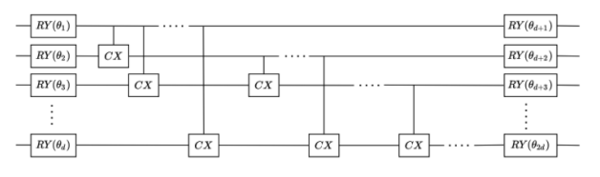
图3. 来自 Qiskit 库的 RealAmplitudes ansatz,具有一次重复和完全纠缠。
3.3预处理实值数据
正如在3.1节中提到的,在将每个特征传递给特征图之前,我们要求每个特征都在区间 内。对于条和条,这不是一个问题,因为所有的特性都有一个二进制值。或者,两个实值数据集必须在训练前进行修改,因为它们都包含许多特征值超出预期范围的点。我们使用以下程序为变分量子电路准备了这些数据集:
1.使用 Sci-Kit Learn 的 StandardScalar 类缩放数据集,使每个特征的平均值为 0,方差为 1。
2.将修改后的数据集除以其绝对值最大的特征。 现在数据集中的所有特征都有一个介于 -1 和 1 之间的值。
3.将修改后的数据集乘以 。
4.将 添加到修改后的数据集的每个特征。
执行此过程后,修改后的数据集中的每个特征都将落在区间 内,从而确保每个唯一输入 将具有唯一的量子编码。
3.4硬件和工作规范
在模拟量子试验期间,每个量子电路都使用 IBM QASM 模拟器运行。在实际的量子试验期间,每个量子电路都使用 IBM Mumbai 量子计算机或 IBM Montreal 量子计算机运行。两台量子计算机都有 27 个量子位和 128 个量子体积。它们都使用 CX、ID、RZ、SX 和 X 门。编译结果时,IBM Mumbai 的平均 CNOT 误差为 ,平均读数误差为 。 IBM Montreal 的平均 CNOT 误差为 ,平均读数误差为 。为了确定变分量子电路在特定输入上的输出(期望值),我们将电路运行了 1024 次,然后对每次运行的结果进行平均。使用配备 2.7GHz 双核 Intel i5 处理器和 8 GB 1,867 MHz DDR3 内存的个人笔记本电脑初始化每个作业并将其发送到量子计算机。这台笔记本电脑还用于处理每个作业的结果并相应地优化模型参数。
4.研究结果
我们在三个二进制分类数据集上测试了混合神经网络。 作为比较,我们还在每个数据集上训练了一个单独的变分量子电路分类器。 我们在模拟的通用量子计算机和最先进的通用量子计算机上训练了这两个模型。 为了达到合理的训练时间,我们限制混合神经网络只使用 个隐藏神经元。 在三个数据集上,对两个量子模型都进行了 10 次模拟量子试验和 2 到 3 次实际量子试验。 每次试验,所有 ansatz 参数都使用范围为 的均匀分布随机初始化。
在现代硬件上,VQC 和 HNN 与经典机器学习模型相比没有任何训练时间优势。事实上,构建一个经典的多层感知器总是可能的,它需要更短的训练时间,同时达到相同或更好的准确度。由于还不清楚随着量子硬件的发展,量子训练时间将如何变化,因此我们没有报告实验中的训练时间。通常情况下,即使在我们测试的最小数据集上,训练VQC模型也可能需要30分钟以上。这个训练时间主要是在量子计算机上准备和运行每个量子电路所需的时间。由于HNN模型由多个VQC单元组成,因此HNN的训练时间大于VQC的训练时间。在我们的测试数据集上,我们发现HNN的训练时间是VQC训练时间的3到5倍。
4.1Bars and Stripes数据集
条形和条纹是 二进制黑白图像的合成数据集。 数据集中的每个图像要么是“bar”,要么是“stripe”。 “bar”有 到 个水平行以黑色突出显示,“stripe”有 到 个垂直列以黑色突出显示。 在Bars and Stripes的某些变体中,还包括全白图像和全黑图像。 我们不包括这两个图像,因为它们的分类不明确。 总体而言,数据集包含 张图像。 在这些图像中, 是条纹, 是“bar”。 2 × 2 Bars and Stripes数据集的图像如图 4 所示。
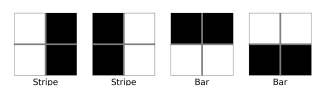
图4. 2 × 2 Bars and Stripes数据集。
我们使用 20 个批次梯度下降 epochs 以 0.5 的学习率在 2 ×2 Bars and Stripes数据集上训练了变分量子电路分类器和混合量子经典神经网络。 数据集中的所有 4 个点都用于训练。 模拟试验的结果见表一和图 5。量子试验的结果见表一。
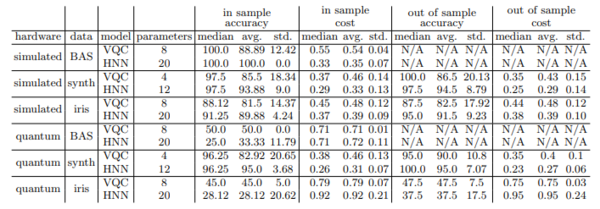
表 I. 变分量子电路 (VQC) 和混合神经网络 (HNN) 在 2 × 2 Bars and Stripes数据集 (BAS)、合成二维数据集 (synth) 和 虹膜数据集(iris)。平均值用avg表示。 相应的标准差用std表示。
在模拟硬件上,HNN每次测试都正确地分类每个点,而VQC偶尔会错误地分类一个或多个点。尽管如此,这两种模型平均都达到了很高的准确度。各模型平均精度的微小差异可能表明,该HNN体系结构对不利参数初始化具有更强的弹性。在量子硬件上,两种模型都表现不佳。 每个模型中所需的量子位和门的数量与数据集的维度成正比,因此可能是用于该数据集的量子电路太大而无法在现代硬件上准确执行。
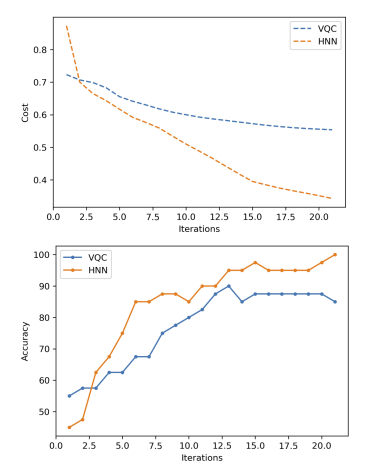
图5. 变分量子电路 (VQC) 和混合神经网络 (HNN) 在 2 × 2 Bars and Stripes 数据集上训练期间实现的平均成本和准确度。 所有图解试验均在模拟量子硬件上进行。
4.2模拟数据
我们还在使用 Sci-Kit Learn 的 make blobs() 函数生成的二维、线性可分数据集上训练了单个变分量子电路和混合量子经典神经网络。 这个合成数据集由 100 个数据点组成,平均分布在每个类之间。 在每个实验中,随机选择 100 个数据点中的 80 个用于训练。 训练包括 10 个小批量梯度下降 epoch,使用 16 个点的批量大小和 0.1 的学习率。 模拟试验的结果见表一和图 6。量子试验的结果见表一。

图 6. 在合成二维数据集上训练期间,变分量子电路 (VQC) 和混合神经网络 (HNN) 实现的平均成本和准确度。 所有图解试验均在模拟量子硬件上进行。
与bars and stripes数据集类似,HNN 和 VQC 在模拟硬件上都实现了高精度。 HNN 的平均准确率比 VQC 高大约 10%。 此外,HNN 的平均成本比 VQC 低 30% 以上。 这一次,两种模型在实际量子硬件上也都实现了高精度。 这并不奇怪,因为合成数据集是二维的,这意味着每个量子电路中需要的量子比特和逻辑门要少得多。
由于合成数据集是二维的,因此可以将每个量子模型学习到的分类线和概率分布可视化。在图7中,我们绘制了一个变分量子电路试验和一个混合神经网络试验的这个信息。之所以选择这两个例子,是因为它们的最终精度和最终成本值反映了相同模型类型的其他试验。此外,这两个例子在训练前都有大约 50% 的准确率。
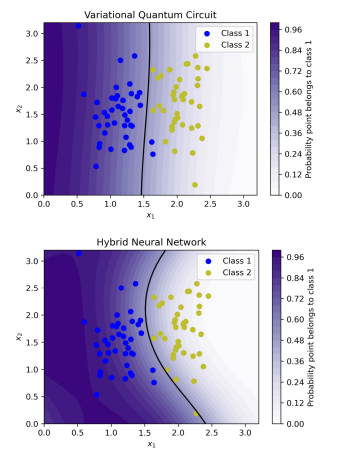
图7. 在二维线性可分数据集上训练的变分量子电路和混合神经网络的最终分类线和概率分布。
4.3iris 基准数据集
最后,我们在 iris 基准数据集的子集上训练了个体变分量子电路和混合量子经典神经网络。 iris 基准数据集由 150 个样本组成,平均分布在 3 种鸢尾花中。 每个虹膜样本由四个实值特征(萼片长度、萼片宽度、踏板长度、踏板宽度)表示。 我们在与 iris versicolor 和 iris virginica 物种相对应的 100 个样本上测试了这两个模型,其样本点是非线性可分的。 在每个实验中,随机选择 100 个数据点中的 80 个用于训练。 训练包括 10 个小批量梯度下降 epoch,使用 16 个点的批量大小和 0.1 的学习率。 模拟试验的结果见表一和图 8。量子试验的结果见表一。
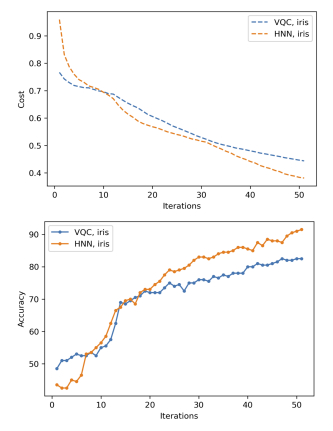
图8. 变分量子电路 (VQC) 和混合神经网络 (HNN) 在对 iris 数据集的子集进行训练期间实现的平均成本和准确度。 所有图解试验均在模拟量子硬件上进行。
平均而言,当使用模拟量子硬件时,HNN 的准确度比 VQC 高出大约 10%。 HNN 的平均成本值也比 VQC 低约 20%。 不幸的是,就像 Bars and Stripes 数据集一样,当使用量子硬件时,这两个模型的表现都非常糟糕。 同样,我们怀疑性能下降是由于 iris 数据集是四维的。
5.结论
在模拟硬件上,混合量子经典神经网络在精度和成本方面始终优于单个变分量子电路。 具体来说,平均准确度提高了 8% 到 11%,平均成本降低了 20% 到 40%。 值得注意的是,在训练数据集和测试数据集上都观察到了混合神经网络所取得的优势。 这表明它们不是过度拟合的产物。 图 7 中所示的学习伯努利分布给出了为什么混合量子经典神经网络能够实现更好性能的一些指示。 神经网络能够在分类线附近产生具有更陡峭梯度的概率分布。 这使神经网络能够比单个变分量子电路更确定地对点进行分类,从而有助于最大限度地降低成本。
混合神经网络比变分量子电路分类器表达能力更强,这并不令人惊讶,因为它的参数是变分量子电路分类器的两倍多。然而,增加机器学习模型的参数数量并不总能保证更好的结果,尤其是在考虑训练集之外的数据点时。 至少,所提出的混合神经网络架构说明了一种将参数添加到量子机器学习模型的有效方法。 一些测量表明,变分量子电路比经典神经网络架构更具表现力。 我们提出的混合量子经典神经网络架构说明了一种在处理更具挑战性的机器学习任务时利用这些优势的方法。
值得注意的是,当使用量子硬件时,变分量子电路分类器和混合神经网络在 iris 数据集和 Bars and Stripes 数据集上的表现都非常差。 这可能是因为量子比特的数量和所需门的数量与数据集的维度成正比。 增加量子比特的数量或增加门的数量会对现代量子计算的保真度产生不利影响。 未来的研究可能会在神经网络使用的变分量子电路中使用更复杂的特征图或 ansatz 进行调查。 此外,对学习率和批量大小的超参数优化进行更深入的研究可能有助于改善现代量子硬件的结果。 最后,可以针对更具挑战性的分类问题研究更大、更复杂的混合神经网络架构。
原文链接:https://arxiv.org/pdf/2201.01820.pdf
---煤油灯科技victorlamp.com翻译整理---