可解释性是机器学习研究和开发中最紧迫的问题之一,尽管当代大规模语言模型(LM)已经展示了令人印象深刻的问答能力,但它们固有的不透明性会掩盖这些模型是如何得出最终答案的,这使得用户很难发现任何可能的错误或证明输出的正确性。
DeepMind研究团队在新发表的《使用大型语言模型的忠实推理》(Faithful Reasoning Using Large Language Models)一文中解决了这一问题,提出了一个前向链接选择-推理模型,该模型可以进行忠实推理,并提供有效的推理跟踪,以提高推理质量,帮助用户检查和验证最终答案。
提出的方法基于这样的思想:如果给定问题的底层逻辑结构可以由因果结构反映,LM就可以执行忠实的多步推理。为了实现这一点,该团队开发了选择-推理(SI)作为系统的支柱,这是一个由两个经过微调的语言模型组成的新架构:一个用于选择,一个用于推理。
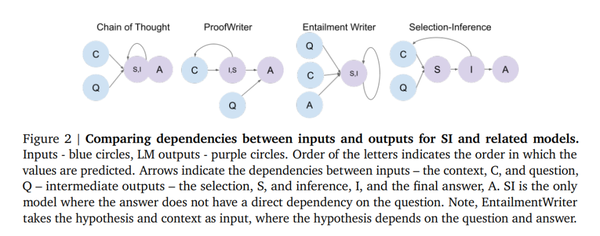
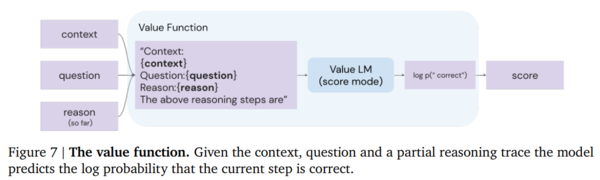
逐步前向推理主干将每个推理步骤分为两个部分:1)给定一个问题,选择模型首先从上下文中选择一组语句,2)推理模型然后从选择中计算一个语句来预测一个蕴意(推理)。这个推断被添加到上下文中以总结单个推理步骤。通过迭代这个SI过程,模型能够产生一个推理轨迹,而最终的推理用于回答问题。
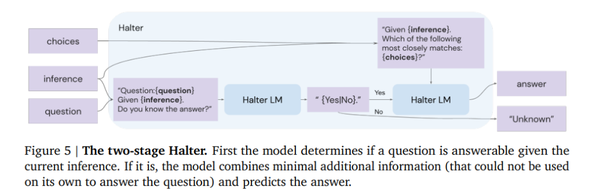
为了使模型能够确定何时停止推理,该团队引入了一个两阶段的halter,该halter利用微调过的语言模型来预测模型在给定当前推理的情况下是否能够回答给定的问题。如果模型不能自信地回答问题,它将继续进行另一个SI迭代;如果笼头的输出是一个答案,那么这个过程将被终止,并返回答案。如果SI循环继续进行预先指定的迭代次数而没有得到答案,系统将返回“未知”,而不是做出最佳猜测。
研究人员观察到,当模型认为它不能如实回答的问题被删除时,性能有了显著提高,并相信这种方法可以有助于提高模型在现实世界中的可信度和安全性,“在现实世界中,精确度(而不是回忆)是优先考虑的。”
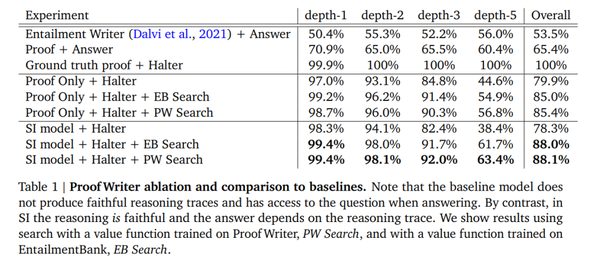
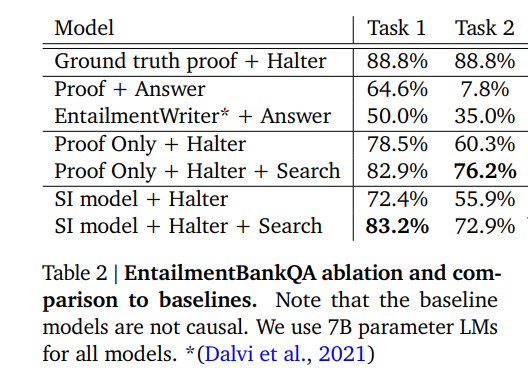
在他们的实证研究中,该团队将他们的SI系统与Proof Writer (PW)和EntailmentBankQA (EB)数据集上的基线模型进行了比较。提出的模型在PW和EB上的最终答案准确率分别达到88.1%和78.1%,大大超过基线模型。
总之,该工作表明,提出的方法可以在不牺牲模型性能的情况下,使用多步推理忠实地回答问题。虽然这项研究集中在给定上下文中的多步骤推理,但该团队计划在未来的工作中结合检索来填充上下文。
从实际性能来看,尽管存在“只能执行可信推理”的限制,该模型的实际表现仍然非常出色。考虑到如果一项技术要想安全普及、为大众所接受,就必须能够通过审计检验,此次研究可能代表语言模型正向着可解释性迈出重要一步。
论文《使用大型语言模型的忠实推理》(Faithful Reasoning Using Large Language Models)已发表在arXiv上。
