训练机器学习模型来有效地执行一项任务,比如图像分类,需要向模型展示数千、数百万甚至数十亿张示例图像。当涉及隐私时,收集如此庞大的数据集尤其具有挑战性,比如医学图像。来自麻省理工学院和麻省理工学院成立的初创公司DynamoFL的研究人员现在针对这个问题采取了一种流行的解决方案,即联邦学习,并使其更快、更准确。
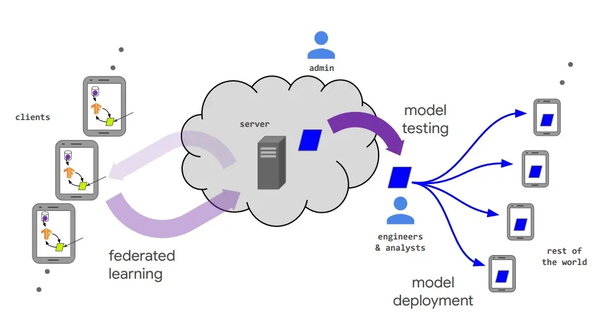
联邦学习是一种用于训练机器学习模型的协作方法,该模型可以保持敏感用户数据的私密性。成百上千的用户在自己的设备上使用自己的数据训练自己的模型。然后,用户将他们的模型传输到中央服务器,中央服务器将它们组合起来,提出一个更好的模型,并返回给所有用户。
例如,世界各地的一些医院可以使用这种方法训练机器学习模型,在医学图像中识别脑肿瘤,同时确保本地服务器上的患者数据安全。
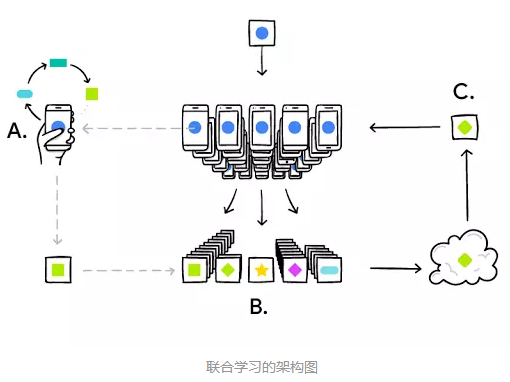
但是联邦学习也有一些缺点。在中央服务器之间传输一个大型的机器学习模型需要移动大量的数据,通信成本很高,尤其是模型必须来回发送几十次甚至数百次。另外,每个用户收集自己的数据,所以这些数据不一定遵循相同的统计模式,这妨碍了组合模型的性能。这个组合模型是通过取平均值得出的——它不是针对每个用户的个性化。
研究人员开发了一种技术,可以同时解决联邦学习的这三个问题。他们的方法提高了组合机器学习模型的准确性,同时显著减少了它的规模,这加快了用户和中央服务器之间的通信。它还确保每个用户接收到一个对他们的环境更个性化的模型,这提高了性能。
与其他技术相比,研究人员能够将模型的尺寸缩小近一个数量级,这导致个人用户的沟通成本降低了4到6倍,他们的技术也能够将模型的整体精度提高约10%。
“许多论文已经解决了联合学习的一个问题,但挑战是把所有这些放在一起,仅仅专注于个性化或通信效率的算法并不能提供足够好的解决方案。我们想要确保我们能够针对所有内容进行优化,这样这项技术就可以在现实世界中实际使用,”Vaikkunth Mugunthan博士说,他是一篇介绍这项技术的论文的主要作者。
Mugunthan与他的导师、计算机科学与人工智能实验室(CSAIL)的首席研究科学家Lalana Kagal共同撰写了这篇论文,这项工作将在欧洲计算机视觉会议上展示。
将模型切割成合适的尺寸
研究人员开发的系统被称为FedLTN,它依赖于机器学习中的一种被称为彩票假说的想法。这一假设认为,在非常大的神经网络模型中,存在着可以达到相同性能的小得多的子网,找到这些子网中的一个就像找到一张中奖的彩票(LTN代表“彩票网络”。)
神经网络在一定程度上基于人类大脑,是一种机器学习模型,它学习使用相互连接的节点层或神经元来解决问题。
寻找一个中奖彩票网络比简单的刮刮乐要复杂得多,研究人员必须使用一种称为迭代修剪的过程。如果模型的精度高于一个设定的阈值,它们就会删除节点和它们之间的连接(就像修剪灌木上的树枝一样),然后测试精简后的神经网络,看看准确性是否仍然高于阈值。
其他方法已经将这种修剪技术用于联邦学习,以创建更小的机器学习模型,可以更有效地迁移。但是,虽然这些方法可能会加快速度,但模型的性能会受到影响。
Mugunthan和Kagal应用了一些新技术来加速修剪过程,同时使新的、更小的模型更准确和个性化的每个用户。
他们通过避免修剪后的神经网络的剩余部分被“重绕”到原始值的步骤来加速修剪。Mugunthan解释说,在修剪之前,他们还训练了模型,这使它更准确,从而可以更快地修剪。
为了使每个模型对用户的环境更加个性化,他们小心翼翼地不删除网络中捕捉用户特定数据的重要统计信息的层。此外,当所有的模型都结合在一起时,它们利用了存储在中央服务器中的信息,所以每一轮通信都不是从零开始。
他们还开发了一种技术,可以减少使用资源有限设备的用户的通信轮数,比如使用慢速网络的智能手机。这些用户使用精简模型启动联邦学习过程,该模型已经被其他用户子集优化过。
当他们将FedLTN进行模拟测试时,它带来了更好的性能,并降低了通信成本。在一项实验中,传统的联邦学习方法生成了一个45兆字节大小的模型,而他们的技术生成了一个精度相同的模型,但只有5兆字节。在另一项测试中,一项最先进的技术需要12000兆字节的用户和服务器之间的通信来训练一个模型,而FedLTN只需要4500兆字节。
对于FedLTN,表现最差的客户仍然看到了超过10%的业绩增长。Mugunthan补充说,整体模型的准确性比最先进的个性化算法高出近10%。
现在他们已经开发并优化了FedLTN, Mugunthan正在努力将这项技术整合到他最近创建的联邦学习初创公司DynamoFL中。
今后,他希望继续加强这种方法。例如,研究人员已经证明使用有标签的数据集是成功的,但更大的挑战是将同样的技术应用到没有标签的数据上,他说。
Mugunthan希望这项工作能激励其他研究人员重新思考他们如何进行联邦学习。
“这项工作表明了从整体角度思考这些问题的重要性,而不仅仅是需要改进的单个指标。有时候,改善一个指标实际上会导致其他指标的下降。相反,我们应该专注于如何共同改善一系列事情,如果要在现实世界中部署,这是非常重要的。”他最后说。
原文链接:https://news.mit.edu/2022/collaborative-machine-learning-privacy-0907
