据《纽约时报》报道,数据中心使用的90%的能量都被浪费了,这是因为公司收集的大部分数据从未被分析或以任何形式使用,具体地说,这被称为“暗数据”。
“暗数据”是通过各种计算机网络操作获得的数据,但没有以任何方式用于获得见解或决策。一个组织收集数据的能力可能超过它分析数据的吞吐量,在某些情况下,组织可能甚至不知道数据正在被收集。IBM估计,大约90%由传感器和模数转换产生的数据从未被使用。——维基百科上的暗数据定义
从机器学习的角度来看,这些数据对获得任何见解都没有用的一个关键原因是缺乏标签,这使得无监督学习算法非常有吸引力,可以释放这些数据的潜力。
生成对抗的网络(GAN)
2014年,Ian Goodfellow等人提出了一种通过对抗过程估计生成模型的新方法。它涉及同时训练两个独立的模型,一个是Generator模型,它试图对数据分布进行建模,另一个是Discriminator模型,它试图根据生成器将输入分类为训练数据或假数据。
这篇论文在现代机器学习领域树立了一个非常重要的里程碑,为无监督学习开辟了新的途径。深度卷积GAN论文(Radford et al. 2015)通过应用卷积网络原理成功地生成2D图像,在这一思想的基础上继续发展。
通过本文,我试图解释论文中的关键组件,并使用PyTorch来实现它们。
GAN有什么特别之处?
为了理解GAN或DCGAN的重要性,让我们看看是什么让它们如此受欢迎。
- 由于GAN的无监督学习特性使它们非常适合这种用例,因为大部分真实世界的数据都是未标记的。
- Generator和Discriminator作为非常好的特征提取器,用于使用有限的标记数据或生成额外的数据来改进二次模型训练的用例,因为它们可以生成假样本而不是使用增强。
- GAN提供了极大似然技术的替代方案,它们的对抗性学习过程和非启发式代价函数使得它们对强化学习非常有吸引力。
- 关于GAN的研究非常有吸引力,其结果一直是关于ML/DL影响的广泛争论的来源。例如,Deepfake是GAN技术的一个应用,它可以将人们的脸覆盖在目标人物身上,这在本质上是非常有争议的,因为它有可能被用于邪恶目的。
- 最后但也是最重要的一点是,用它来工作真的很酷,而且该领域的所有新研究都令人着迷。
体系结构
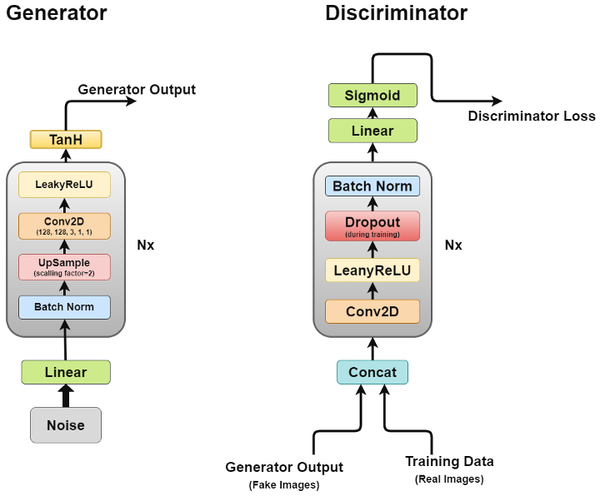
深度卷积GAN的架构
正如我们前面所讨论的,我们将通过DCGAN工作,它试图实现GAN的核心思想,使卷积网络能够生成逼真的图像。
DCGAN由两个独立的模型组成,一个是Generator (G),它试图将随机噪声向量建模为输入,并试图学习数据分布来生成假样本,另一个是Discriminator (D),它将训练数据(真实样本)和生成数据(假样本)进行分类,这两个模型之间的斗争就是我们所说的对抗训练过程,一方的损失是另一方的利益。
生成器
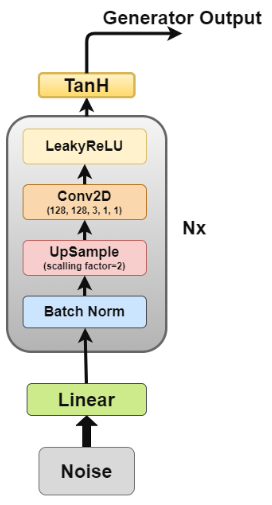
生成器是我们最感兴趣的一个方面,因为它是一个生成假图像,试图欺骗鉴别器。
现在让我们更详细地了解生成器体系结构:
- 线性层:噪声矢量被输入到一个全连通层,该层的输出被重塑为一个4D张量。
- 批处理归一化层:通过将输入归一化为零均值和单位方差来稳定学习,这避免了训练问题,如消失或爆发梯度,并允许梯度在网络中流动。
- 上采样层:根据我对这篇论文的解释,它提到了使用上采样,然后在上面应用一个简单的卷积层,而不是使用卷积转置层来上采样。但我见过有人用卷积转置。
- 2D卷积层:当我们对矩阵进行上采样时,我们让它通过一个步幅为1的卷积层,并使用相同的填充,以允许它从上采样的数据中学习
- ReLU层:文中提到使用ReLU代替LeakyReLU作为生成器,因为它可以让模型快速饱和,覆盖训练分布的颜色空间。
- TanH激活:本文建议我们使用TanH激活函数来进行生成器输出,但没有详细说明原因,如果我们必须猜测的话,这可能是因为TanH的性质允许模型更快地收敛。
第2至5层构成核心生成块,可重复N次以获得所需的输出图像形状。
下面是我们如何在PyTorch中实现它:
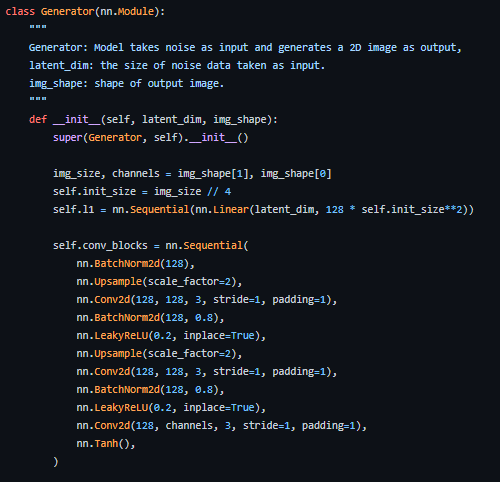
使用PyTorch框架的生成器实现关键代码
鉴别器
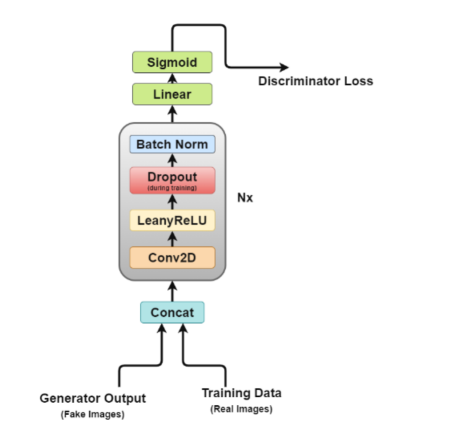
鉴别器架构图
现在鉴别器很像一个图像分类网络,只是做了一些细微的调整,例如,它不使用任何池化层来进行下采样,而是使用一个跨卷积层来学习自己的下采样。
让我们更详细地了解鉴别器体系结构:
- Concat层:该层将假图像和真实图像在单个批处理中合并,以提供鉴别器,但这也可以单独完成,只获得生成器损失。
- 卷积层:我们在这里使用一个步幅卷积,它允许我们在单次通过中对图像进行下采样和学习滤波器。
- LeakyReLU:正如这篇论文提到的,它发现与原始GAN论文的最大输出函数相比,LeakyReLU对于鉴别器非常有用,因为它允许更容易的训练。
- Dropout:仅用于训练,有助于避免过拟合。模型有记忆真实图像数据的倾向,训练可能会崩溃,因为识别器不能再被生成器欺骗
- 批处理归一化:文中提到它在除第一个鉴别器块外的每个鉴别器块的末尾应用批处理归一化。文中提到的原因是对每一层进行批处理归一化会导致样本振荡和模型不稳定。
- 线性:一个完全连接的层,它从应用过的2D批处理归一化层获得一个重塑向量。
- Sigmoid激活:当我们处理识别器输出的二进制分类时,做出一个Sigmoid层的逻辑选择。
第2层到第5层组成核心鉴别器块,可以重复N次,使每个训练数据的模型更复杂。
下面是我们如何在PyTorch中实现它:
对抗训练
我们训练鉴别器(D),使给训练示例和生成器(G)中的样本分配正确标签的概率最大化,这可以通过最小化log(D(x))来实现。我们同时训练G最小化log(1−D(G(z))),其中z为噪声向量。也就是说,D和G对值函数V (G, D)进行如下的二人极小极大对策:
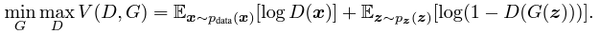
对抗成本函数
在实际应用中,上述公式可能无法提供足够的梯度,使G能够很好地学习。在学习早期,当G较差时,D可以拒收高置信度的样本,因为样本与训练数据明显不同。在这种情况下,log(1−D(G(z)))饱和。我们可以训练G使logD(G(z))最大化,而不是训练G使log(1−D(G(z)))最小化。这个目标函数的结果是G和D的动态不动点相同,但在学习早期提供了更强的梯度。
由于我们同时训练两个模型,这可能很棘手,而且GANs是出了名的难以训练,我们稍后将讨论的一个已知问题称为模式崩溃。
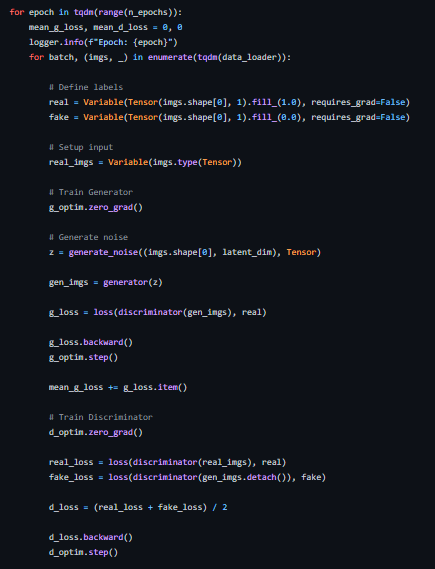
本文建议使用学习率为0.0002的Adam优化器,如此低的学习率表明GANs往往发散得非常快。它还使用值为0.5和0.999的一阶和二阶动量来进一步加速训练。模型初始化为正态权分布,均值为0,标准差为0.02。
下面是我们如何实现一个训练循环:
模式崩溃
理想情况下,我们希望生成器产生各种各样的输出,例如,如果它生成一个脸,它应该为每个随机输入生成一个新脸。但是,如果生成器产生一个合理的输出,好到足以欺骗鉴别器,它可能会不断地产生相同的输出。
最终生成器会对单个鉴别器进行过度优化,并在一小组输出之间旋转,这种情况称为模式崩溃。
以下方法可以用来补救这种情况。
- Wasserstein损耗:Wasserstein损耗通过让你训练鉴别器达到最优而不用担心梯度消失来缓解模式崩溃。如果鉴别器没有卡在局部极小值,它就会学习拒绝生成器所依赖的输出。所以,生成器必须尝试一些新的东西。
- 展开的GANs:展开的GANs使用生成器损失函数,该函数不仅包含当前鉴别器的分类,还包含未来鉴别器版本的输出。因此,生成器不能对单个鉴别器进行过度优化。
应用程序
- 风格转换:如今,面部修饰应用都很火,脸部老化、哭脸、名人脸只是社交媒体上已经广泛流行的一些应用。
- 电子游戏:3D物体的纹理生成和使用图像的场景生成只是帮助电子游戏产业更快开发更大游戏的一些应用程序。
- 电影工业:CGI一直是模型电影的重要组成部分,有了GAN带来的潜力,电影制作者现在可以有比以往更大的梦想。
- 语音生成:一些公司正在使用GANs来改进文本到语音的应用程序,通过使用它们来生成更真实的声音。
- 图像恢复:使用GANs去噪和恢复损坏的图像,为历史图像着色,通过产生缺失帧来改进旧视频以提高其帧率。
结论
GAN和DCGAN是一篇里程碑式的论文,开辟了无监督学习的新途径。对抗训练方法提供了一种训练模型的新方法,这种训练模型非常接近真实世界的学习过程,了解看看这个领域如何发展将是非常有趣的事。
原文链接:https://towardsdatascience.com/implementing-deep-convolutional-gan-f76e9b9af270
论文链接:https://arxiv.org/abs/1511.06434
完整源码:https://github.com/akash-agni/ReadThePaper/tree/main/DCGAN
