随着我们从有远见的研究转向可部署的技术,如自动驾驶汽车、临床预测模型和新颖的可访问设备,人工智能系统正变得越来越复杂。与单一的AI模型不同,更难评估这些更复杂的 AI 系统是否始终如一地执行并按照预期实现人类利益。
是什么让人工智能系统变得复杂?
我们是如何知道这些更先进的系统什么时候“足够好”的?在评估AI模型的性能时,我们通常依赖于诸如准确率百分比等综合性能指标,但这忽略了构成人工智能系统的许多因素,这通常是人为因素。
我们关于如何构建前瞻性、包容性AI体验的研究表明,要达到“足够好”,需要基于实际数据和关键用户需求在开发生命周期的不同阶段采用多种性能评估方法(图1)。
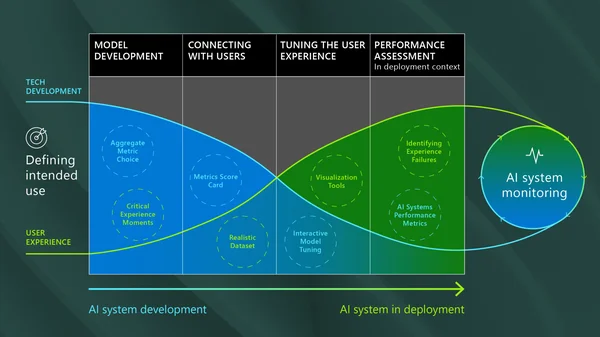
图 1:复杂 AI 系统在整个开发生命周期中的性能评估方法以不同于通用 AI 的方式发生变化,重点从需要在开发过程开始时易于计算的总体性能指标的快速技术创新转变为反映最终支持用户体验所需的关键人工智能系统属性的性能指标。
将重点从AI模型本身的迭代调整逐渐转移到改善整个AI系统的方法,不仅涉及如何评估性能,还涉及谁应该参与到性能评估过程中。尽早聘用(和培训)非技术领域专家(例如,选择测试数据或定义体验指标),并在整个开发生命周期中以更大的能力聘用(和培训)非技术领域专家,可以增强AI系统的相关性、可用性和可靠性。
来自PeopleLens评估的最佳实践
PeopleLens(图2)是微软的一项新技术,旨在使天生失明的儿童体验社会互动性,并建立发起和维持社会互动所需的一系列社会注意技能。它安装在智能眼镜上,通过空间音频为佩戴者提供周围人的持续实时信息,帮助他们建立他人的动态行踪地图。它的基础技术是一个复杂的人工智能系统,使用几种计算机视觉算法来计算、摆姿势、识别注册人员,并随着时间的推移跟踪这些实体。
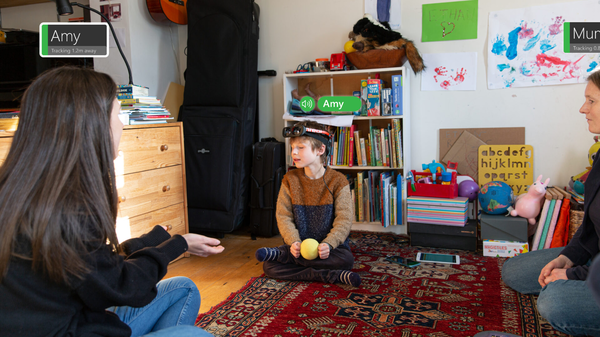
图 2:PeopleLens 是一项新的研究技术,旨在通过实时动态定位和识别空间中的人,帮助盲人或视力低下的人更好地了解他们所处的社会环境。
- 入门:AI模型还是AI系统性能?
在开源基准数据集上计算聚合性能指标可能展示单个AI模型的能力,但在应用于整个AI系统时可能不够,人们很容易相信单一的聚合性能指标(如准确性)足以单独验证多个AI模型。但是,一个系统中两个AI模型的性能不能通过简单地将每个模型的总体性能指标相加来全面衡量。
我们使用两个AI模型来测试PeopleLens定位和识别人的准确性:第一个是基准的、最先进的姿态模型,用于指示图像中人的位置。第二种是一种新颖的面部识别算法,此前被证明准确率超过90%。尽管这两种模型的历史表现很好,但当应用到PeopleLens时,AI系统只从现实数据集中识别了10%的人,而在现实数据集中,人们并不总是面对镜头。
这一发现说明,多算法系统不仅仅是它们各部分的总和,需要特定的性能评估方法。
- 连接到人类经验:指标记分卡和现实数据
在AI系统仍在经历重大技术迭代时,基于现实参考数据集计算的指标记分卡提供了一种与人类体验相连接的方法。指标记分卡可以将多个指标组合起来,以度量对用户最重要的系统方面。
我们在PeopleLens的开发中使用了10个指标。最有价值的两个指标是第一次识别的时间(time-to-first identification)和重复误报的次数(repeat false positive),前者衡量的是从一个帧中看到一个人到用户听到这个人的名字需要多长时间),后者衡量的是在参考数据集中连续三帧或更多帧中出现误报的频率。
第一个指标抓住了用户的核心价值主张:当有人接近时,拥有第一个打招呼的社交代理。第二点很重要,因为AI系统会自我纠正单个错误,而重复错误会导致糟糕的用户体验。这是在整个系统中测量精度的结果,而不仅仅是每帧。
- 超越指标:使用可视化工具调整用户体验
虽然指标在AI系统的开发中发挥着关键作用,但还需要更广泛的工具来微调预期的用户体验。开发团队必须在真实的数据集上进行测试,以理解AI系统如何生成实际的用户体验。这在复杂系统中尤为重要,因为在复杂系统中,多个模型、人-AI反馈循环或不可预测的数据(例如,用户控制的数据捕获)都可能导致AI系统做出不可预测的响应。
可视化工具可以增强数据科学家的自顶向下的统计工具,帮助领域专家对系统开发做出贡献。在PeopleLens中,我们使用定制的可视化工具来比较具有不同模型参数的体验的并排呈现(图3)。我们利用这些可视化使领域专家(在本例中是家长和教师)能够发现数据中奇怪的系统行为的模式。
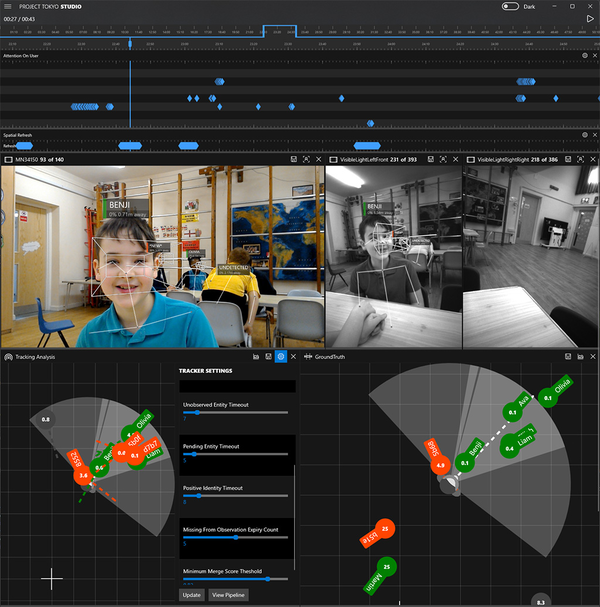
图 3:可视化工具帮助开发团队(包括领域专家)使用真实数据将 AI 系统与用户体验联系起来。在此图像中,顶部栏显示了从可穿戴相机流中获取的图像,并覆盖了各种模型结果。底栏左侧显示世界状态跟踪算法的输出,右侧显示基本事实。中间的面板显示了正在更改的模型参数,这些参数对实时查看的用户体验产生了影响。
- 用户体验背景下的AI系统性能
用户体验只能和底层AI系统一样好。在现实环境中测试AI系统,衡量对用户重要的东西,是广泛部署之前的关键阶段。例如,我们知道AI系统性能的提高并不一定对应于AI团队性能的提高。
我们还知道,人与人工智能之间的反馈循环会让衡量人工智能系统的性能变得困难。从本质上说,AI系统和用户之间的重复交互,这些反馈循环会使错误浮出水面(并加剧)。通过良好的可理解性,它们也可以由用户进行修复。
PeopleLens系统向用户反馈人物的位置和相貌。一旦用户对反馈做出回应(例如,通过抬头),就可以解决遗漏的识别(例如,因为这个人在看胸部而不是脸)。这个例子告诉我们,我们不需要专注于遗漏的识别,因为它们将由人类—AI反馈循环解决。然而,用户对识别那些不再存在的人非常困惑,因此性能评估需要关注这些误报的错误识别。
结语
对于复杂的AI系统,性能评估方法在开发生命周期中以不同于单个AI模型的方式变化,将性能评估技术从在开发过程开始时需要易于计算的综合指标的快速技术创新,转变为在开发结束时反映构成用户体验的关键AI系统属性的性能指标,可以帮助每种类型的利益相关者精确和集体地定义什么是“足够好”的,以实现预期的用途。
对于开发人员来说,记住性能评估本身并不是最终目标是很有用的;这个过程定义了系统如何达到最佳状态,以及该状态是否已准备好进行部署。绩效评估过程必须包括广泛的利益相关者,包括领域专家,他们可能需要新的工具来完成AI系统开发和部署中的关键角色。