摘要
近年来,卷积网络监督学习(CNN)在计算机视觉应用中得到了广泛应用。相比之下,使用CNN的无监督学习受到的关注较少。在这项工作中,我们希望帮助弥合CNN在监督学习和非监督学习方面的成功之间的差距。我们介绍了一类被称为深度卷积生成对抗网络(DCGANs)的CNN,它具有一定的体系结构约束,并证明了它们是无监督学习的有力候选。在各种图像数据集上进行训练,我们展示了令人信服的证据,证明我们的深度卷积对抗在生成器和鉴别器中都学习了从对象部分到场景的表示层次。此外,我们将学习到的特征用于新的任务——演示它们作为一般图像表示的适用性。
1 介绍
从大型未标记数据集中学习可重用特征表示一直是一个活跃的研究领域。在计算机视觉的环境中,人们可以利用几乎无限数量的未标记图像和视频来学习良好的中间表示,然后可以用于各种监督学习任务,如图像分类。我们提出,构建良好图像表示的一种方法是训练生成对抗网络(GAN) ,然后重用生成器和鉴别器网络的部分作为监督任务的特征提取器。相对于最大似然技术,GAN提供了一种有吸引力的替代方案。此外,人们还可以认为,它们的学习过程和缺乏启发式成本函数(如像素明智的独立均方误差)对表示学习具有吸引力。众所周知,训练GANs是不稳定的,经常导致生成器产生无意义的输出。在试图理解和可视化GANs学习的内容以及多层GANs的中间表示方面,目前已发表的研究非常有限。
在本论文中,我们做出了以下贡献:
- 我们提出并评估了卷积GANs的体系结构拓扑上的一组约束,使它们在大多数设置下训练稳定,我们将这类体系结构命名为深度卷积GANs (DCGAN)
- 我们使用训练过的鉴别器进行图像分类任务,表现出与其他无监督算法的竞争性能。
- 我们将GANs学到的过滤器可视化,并通过经验证明特定的过滤器学会了绘制特定的对象。
- 我们展示了生成器具有有趣的向量算术特性,允许对生成样本的许多语义质量进行轻松操作。
2 相关工作
2.1无标签数据的表示学习
在一般的计算机视觉研究中,以及在图像环境中,无监督表示学习是一个研究得相当深入的问题。无监督表示学习的一个经典方法是对数据进行聚类(例如使用K-means),并利用聚类来提高分类分数。在图像环境中,可以对图像补丁进行分层聚类,以学习强大的图像表示。另一种流行的方法是训练自动编码器(卷积、堆叠、分离代码的“什么”和“在哪里”组件、阶梯结构,将图像编码成紧凑的代码,并解码代码以尽可能准确地重建图像。这些方法也被证明可以从图像像素中学习良好的特征表示,深度信念网络也被证明在学习等级表示方面工作良好。
2.2生成自然图像
生成图像模型得到了很好的研究,分为两类:参数化和非参数化。
非参数模型通常从现有图像数据库中进行匹配,通常是匹配图像的补丁,并已用于纹理合成、超分辨率和绘画。
用于生成图像的参数模型已经被广泛研究(例如MNIST数字或纹理合成)。然而,直到最近,生成真实世界的自然图像才取得了很大的成功。一种用于生成图像的变分采样方法已经取得了一些成功,但样本往往存在模糊的问题。另一种方法使用迭代正向扩散过程生成图像。生成对抗网络生成的图像存在噪声和不可理解的问题。对该方法的拉普拉斯金字塔扩展显示了更高质量的图像,但由于在链接多个模型时引入的噪声,它们仍然受到物体看起来摇晃的影响。循环网络方法和反卷积网络方法最近也在生成自然图像方面取得了一些成功。但是,他们没有将生成器用于监督任务。
2.3可视化CNN内部结构
对使用神经网络的一个持续的批评是,它们是黑箱方法,很少了解网络以简单的人类可消费算法的形式做什么。在CNN的背景下,Zeiler et. al.表明,通过使用反卷积和过滤最大激活,可以找到网络中每个卷积滤波器的大致目的。类似地,在输入上使用梯度下降可以让我们检查激活某些过滤器子集的理想图像。
3 方法和模型体系结构
历史上使用CNN对图像进行建模的尝试都没有成功,这促使LAPGAN 的作者开发了一种替代方法来迭代提升低分辨率生成的图像,可以更可靠地建模。我们还遇到了使用在监督文献中常用的CNN体系结构来扩展GANs的困难。然而,在广泛的模型探索之后,我们确定了一个体系结构家族,它可以在一系列数据集上进行稳定的训练,并允许训练更高的分辨率和更深的生成模型。
我们方法的核心是采用和修改CNN体系结构中最近演示的三个更改:
第一种是全卷积网络,它用跨步卷积代替确定性的空间池函数(如maxpooling),允许网络学习自己的空间下采样。我们在生成器中使用这种方法,允许它学习自己的空间上采样和鉴别器。
其次是在卷积特征之上消除完全连通层的趋势,最有力的例子是在先进的图像分类模型中使用的全球平均池。我们发现全球平均汇集增加了模型的稳定性,但降低了收敛速度,将最高卷积特征分别与生成器和鉴别器的输入和输出直接连接的中间方法效果很好,GAN的第一层,它采用均匀的噪声分布Z作为输入,可以称为全连通,因为它只是一个矩阵乘法,但结果被重塑为一个四维张量,并用作卷积堆栈的开始。对于鉴别器,最后一个卷积层被压平,然后输入一个单sigmoid输出。参见图1的示例模型体系结构的可视化。
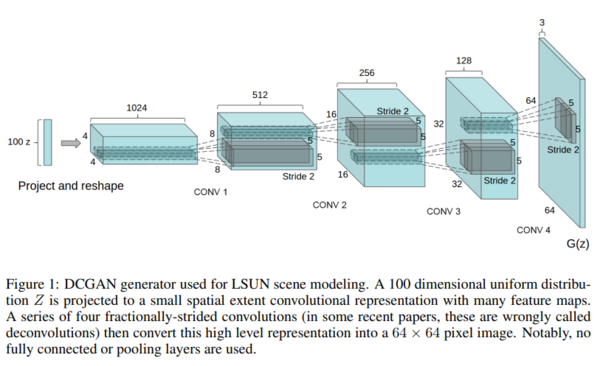
图 1:用于 LSUN 场景建模的 DCGAN 生成器。100 维均匀分布Z被投影到具有许多特征图的小空间范围卷积表示。一系列四个小步长卷积(在最近的一些论文中,这些被错误地称为反卷积)然后将这个高级表示转换为64×64像素图像。值得注意的是,没有使用完全连接或池化层。
第三种是批归一化,它通过将每个单元的输入归一化,使其均值和单位方差为零来稳定学习。这有助于处理由于糟糕的初始化而产生的训练问题,并有助于更深层次模型中的梯度流。这对于让深层生成器开始学习至关重要,防止生成器将所有样本压缩到一个点,这是GANs中观察到的常见故障模式。然而,直接将批范数应用于所有层,会导致样本振荡和模型不稳定,这可以通过不对生成器输出层和鉴别器输入层应用batchnorm来避免。
除输出层使用Tanh函数外,生成器使用ReLU激活。我们观察到,使用有界激活可以让模型更快地学习饱和和覆盖训练分布的颜色空间。在鉴别器中,我们发现漏修正激活工作良好,特别是对于高分辨率建模。这与最初的GAN论文形成对比,后者使用了最大输出激活。
4 对抗训练的细节
我们在三个数据集上训练DCGANs:大规模场景理解(LSUN) 、Imagenet-1k和一个新组装的Faces数据集,下面详细介绍了这些数据集的用法。
除了缩放到tanh激活函数[- 1,1]的范围外,对训练图像不进行预处理。所有模型均采用小批随机梯度下降(SGD)训练,小批大小为128。所有权值初始化均为零心正态分布,标准差为0.02。在LeakyReLU中,所有模型的泄漏斜率都设置为0.2。虽然之前的GAN工作使用动量来加速训练,但我们使用了带有调优超参数的Adam优化器。我们发现建议的学习速率0.001太高了,用0.0002代替。此外,我们发现将动量项β1保持在建议值0.9会导致训练振荡和不稳定,而将其减少到0.5则有助于稳定训练。
4.1 LSUN(大规模图像数据集)
随着生成图像模型样本视觉质量的提高,对训练样本过拟合和记忆的担忧也在增加。为了演示我们的模型如何在更多数据和更高分辨率生成的情况下扩展,我们在LSUN卧室数据集上训练了一个模型,其中包含略多于300万个训练示例。最近的分析表明,模型学习的速度和它们的泛化性能之间有直接的联系。除了收敛后的样本(图3)外,我们还展示了模拟在线学习的一个训练阶段的样本(图2),以此证明我们的模型不能通过简单的过拟合/记忆训练样本产生高质量的样本,未对图像进行数据增强。
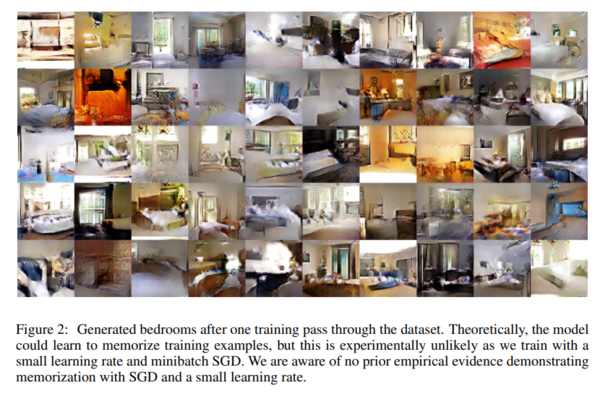
图 2:一次训练通过数据集后生成的卧室。从理论上讲,该模型可以学习记忆训练示例,但这在实验上不太可能,因为我们使用较小的学习率和小批量 SGD 进行训练。我们知道没有先前的经验证据表明使用 SGD 和小学习率进行记忆。
重复数据删除
为了进一步降低生成器记忆输入示例的可能性(图2),我们执行了一个简单的图像去重复处理。我们将一个3072-128-3072去噪衰减正则化RELU自编码器安置在训练示例的32x32下采样中心作物上。ReLU激活被证明是一种有效的信息保存技术,并提供了一种方便的语义哈希形式,允许线性时间去重复。哈希碰撞的视觉检查显示了较高的精确度,估计误报率低于1 / 100。此外,该技术检测并删除了大约27.5万个近重复的单词,这表明召回率很高。
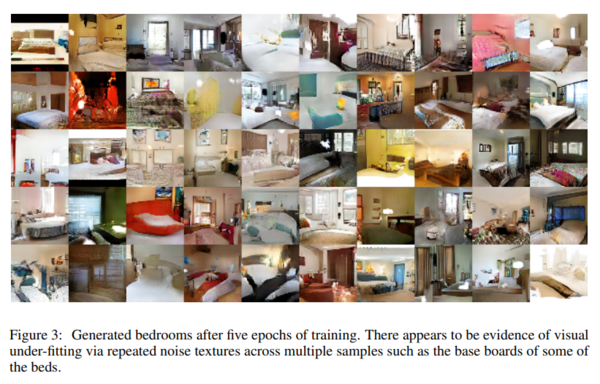
图 3:经过五个训练阶段后生成的卧室。通过多个样本(例如一些床的底板)的重复噪声纹理,似乎存在视觉欠拟合的证据。
4.2 人脸
我们从网上对人名的随机查询中抓取了包含人脸的图片。这些人的名字来自dbpedia,以他们出生于时代为标准。这个数据集有来自1万人的3M张图片。我们在这些图像上运行OpenCV人脸检测器,保持足够高的分辨率,这给了我们大约35万个人脸盒,我们用这些脸盒进行训练,未对图像进行数据增强。
4.3 IMAGENET-1K
我们使用 Imagenet-1k 作为无监督训练的自然图像来源。我们训练32×32最小调整大小的中心作物,没有对图像应用数据增强。
5 DCGAN 能力的经验验证
5.1 使用 GAN 作为特征提取器对 CIFAR-10 进行分类
评估无监督表示学习算法质量的一种常见技术是将它们作为有监督数据集的特征提取器,并评估在这些特征上拟合的线性模型的性能。
在CIFAR-10数据集上,使用K-means作为特征学习算法的经过良好调优的单层特征提取管道展示了非常强的基线性能。当使用大量的特征映射(4800)时,该技术可以达到80.6%的准确性,基础算法的无监督多层扩展达到82.0%的精度。为了评估DCGANs学习到的用于监督任务的表示的质量,我们在Imagenet-1k上进行训练,然后使用来自所有层的鉴别器的卷积特征,对每层表示进行最大池化,生成一个4 × 4的空间网格。然后将这些特征进行平铺和拼接,形成一个28672维的向量,并在此基础上训练正则化线性L2-SVM分类器。这达到了82.8%的准确性,优于所有基于k均值的方法。值得注意的是,与基于K-means的技术相比,鉴别器拥有更少的特征映射(最高层为512),但由于4 × 4空间位置的许多层,其结果是更大的总特征向量大小。DCGANs的性能仍然低于范例CNN ,范例CNN是一种以无监督的方式训练普通辨别cnn的技术,以区分从源数据集中专门选择的、积极增强的范例样本。可以通过微调鉴别器的表示来进行进一步的改进,但我们将此留给以后的工作。此外,由于我们的DCGAN从未在CIFAR-10上进行过训练,本实验还展示了学习到的特征的域鲁棒性。
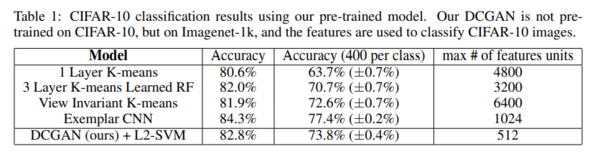
表 1:使用我们预训练模型的 CIFAR-10 分类结果。我们的 DCGAN 不是在 CIFAR-10 上进行预训练,而是在 Imagenet-1k 上进行预训练,这些特征用于对 CIFAR-10 图像进行分类。
5.2 使用GANS作为特征提取器对SVHN数字进行分类
在StreetView房号数据集(SVHN)上,当标记数据稀缺时,我们使用DCGAN鉴别器的特征进行监督。遵循与CIFAR-10实验中类似的数据集准备规则,我们从非额外集中分离出10,000个示例的验证集,并将其用于所有超参数和模型选择。随机选取1000个一致类分布训练例,在CIFAR-10使用的相同特征提取管道上训练正则化线性L2-SVM分类器。这在22.48%的测试误差下达到了最先进的水平(对于使用1000个标签的分类),改进了另一种旨在利用无标记数据的CNNs修改。此外,我们验证DCGAN中使用的CNN架构不是模型性能的关键贡献因素,方法是在相同数据上训练一个具有相同架构的纯监督CNN,并通过64次超参数试验的随机搜索优化该模型,其验证误差显著高于28.87%。
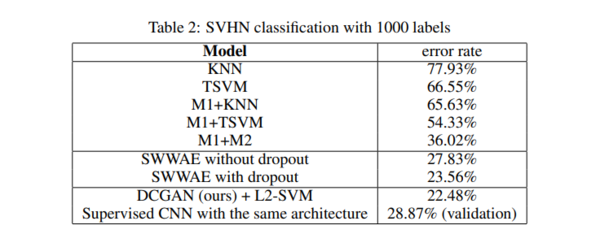
表 2:具有 1000 个标签的 SVHN 分类
6 调查和可视化网络的内部结构
我们用不同的方法研究训练过的生成器和鉴别器,我们不会在训练集中做任何最近邻搜索。像素或特征空间中最近的邻居会被小的图像变换所欺骗,我们也不使用对数似然度量来定量评估模型,因为这是一个糟糕的度量。
6.1 潜行空间
我们做的第一个实验是了解潜在空间的景观,走在学习的流形上,通常可以告诉我们记忆的迹象(如果有尖锐的过渡),以及空间是如何分层瓦解的。如果在这个潜在空间中行走导致图像生成的语义变化(例如添加和删除对象),我们可以推断模型已经学习了相关的和有趣的表示。结果如图4所示。
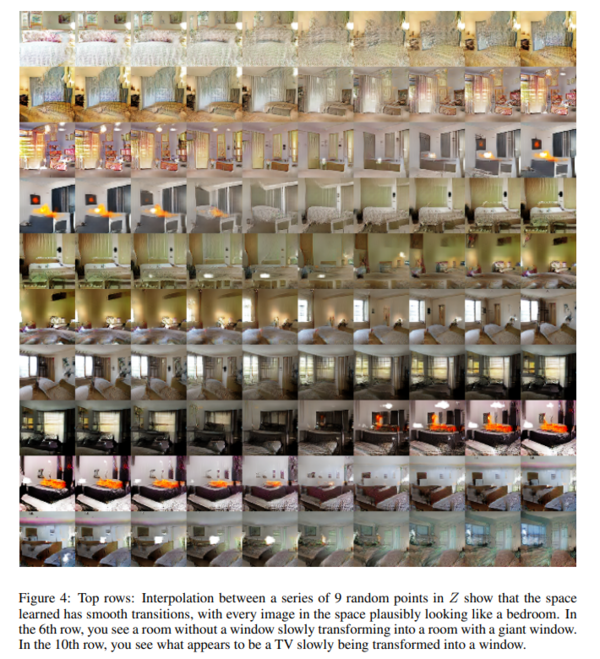
图 4:顶行:一系列 9 个随机点之间的插值Z表明学习到的空间具有平滑的过渡,空间中的每张图像看起来都像是卧室。在第六排,你看到一个没有窗户的房间慢慢地变成了一个有巨大窗户的房间。在第 10 排,您会看到看似电视的东西正在慢慢变成窗户。
6.2 可视化鉴别器特征
之前的工作已经证明,在大型图像数据集上监督训练CNN会产生非常强大的学习特征。此外,经过场景分类训练的受监督cnn学习目标检测器(Oquab et al., 2014)。我们演示了在大型图像数据集上训练的无监督DCGAN也可以学习有趣的特征层次结构。使用(Springenberg et al., 2014)提出的引导反向传播,我们在图5中展示了鉴别器学习到的特征在卧室的典型部分上被激活,如床和窗户。为了进行比较,在同一图中,我们给出了随机初始化的特性的基线,这些特性在语义相关或感兴趣的任何东西上都没有被激活。
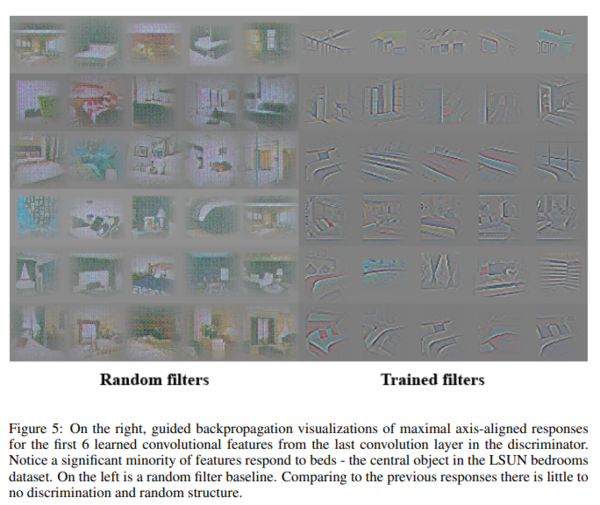
图 5:右侧,来自判别器中最后一个卷积层的前 6 个学习卷积特征的最大轴对齐响应的引导反向传播可视化。请注意,少数特征响应床——LSUN 卧室数据集中的中心对象。左侧是随机过滤器基线。与以前的反应相比,几乎没有歧视和随机结构。
6.3 操作生成器表示
忘记绘画某些对象
除了鉴别器学习的表示之外,还有生成器学习的表示的问题。样本的质量表明,生成器学习主要场景组件的特定对象表示,如床、窗户、灯、门和杂项家具。为了探索这些表示的形式,我们进行了一个实验,试图从生成器中完全删除窗口。
在150个样本上,手工绘制了52个窗口边界框。在第二高的卷积层特征上,逻辑回归适合于预测一个特征激活是否在窗口上(或不),使用的准则是,在绘制的边界框内的激活是正的,来自相同图像的随机样本是负的。使用这个简单的模型,所有权重大于0(总共200)的特征图都从所有空间位置上删除。然后,在去除特征图和不去除特征图的情况下,随机生成新的样本。
生成的有和没有窗口落差的图像如图6所示,有趣的是,网络大多忘记画卧室的窗户,取而代之的是其他物体。
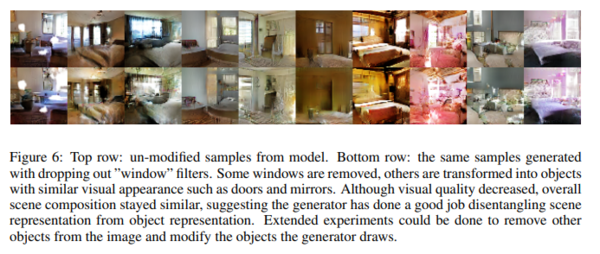
图 6:顶行:模型中未修改的样本。底行:使用丢弃“窗口”过滤器生成的相同样本。一些窗户被移除,其他窗户被转换成具有相似视觉外观的物体,例如门和镜子。尽管视觉质量下降,但整体场景构成保持相似,这表明生成器在将场景表示与对象表示分离方面做得很好。可以进行扩展实验以从图像中删除其他对象并修改生成器绘制的对象。
人脸样本的向量算法
在评估单词的学习表示的背景下证明了简单的算术运算揭示了表示空间中丰富的线性结构。一个典型的例子表明,向量(“King”)-向量(“Man”)+向量(“Woman”)的结果是一个向量,其最近的邻居是“Queen”的向量,我们研究了生成器的Z表示中是否出现了类似的结构。我们对视觉概念样本集合的Z向量进行了类似的运算,仅对每个概念的单个样本进行的实验是不稳定的,但对三个样本的Z向量进行平均显示出一致和稳定的代,在语义上服从算术。除了如图7所示的对象操作外,我们还演示了在Z空间中对面部姿势进行线性建模(图8)。
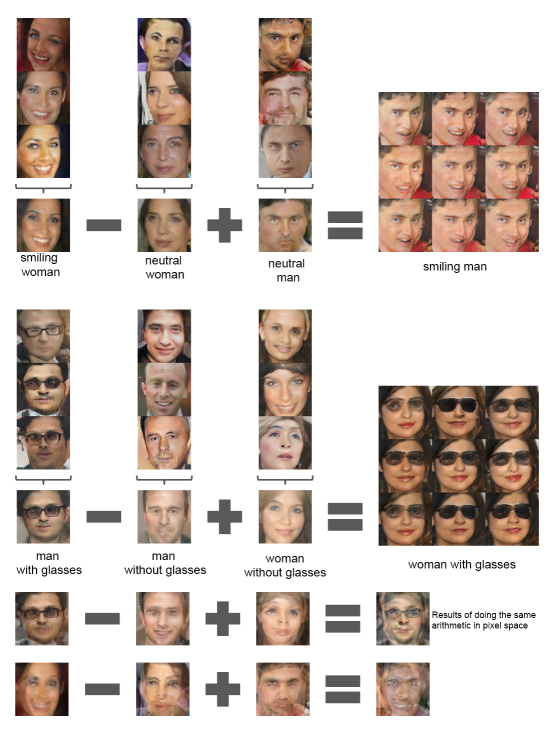
图 7:视觉概念的向量算术。对于每一列,Z样本向量被平均。然后对平均向量执行算术运算,创建一个新向量是右侧的中心样品是通过进料产生的是作为生成器的输入。为了演示生成器的插值功能,将使用 +-0.25 比例采样的均匀噪声添加到是生产另外 8 个样品。在输入空间中应用算术会由于未对齐而导致噪声重叠。
这些演示表明可以使用我们的模型学习到的Z表示来开发有趣的应用程序。之前已经证明,条件生成模型可以学习令人信服地建模对象属性,如缩放、旋转和位置。据我们所知,这是第一次在纯无监督模型中证明这一点,进一步探索和发展上述矢量算法可以大大减少复杂图像分布的条件生成建模所需的数据量。
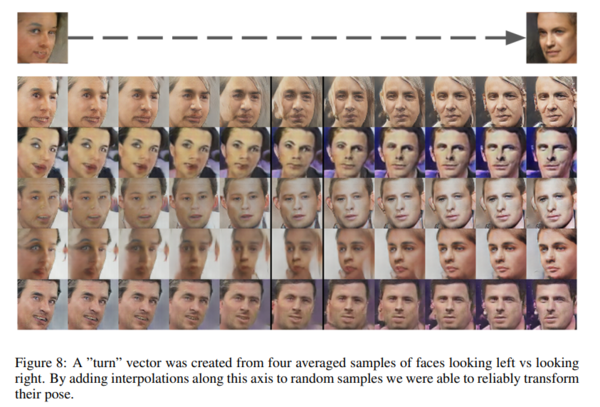
图 8: “转向”向量是由四个向左和向右看的人脸的平均样本创建的。通过沿该轴向随机样本添加插值,我们能够可靠地转换它们的姿势。
7 结论和未来工作
我们提出了一套更稳定的体系结构来训练生成式对抗网络,并给出证据证明对抗网络学习图像的良好表示,用于监督学习和生成式建模。仍然存在一些形式的模型不稳定性——我们注意到,随着模型训练时间的延长,它们有时会将滤波器子集折叠为单一振荡模式,需要进一步的工作来解决这个不稳定的问题。我们认为将这个框架扩展到其他领域,如视频(用于帧预测)和音频(用于语音合成的预先训练的功能)应该是非常有趣的,对所学潜空间性质的进一步研究也将是有趣的。
