摘要
量子计算最近获得了很多关注,科学家们已经看到了该领域的潜在应用,将量子计算用于密码学和通信,以及机器学习和医疗保健。蛋白质折叠一直是最有趣的研究领域之一,也是生物化学中最大的问题之一。每一种蛋白质都有独特的折叠方式,随着链中氨基酸数量的增加,找到其稳定形状的难度迅速增加。一个中等水平的蛋白质含有大约100种氨基酸,为了找到稳定的结构,需要验证的组合数量是巨大的。在某种程度上,这些组合的数量将是如此之大,以至于经典计算机甚至无法尝试解决它们。在本文中,我们使用 Qiskit Nature 研究了如何在量子计算的帮助下使用变分量子本征求解器 (VQE) 和量子近似优化算法 (QAOA) 两种不同的算法来解决这个问题。 我们比较了不同量子硬件和模拟器的结果,并检查错误缓解如何影响性能。 此外,我们与SoTA算法进行了比较,并评估了该方法的可靠性。
1.引言
蛋白质是一种叫做氨基酸的小分子链。氨基酸通过形成所谓的肽键相互结合。就氨基酸的数量而言,人类蛋白质的中位数长度为375。这些令人难以置信的长蛋白质链折叠并形成稳定的复杂 3D 结构。在给定氨基酸序列的情况下,找到特定蛋白质的这种稳定的3D 形状被称为蛋白质折叠问题。了解蛋白质如何折叠是至关重要的,因为蛋白质的功能与其形状相关。蛋白质的3D结构完全由氨基酸序列决定。因此,突变可以导致蛋白质氨基酸序列的改变,导致蛋白质折叠方式不同,使其无法执行所需的功能。错误折叠蛋白质的影响范围从轻微疾病到严重疾病。由蛋白质折叠不当引起的一些疾病有2型糖尿病、阿尔茨海默氏症、帕金森症、肌萎缩性侧索硬化症(ALS)。这种氨基酸序列被认为类似于一种与阿尔茨海默病致病酶相互作用的蛋白质。
药物开发包括模拟蛋白质的行为及其与药物分子的相互作用。能够可靠地模拟蛋白质的三维结构将大大加快药物发现过程,目前药物发现依赖于昂贵且耗时的实验方法。蛋白质折叠问题在计算上非常昂贵,而且在氨基酸数量上呈指数级增长。这种复杂性导致了机器学习等新技术的发展。其中最成功的是 AlphaFold,它在基准测试竞争中优于其他技术。
通过本文,我们提供了VQE与SoTA AlphaFold模型对比的全面分析。这是第一个针对不同硬件上的特定应用程序的基准测试结果。我们还确定了现有方法中的注意事项并对其进行了量化。
在本文中,我们研究了变分量子算法在蛋白质折叠问题中的应用。我们使用Qiskit开发的蛋白质折叠模块来模拟这个问题。变分算法非常适合噪声中等规模量子(NISQ)时代,其特点是能够运行低深度电路的噪声硬件。
全文组织结构如下。第二节概述了蛋白质折叠模型和我们使用的量子算法。在第三节中,我们将描述我们所使用的特定设置,例如优化器和ansatz。我们描述了各种类型的量子计算机的所有硬件和模拟器结果,并在第四节进行比较。第五节对结果进行了评论。最后,我们在第六节给出了额外的评论和总结。
2.文献综述
A.蛋白质折叠问题
蛋白质折叠问题旨在回答如何从氨基酸序列确定蛋白质的3D结构的问题。这可以被建模为在所有可能构象的空间中的搜索问题。蛋白质折叠问题的特征是一个无限大的搜索空间。这个问题的解决方案代表了蛋白质的功能结构与实验确定的结构相匹配。可能的构象数可以高达100300。庞大的搜索空间让它变得NP-Hard。众所周知,蛋白质折叠成热力学稳定的构象。因此,搜索问题的目标可以等效为寻找能量最小的蛋白质结构。
B.蛋白质折叠模型
肽被抽象为一个四面体晶格上的珠子序列。四面体晶格中的每一点都与另外4个点相连;因此,当添加以下氨基酸时,链可以向四个方向之一“转动”。随着序列中每个氨基酸的加入,链的转动方向被用来描述蛋白质的构象。氨基酸链通过为每个珠子分配4个量子比特来编码,每个量子比特代表四种可能的旋转之一。在不丧失一般性的情况下,前两个回合可以任意选择。剩余的链可以被编码成4(N-3)个量子比特。该表示形式被进一步压缩,以将使用的量子比特数量减少到2(N-3)。氨基酸之间的相互作用是根据MiyazawaJernigan评估的残基间接触能来计算的。相互作用量子位分别用于对相互作用能量进行编码。此外,还引入了三个惩罚项,惩罚手性,惩罚 back,惩罚 1,以防止链折叠回自身,施加手性约束,并惩罚最近邻居接触内的珠子之间的局部重叠。一个哈密顿量编码的相互作用能和惩罚,基态将被确定。
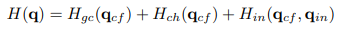
- 是几何约束项(控制没有分叉的氨基酸一级序列的增长)
- 是手性约束(为系统强化正确的立体化学)
- 是系统的相互作用能项。在我们的例子中,我们只考虑最近邻居的相互作用。
实现目标的两种最常见的变分算法是 VQE 和 QAOA。 这些算法的后续修改是使用 CVaR作为目标函数,而不是简单的期望值。
C. VQE
变分量子特征求解器 (VQE) 是一种混合经典-量子算法,用于计算哈密顿量基态的特征值。 VQE 基于变分原理。 VQE 涉及估计哈密顿量对参数拟态的期望值,然后通过使用经典优化器调整参数来最小化期望值。 可以根据系统的物理特性选择 ansatz 状态。 量子相位估计(QPE)算法也可以用于同样的目的,但其实现在NISQ时代是不可行的,因此本文不予考虑。
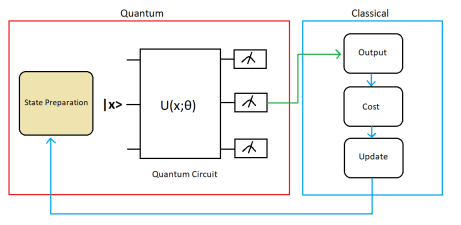
图1:VQE的运作
图 1 说明了 VQE 的工作流程,分为经典计算机和量子计算机。 我们使用经典计算机/优化器来调整和调整参数。 VQE 具有三个主要组成部分,Ansatz、Hamiltonian 和 Measurement。 Ansatz 是参数化的量子电路,它生成我们应用变分算法所需的量子态。 应该注意的是,ansatz 不是固定的; ansatz 的设计取决于问题和硬件; 范围和浅度越好,ansatz 就越好。 哈密顿量,表示为矩阵或泡利算子的总和。
D. QAOA
提出了求解组合优化问题的量子近似优化算法。优化问题可以转化为求解相应哈密顿量基态的等效问题。QAOA的变分形式为
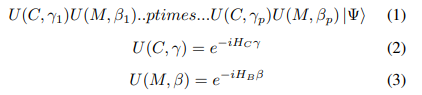
其中 和 分别是成本和混合哈密顿量。前者编码所要解决的优化问题,后者则是初始状态为 的特征态时所需要的。在没有混合哈密顿量的情况下,算法可能会陷入 的某个特征态。最优参数 是用经典的优化方案求出的,以最小化成本函数。
E. CVaR VQE和QAOA
在金融中经常使用的条件风险价值 (CVaR) 是与投资相关的风险度量。 更准确地说,它量化了与特定风险水平相关的预期损失。 结果表明,当与 VQE 和 QAOA 算法一起使用时,使用 CVaR 期望值作为损失函数会导致获得与基态重叠的状态的可能性更大。CVaR 期望值是通过对采样能量的最低 α % 的能量求平均来计算的。 假设能量 按升序排列,则 CVaR 期望值由下式给出:
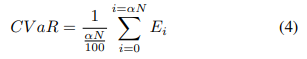
其中 为射击次数,即测量的能量数。
F.选择蛋白质的意义
选择“YPYFIP”的氨基酸序列是与BACE1阿尔茨海默病酶外位点结合的肽链的子序列。BACE1已被证明会产生β -淀粉样蛋白,而β -淀粉样蛋白是导致阿尔茨海默氏症记忆丧失等症状的原因。我们去除了乙炔和 链,只考虑了主要的肽。
G. Alphafold
Alphafold是Deepmind开发的一种最先进的深度学习模型,可以根据氨基酸序列预测蛋白质的3D结构。该模型使用了蛋白质结构的生物学、进化和几何约束。这种方法与Qiskit nature所使用的方法有很大的不同,Qiskit nature是本研究的主题,其方法是最小化相互作用能量。AlphaFold在CASP14中完全超越了其他技术,CASP14是一项年度比赛,被认为是蛋白质折叠的金标准。
3.方法与设置
A. 硬件
我们在IBM和牛津量子计算(OQC)提供的量子设备上进行实验。此外,我们尝试使用Rigetti和IONQ硬件,但遇到了兼容性问题,因此不得不放弃它们。IBM、Rigetti和OQC设备基于超导量子比特,而IONQ设备基于俘获离子技术。IONQ QPU的另一个显著特征是它具有完全连接的拓扑结构,因此任何两量子比特门都可以直接应用于任何量子比特对。
我们也可以选择在模拟器上运行实验,以比较和对比在真实硬件上获得的结果。我们使用AWS braket提供的SV1模拟器,以及Qiskit提供的IBM FakeBrooklyn。 SV1 是一个状态向量模拟器,而 FakeBrooklyn 是一个带有噪声的模拟硬件。
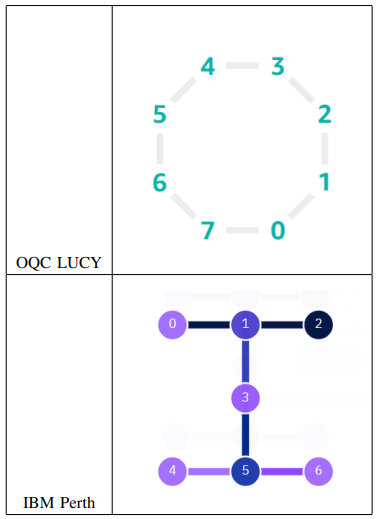
图2:OQC和IBM Perth的硬件架构
B. Ansatz
对于 VQE,我们使用 Qiskit 提供的具有单次重复的真实振幅 Ansatz。 Real Amplitudes ansatz 具有交替的 RY 门和 CX 门层。 使用默认的完整纠缠图,将 CX 门应用于所有量子位对。
对于QAOA和CVaR QAOA, ansatz如第二节所述。我们尝试不同的重复次数。理论上,随着重复次数的增加,解应该收敛到精确解。然而,当p=2次重复时,结果最好。对于除OQC Lucy(见第五节)外的所有情况,都选择了p=2。
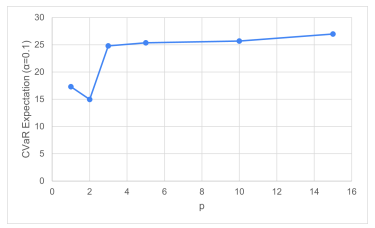
图 3:QAOA 性能与 Ansatz 重复。 p 表示 QAOA 电路的深度。
C.优化程序
我们使用 COBYLA 优化器进行 50 次迭代。 COBYLA 是经典的无梯度优化器,每次迭代仅调用一次成本函数。 从成本的角度来看,这很重要。 可能已经选择了其他优化器,例如梯度下降或 SPSA; 然而,为了在不同实验之间保持一致性,并且其他优化器的行为相对不稳定,选择了 COBYLA。
D.错误缓解
NISQ设备通常有噪声,有几种方法可以缓解/纠正这些影响。目前有两种方法,第一种是纠错,它涉及到在计算过程中消除错误的方法。另一方面,误差缓解方法试图对测量后的误差进行补偿。我们使用了qiskit提供的差错缓解技术,在IBM Perth和FakeBrooklyn后端进行了模拟实验。通过拟合测量状态和理想状态数据,计算出标定矩阵。然后使用校准矩阵来校正优化中使用的状态。
4.结果
A.硬件和模拟器上的基态能量
表1到表5总结了在四种算法类型的不同量子硬件和模拟器上实现的基态能量(以Hartrees为单位)。通常CVaR期望的定义是小于期望值。对于除IBM FakeBrooklyn外的所有情况,都设置α=0.01,其中选择α=0.1来补偿较少的镜头。IBM FakeBrooklyn减少的拍摄次数源于内存和运行时限制。
对于没有侧链的模拟,CVaR VQE和CVaR QAOA似乎在硬件和模拟器中收敛到相同的值,如表1、2、3所示。在这种情况下,减少错误没有效果。QAOA和VQE存在显著差异。VQE总体上比QAOA表现得更好,当应用错误缓解时,VQE表现得更好。
对于侧链的模拟,VQE和CVaR VQE似乎优于QAOA,这在表6和表5中很明显。
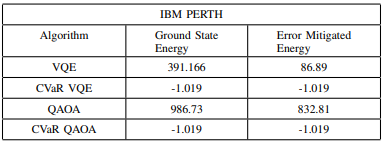
表一:表1显示了在IBM Perth Hardware上运行的实验结果。主链为YPYFIP,本实验没有使用侧链。它用了6个量子比特,射击的次数是8192次。
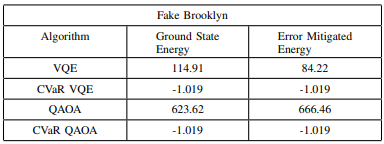
表二:表2显示了在Fake Brooklyn Simulator上运行的实验结果。主链为YPYFIP,不使用侧链。它用了6个量子比特,使用的射击次数是128次。
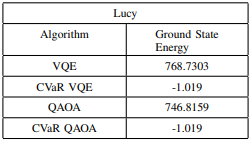
表三:表3显示了在Lucy上进行的实验结果。在进行这个实验时,没有使用任何减少误差的技术。主链为YPYFIP,不使用侧链。它用了6个量子比特,射击的次数是8192次。
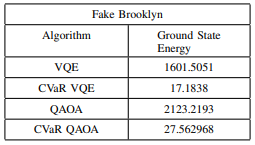
表四:表4显示了在Fake Brooklyn Simulator上运行的实验结果。在进行这个实验时,没有使用任何减少误差的技术。主链为YPYFIP,侧链为IPFY。它用了17个量子比特,使用的次数是128次。
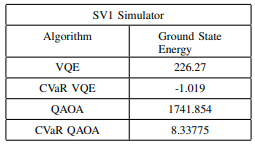
表五:表5显示了在SV1模拟器上运行的实验结果。在进行这个实验时,没有使用任何减少误差的技术。主链为YPYFIP,侧链为IPFY。它需要17个量子比特,使用的射击次数为8192次。
B.算法预测的分布
我们研究了四种算法中每一种的可重复性。 因此,为了量化结果的变化,我们在没有任何侧链的蛋白质链的无噪音模拟器上进行了实验。我们在多个试验中描述了预测基态能量的分布(或CVaR变体情况下的CVaR期望)和预测的蛋白质结构,以量化算法的有效性。预测结构显示出相当大的可变性,如图5、6、7、8所示。因此,这些结果不仅有助于量化该方法在预测三维结构的最终目标中的有效性,而且还提供了一种更可靠的比较预测结构的方法,这将在下一节中讨论。VQE和CVaR QAOA在返回相同结构方面在统计上是最一致的。然而,他们两人都在大量试验中预测了物理上不可能的结构。
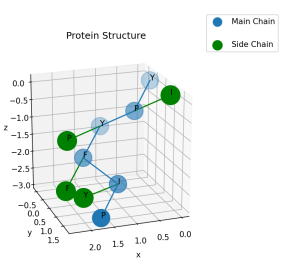
图 4:带有侧链的样品蛋白质结构
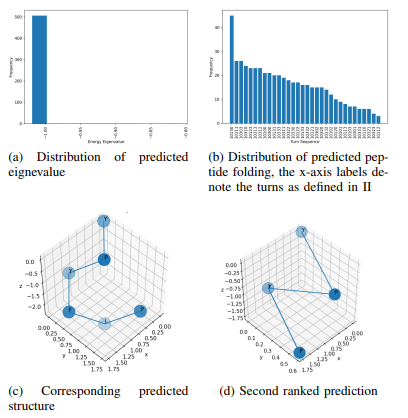
图5:CVaR QAOA:直方图 (a) 总结了在 QASM 模拟器上针对 CVaR QAOA (α=0.01) 获得的预测结果。 预测次数512次; 特征值在 98.8% 的时间内收敛到相同的值。 然而,最频繁的预测只有 8.8% 的频率。 此外,图 (d) 表明链会折叠回自身导致重叠,这是被禁止的。
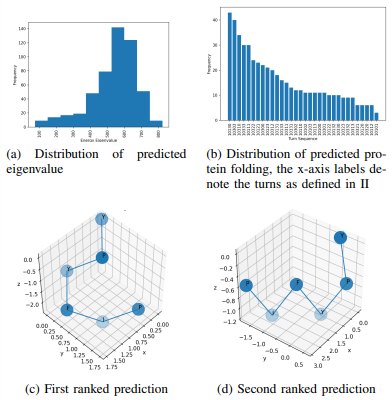
图6:QAOA:直方图(a)总结了在QAOA的QASM模拟器上获得的预测结果。预测512次,算法收敛到最低能态的时间不到2%。最常见的预测只有8.4%的概率。最常见的两个预测没有重叠的迹象。
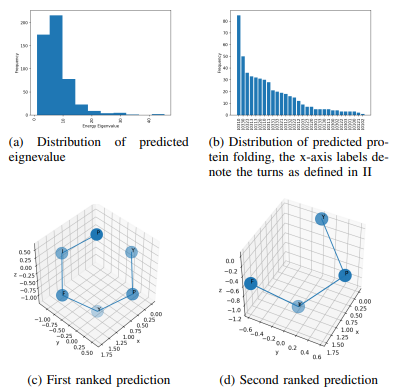
图7:VQE:直方图(a)总结了在VQE的QASM模拟器上获得的预测结果。预测512次,算法在30%的时间内收敛到最低能态。最常见的预测频率为16%。尽管有希望的数字,图(d)表明链折叠到自己导致重叠,这是被禁止的。
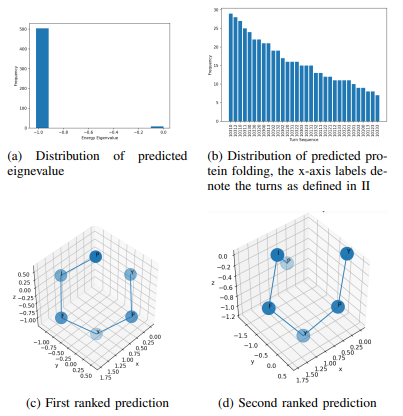
图8:CVaR VQE:直方图(a)总结了在VQE的QASM模拟器上获得的预测结果。预测512次,算法在99%的时间内收敛到最低能态。最常见的预测频率只有5%。此外,图 (d) 中的数字表明链条折回自身导致重叠,这是被禁止的。
C. RMSD计算
均方根偏差(RMSD)是最常用的基于距离的测量工具,用于比较两个原子坐标之间蛋白质结构的相似性。RMSD值由公式计算
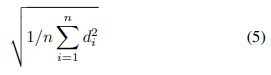
值得注意的是,任何小于2 A˚的RMSD值都是一个好值,然而,值越小,精度越高。我们通过计算RMSD来比较QAOA类算法和VQE类算法的顶级预测。QAOA类和VQE类的RMSD值为0.6357A˚(图9)。
此外,我们将AlphaFold的预测与我们使用相同方法的最高预测进行比较。为了使两个预测具有可比性,alpha折叠预测 (图11)通过将肽视为每个氨基酸的几何中心链,简化为一个珠状模型。对比如图9 (d)所示,得到RMSD值为4.795A。
这两幅图像的比例有明显的不同。我们推测这是因为Qiskit Nature中内置的晶格参数。
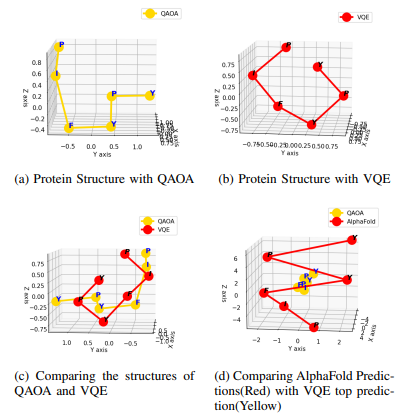
图9:比较QAOA和VQE预测的最可能结构
D.处罚条款的效力
研究了第二节中所述的三种刑罚条款的影响。这三个项中的每一个都在对数尺度上变化,保持其他项不变,并注意到最频繁结构的概率(图10)。
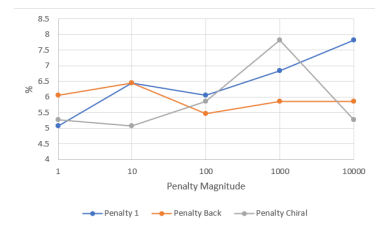
图10:根据第二节中定义的惩罚项大小绘制最频繁结构的%概率
5.讨论
执行VQE算法的成本由两个因素决定;量子任务的数量和射击的数量。前者是两者中成本较高的。这两者对应于创建的电路数量和在每个电路上执行的射击数量。如果哈密顿项可交换,就有可能同时测量它们,从而减少对量子计算机的调用次数,并减少主要成本部分。然而,如果项不交换,则必须分别测量每个哈密顿项,其规模为 。在我们的例子中,所有的哈密顿项都由泡利Z矩阵组成。因此,我们的成本只与射击次数成比例。
决定硬件模拟能力的另一个重要因素是脉冲持续时间。OQC Lucy允许最大脉冲持续时间为120µs,因此在QAOA的8192次拍摄时将电路深度限制为1。
迭代次数也是需要考虑的重要因素。梯度下降或SPSA等优化器每次迭代可能会对量子计算机进行不止一次调用,进一步增加了几倍的成本(基于梯度的优化器通常是三倍,因为它们需要通过参数移位计算梯度)。
为了降低计算成本,通过省略恒等操作,蛋白质量子比特算子被减少到所需的最小数量的量子比特。对于论文中使用的带有主链的蛋白质,问题被映射到120个量子比特,但它已优化为17个量子比特。类似地,在没有链的情况下,它已优化为6个量子比特。
使用变分算法得到的结构与类似的技术有很大的不同。为了说明,我们包括由alpha fold和alpha fold 2预测的结构。
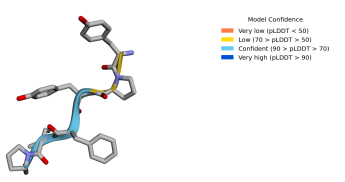
图11:AlphaFold预测的结构
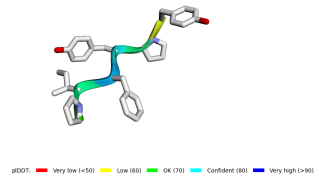
图12:AlphaFold 2预测的结构
模型的可靠性很低,一个可能的原因可能是不同结构之间的能量差异不大。此外,由于只考虑了有限数量的相互作用,这导致了不准确。当前模型的一个紧迫问题是,链在多种情况下会折叠到自己身上。
6.结论
在本文中,我们分析了Qiskit作为Qiskit Nature库的一部分提供的蛋白质折叠模型的性能,并将结果与Alphafold模型进行了比较,发现存在明显的偏差,需要改进Qiskit Nature模型。该算法是独一无二的,特别是在基于门的量子计算范式中。
我们比较了各种硬件和模拟器上的VQE和QAOA,有和没有误差缓解。我们得出结论,VQE类算法在有侧链和没有侧链的模拟中表现得比QAOA更好。我们还比较了算法预测的结构,并继续检查模型的可重复性,我们发现一些非物理预测是经常做出的。此外,我们还考察了惩罚参数对模型统计稳定性的影响,并发现其趋势较弱。
我们的结论是,在各种指标上都有很大的改进空间,然而,我们也承认目前硬件上的限制使其难以实现。在这个方向上的持续工作是一个积极的迹象。除此之外,还必须开发一种更强大的编码方法,以防止链折叠回自身。
7.未来的研究
这一领域的未来发展将密切关注硬件能力的可用性。未来工作的主要目标是用一种允许更多自由度和禁止非物理状态的方式对问题进行建模。此外,必须提高模型的可靠性,以便商业和实际应用。
我们确定的一种方法是使用其他新兴技术,如密度矩阵嵌入理论,以更好地表征蛋白质的能量。
原文链接:https://arxiv.org/pdf/2211.07854.pdf
---煤油灯科技victorlamp.com翻译整理---
