在 80 年代,Geoffrey Hinton 是发明反向传播的科学家之一,反向传播是一种能够训练深度神经网络的算法。反向传播是深度学习成功及其如今广泛使用的关键。
但是 Hinton 是我们这个时代最著名的人工智能科学家之一,他认为现在是我们超越反向传播思考并寻找其他更有效的方法来训练神经网络的时候了,和许多其他科学家一样,他从人脑中汲取灵感。
在 NeurIPS 2022 上发表的一篇新论文中,Hinton 介绍了“ forward-forward algorithm ”,这是一种新的人工神经网络学习算法,其灵感来自于我们对大脑神经激活的了解。Hinton 认为,虽然仍处于早期实验阶段,但 forward-forward 有可能在未来取代 backprop。该论文还提出了一种新的“凡人计算”模型,使我们更接近大脑的节能机制,并可以支持forward-forward算法。
反向传播的问题
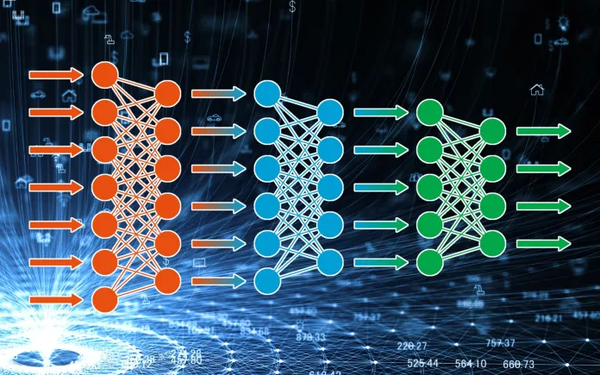
深度神经网络在训练时会经历两个阶段:
首先是前向传递,其中输入特征通过模型的层,并通过权重、激活函数和其他转换进行修改以创建预测。然后将预测与地面实况进行比较并计算误差。
在第二个阶段,即反向传播,错误通过层以相反的顺序传播,并修正人工神经元的权重。反向传播使用偏导数和链式法则来计算梯度,并根据每个人工神经元对误差的贡献来调整每个人工神经元。
虽然反向传播非常有用,但它与我们对大脑的了解有很大不同。
“作为皮层如何学习的模型,反向传播仍然令人难以置信,尽管人们付出了相当大的努力来发明可以由真实神经元实现的方法,”Hinton 写道。“没有令人信服的证据表明皮质明确传播错误导数或存储神经活动以用于随后的反向传播。”
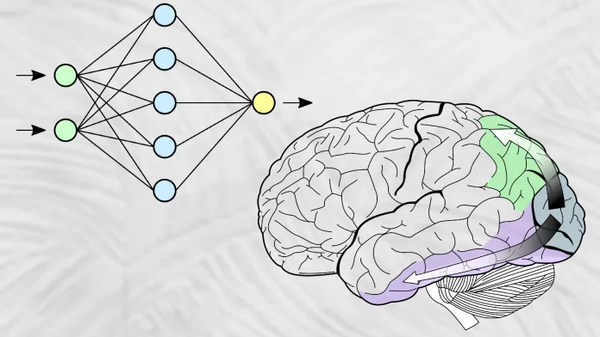
例如,在视觉系统中,不同皮层区域之间的联系并不反映基于反向传播的深度学习模型的自下而上的联系。相反,它们进入循环,其中神经信号穿过几个皮层层,然后返回到较早的区域。
反向传播的主要限制之一是学习和推理的分离。要调整神经网络的权重,训练算法必须停止推理以执行反向传播。在现实世界中,大脑接收到源源不断的信息流,“感知系统需要实时进行推理和学习,而不会停下来进行反向传播,”Hinton写道。
如果在前向传递中完成的计算不可微分,则反向传播也不起作用。Hinton 写道:“如果我们在前向传播中插入一个黑匣子,除非我们学习黑匣子的可微分模型,否则将不再可能执行反向传播。”
在无法进行反向传播的情况下,强化学习可以作为训练神经网络的替代算法。但是,当神经网络包含数百万或数十亿个参数时,强化学习的计算量大、速度慢且不稳定。
The forward-forward算法(FF)
forward-forward算法背后的思想是用两次前向传播代替反向传播的前向和反向传播,这两个过程很相似,但它们处理不同的数据并且具有相反的目标。
“positive pass”对真实数据进行操作,调整网络的权重以增加每一层的“goodness”,“negative pass”对负数据进行操作并调整权重以减少goodness。
在论文中,Hinton 将善衡量为神经活动的平方和与活动平方的负和,学习旨在调整神经网络的权重,使其高于真实示例的特定阈值,低于负数据的阈值。
在训练期间,示例及其标签被合并到一个向量中以创建正数据。要创建负面数据,使用相同的过程,只是在示例上附加了错误标签。在数据通过神经网络运行后,调整权重以增加正例的优度(例如,激活的平方和)并降低负例的优度。不需要反向传播。
此过程适用于具有单个隐藏层的神经网络。对于多层深度学习模型,每个隐藏层的输出在被传递到下一个之前被归一化。
FF 算法还可以受益于某种形式的自我监督学习,这种学习可以使神经网络更加稳健,同时减少对手动标记示例的需求。在论文中,Hinton 展示了简单的掩蔽技术如何创建负样本来训练模型。
与反向传播不同,FF 算法在包含黑盒模块时也有效。由于该算法不需要可微函数,因此它仍然可以在不知道模型中每一层的内部工作原理的情况下调整其可训练参数。
“前向-前向算法 (FF) 在速度上可与反向传播相媲美,但它的优势在于可以在前向计算的精确细节未知时使用它,”Hinton 写道。
测试FF算法
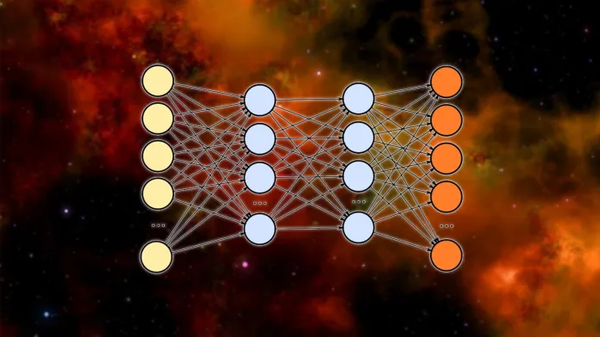
Hinton 在由四个全连接层组成的神经网络上测试了 FF 算法,每个层包含 2,000 个神经元和 ReLU 激活。该网络在 MNIST 数据集上训练了 60 个时期,以达到 1.36% 的错误率。相比之下,反向传播需要 20 个 epoch 才能达到类似的结果。通过将学习率加倍,Hinton 能够在 40 个 epoch 中达到 1.40% 的错误率。
Hinton 指出,FF算法“在本文研究的几个玩具问题上的泛化效果不佳,因此它不太可能在功率不是问题的应用中取代反向传播。”
根据 Hinton 的说法,FF算法可能优于反向传播的两个领域是“皮质学习模型”和“作为一种利用极低功耗模拟硬件而不求助于强化学习的方法”。
“很高兴看到 Hinton 仍在尝试从生物神经网络中汲取灵感,以找到一种使 AI 更高效的方法,”神经科学家、《智能的诞生》一书的作者 Daeyeol Lee 说。“我认为像 FF 这样的新想法可以刺激对神经元和突触执行的基本计算的研究。”
与此同时,南加州大学计算机科学副教授 Saty Raghavachary 指出,虽然 FF 似乎是反向传播的替代方案,但还需要进一步研究。
“与 BP 相比,FF 在生物学上更合理。但从更大的角度来看,它只是一种学习捕获数据中现有模式的替代方法,它本身不会导致类似人类的智能——因为它专门处理(学习模式)人类生成的、人类的——标记数据,”Raghavachary 说。
普通计算
在论文中,Hinton 挑战了既定的计算范式,并提出了一个新的方向。
“通用数字计算机被设计为忠实地遵循指令,因为人们认为让通用计算机执行特定任务的唯一方法是编写一个程序,以极其详细的方式准确指定要做什么,”Hinton写道。“这不再是事实,但研究界在理解深度学习对计算机构建方式的长期影响方面进展缓慢。”
Hinton 特别挑战了分离软件和硬件的想法。虽然这种分离有很多好处,包括将相同的软件复制到数百万台计算机,但它也有局限性。
Hinton 写道:“如果……我们愿意放弃永生,那么执行计算所需的能量和制造执行计算的硬件的成本应该可以大大节省。我们可以允许旨在执行相同任务的不同硬件实例的连接性和非线性发生较大且未知的变化,并依靠学习过程来发现有效利用每个特定实例的未知属性的参数值的硬件。”
基本上,这意味着软件是逐渐构建在每个硬件实例上的,并且只对那个实例有用。因此,软件变得“凡人”,这意味着它与硬件一起消亡。Hinton 提出了关于普通计算机如何通过训练将其知识转移到另一个硬件实例的命题。根据 Hinton 的说法,尽管存在缺点,但凡人计算可以具有明显的优势。
Hinton 写道:“如果你想让你的万亿参数神经网络只消耗几瓦特,那么普通计算可能是唯一的选择,”尽管他还断言其可行性将取决于找到一种可以在精确的硬件中高效运行的学习程序。细节未知。
Hinton 写道,forward-forward 算法是一个很有前途的候选者,尽管它对大型神经网络的扩展能力还有待观察。
“我认为数字计算机和大脑之间的(错误)类比适得其反地促进了突触可能类似于晶体管(二进制开关)的想法,而实际上,突触要复杂得多,”LEE说。“一旦人们了解 FF 模型的功能,这可能会引发一些关于皮质计算构建块的新想法,包括大脑中的反馈(自上而下)连接。鉴于大脑充满了循环和并行连接,FF 似乎非常有可能在大脑中实现。”
然而,Raghavachary 认为,类生物智能需要一种架构,该架构可以通过直接、物理、交互和持续 (DPIC) 与世界互动来了解世界,以便以非符号方式体验它。
“在足够复杂的架构中,可能会发生符号处理(例如,语言习得),这将通过潜在的和互补的非符号体验来‘扎根’,”Raghavachary 说。“FF 似乎是进行符号处理的另一种方式,这很有用,但在我看来,成熟的 AGI 架构需要直接体验、非符号、对应物,只有具体化才能提供。”
生物学习
神经生物学教授、《The Self-Assembling Brain》一书的作者Peter Robin Hiesinger指出,关键问题是信息。他说,在生物学中,在学习之前生物神经网络中包含大量信息。
“它在连通性中。它存在于每个单独的突触连接的分子组成中,这不仅仅是一个“突触权重”。这一切都是通过学习之前的基因编码发育实现的——无论如何在生物学中,”Hiesinger 说。
根据 Hiesinger 的说法,基因编码的开发解决了 Hinton 提出的两个问题。首先,它决定了如何让“万亿参数”进入网络。其次,作为发展基础的基因组进化编程是在精确细节未知的硬件中有效“运行”的“学习程序”。
“事实上, '可以在精确细节未知的硬件中高效运行的程序'的措辞 恰好回溯到 Hinton 提出的问题:程序(软件)与硬件的分离,”Hiesinger 说。“在生物学中,硬件的精确细节是一个漫长的信息编码过程的结果,经过进化编程并通过生长过程展开。”
生物学习的效率在于这种渐进的信息编码过程:硬件的开发永无止境,学习程序的运行永无止境。相反,网络中的信息编码,包括亚细胞和分子,首先在没有神经元活动的情况下连续发生,然后在神经元活动中发生。
“在处理环境信息之前,神经元和突触水平的学习已经作为一个纯粹的基因编码过程发生,”Hiesinger 说。“没有‘开启’开关,只有逐渐增加信息编码,导致网络 ‘其精确细节未知’, 仅从学习的角度来看,忽略了在将数据输入网络之前编码的信息。”
生物硬件给定状态的精确细节很难知道,因为描述它需要太多信息,并且没有就什么是相关的达成一致。
“在当前的 AI 中,除了突触权重之外什么都不重要。但是,如果没有及时的特性、动力学和功能,则无法模拟突触功能的许多方面,无数的单个分子使突触以一种通过梯度下降对突触权重进行上调或下调的方式做出反应,”Hiesinger 说,“Hinton 正在寻找丢失的信息。”
原文链接:https://bdtechtalks.com/2022/12/19/forward-forward-algorithm-geoffrey-hinton/
---煤油灯科技victorlamp.com翻译整理---
