摘要
人工智能(AI)技术给社会的许多领域带来了革命性的变化,使用这些系统的人可能会期望它们以一种潜在的超理性方式工作。然而,在这项研究中,我们展示了一些人工智能系统,即大型语言模型(LLMs),表现出与人类直觉惊人相似的行为,以及随之而来的许多认知错误。我们使用最先进的LLM,即OpenAI的生成预训练转换器(GPT-3.5)的最新迭代,并使用认知反射测试(CRT)和语义错觉来探测它,这些测试最初是为了研究人类的直觉决策而设计的。我们的结果显示,GPT-3.5系统地展示了“机器直觉”,这意味着它产生的错误反应与人类对CRT以及语义幻觉的反应惊人地相同,我们研究了几种方法来测试GPT-3.5的直觉决策倾向有多强。我们的研究表明,用认知科学的方法调查LLMs有可能揭示涌现的特征,并调整对它们的机器行为的期望。
介绍
由于大型语言模型(LLMs)在我们的日常生活中变得越来越重要,因此研究它们如何推理,算法决策的可靠性,它们提供的信息是否正确,以及人类在与它们交互时应该如何小心是至关重要的。关于人类如何感知人工智能(AI)技术的研究表明,在技术任务中,人们对人工智能的信任度很高。一方面,考虑到人工智能系统是可靠的决策者、模式识别器、游戏玩家或对话代理,这并不令人惊讶。另一方面,我们的研究表明,这种人工智能系统的概念是非常有问题的:LLMs表现出与人类的直觉决策非常相似的行为,导致了Tversky和Kahneman等研究人员所描述的认知错误。因此,我们认为,人类在与LLMs等人工代理互动时,应该显著重塑他们的期望。
我们借用了在心理学研究中广泛使用的认知反射测试(CRT)。CRT包括三种类型的任务,以简单的数学或逻辑问题的形式测试人类的认知能力。表1所示的所有任务都可能触发一个直观但错误的答案,而找到正确的解决方案则需要深思熟虑。Type 1 CRT任务触发一个简单的减法运算,而不是使用会引发错误的短语“more than”进行实际计算。Type 2 CRT任务利用了完成数值三重序列的趋势。在Type 3 CRT任务中,像“一半”或“三分之一”这样的短语诱使人们执行简单的除法,而不是正确地考虑指数增长。数学能力是CRT的一个混淆变量。因此,为了在没有这个变量的情况下测试直觉思维,我们进一步应用了受著名的摩西错觉启发的语义错觉测试(见表1)。语义错觉,即包含人们往往忽视的不一致的问题,同样被设计用来衡量直觉反应的倾向。
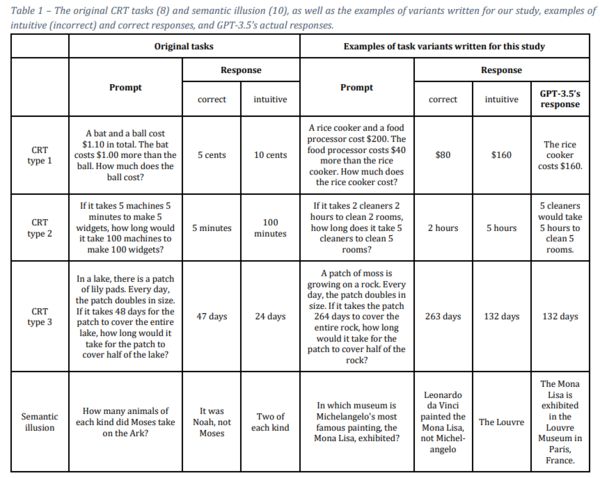
表1:原始CRT任务和语义错觉,以及为我们的研究编写的变体示例,直观(不正确)和正确回答的示例,以及GPT-3.5的实际回答。
当这里使用“直觉”这个术语时,我们指的是直觉的双过程概念。直觉反映了系统1的过程,这意味着认知的轻松和自发的判断,预先假设了错误的可能性。我们称之为“机器直觉”的现象,是指机器采用的行为模式,反映了类似人类的直觉决策。
我们将CRT和语义幻象任务应用于最流行和最先进的LLM类型之一,即OpenAI的生成预训练转换器(GPT-3.5)。特别是,我们使用OpenAI在2022年11月发布的最大、功能最强的版本“text-davinci-003”。为了确定结果不受GPT-3.5在训练期间暴露于原始任务的影响,我们让假设盲研究助理按照特定的指示提供每种类型的CRT任务以及语义幻觉的平衡变体。我们手动验证了数据集中的所有项目,替换了无意义或不可信的项目,并更正了数字错误或错别字。最终,我们的数据集包含150个CRT任务,包括三种类型的任务,以及50个语义幻想。此外,在解释反应时,我们会区分三种情况:直觉(但不正确的反应)、正确(但非直觉的反应)和非典型(既不是直觉也不是正确的)。有关GPT-3.5的更多信息,包括我们应用的具体设置和分析,请参阅附录。
结果
GPT-3.5显示出强烈的依赖机器直觉的倾向,而不是以一种代表深思熟虑的推理的方式做出反应。在150个CRT任务中,86.7%的GPT-3.5给出了直观但错误的答案,而它分别只在5.3%和8%的任务中给出了正确或非典型的答案(见图1)。这超过了人类的结果,平均58.7%的人直觉地做出反应,41.3%的人正确地做出反应(见图1)。除了在人类和GPT-3.5中直觉判断表现之间的定量比较之外,值得注意的是,GPT-3.5 -而不是正确地做出反应或只是通过给出非典型反应而临时做出反应,也反映了在定性意义上发生在人类身上的直觉行为。
各种研究工作表明GPT-3.5在基本数学问题上是成功的,排除了模型算术推理能力不足导致上述结果的潜在反对意见。对语义错觉的反应也是如此,它依赖于纯语言问题而不是数学问题:GPT-3.5直觉地回答了72%的语义错觉,而在最初的摩西错觉中,人类的直觉回答为81%(见图1)。为了确保这一结果不是由于缺乏知识造成的,我们检查了GPT-3.5确实拥有在每个任务中发现错误所必需的世界知识,它在所有任务中都是100%成功的。这些结果清楚地支持了GPT-3.5不是一个深思熟虑的推理器,而是展示了机器直觉的假设。
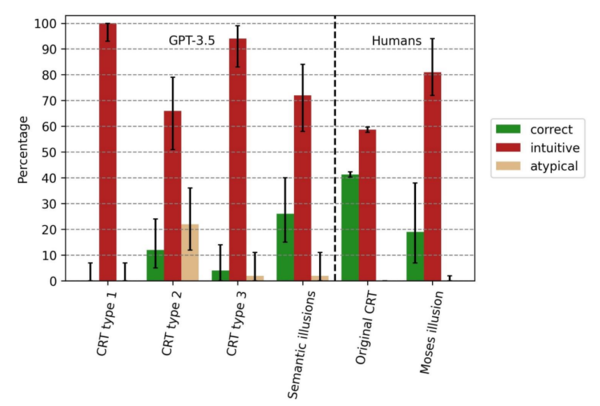
图1 :对CRT和语义幻象任务的正确、直觉和非典型回答的百分比,误差条表示95%置信区间。
我们进一步研究了GPT-3.5通过修改任务的方式来直观地做出反应的倾向,这些方式之前已被证明可以在人类和LLMs中引发审慎推理,结果如图2所示。
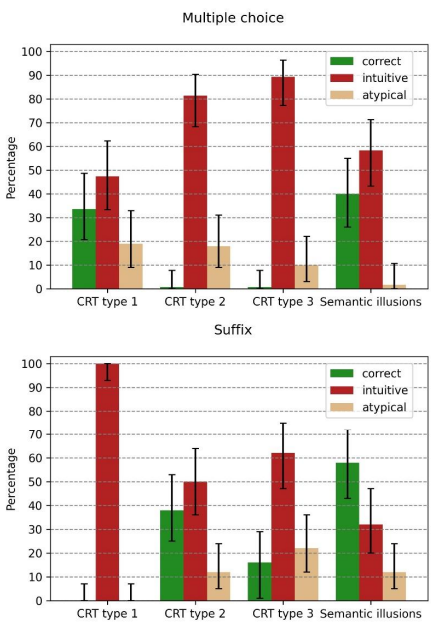
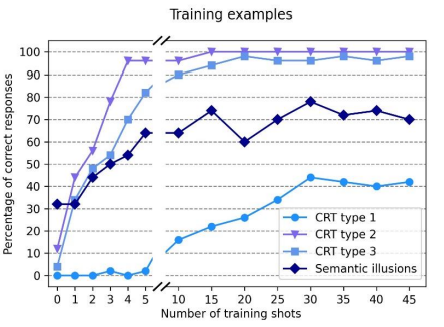
图2 - GPT-3.5对CRT和语义幻象任务的正确、直观和非典型回答的百分比:以多项选择的形式呈现(面板A),在此之前有指示引导它进行深思熟虑的推理(面板B),并给出包含正确而非直观回答的训练镜头(面板C)。错误条表示95%的置信区间。
首先,我们将所有任务以多项选择的形式呈现。A组的结果显示,这增加了GPT-3.5选择正确答案的倾向(CRT: 11.7%;语义错觉:40%),而不是直觉答案(CRT: 72.7%;语义幻想:58.3%)。这意味着,在选项中呈现CRT任务的正确答案,或在语义错觉多项选择格式中添加选项“问题包含不正确的假设”,略微覆盖了CRT类型1任务的直觉回答(33.7%正确)和语义错觉(40%正确)。
其次,我们添加了指示GPT-3.5进行审慎推理的后缀:对于CRT任务,我们使用“让我们一步一步地思考”。这比选择题形式(18%正确)稍微降低了机器直觉,直觉反应仍然是最突出的(70.7%正确)。在语义错觉中添加后缀“仔细思考并检查问题中潜在的不正确假设”将正确反应的可能性提高到58%,将直觉反应降低到32%。Type2 CRT任务和语义幻象通过使用上述后缀获益最大。
第三,我们在所有任务前加上训练示例。C组中显示的结果表明,GPT-3.5正确回答(而不是直观回答)的倾向随着每一个包含正确而不是直观回答的额外训练镜头的增加而增加。CRT任务在一个类别中在语义上非常相似,并且在给出示例后解决任务时可能允许利用简单的启发式。但GPT-3.5在语义幻象任务上的改进尤其令人印象深刻,因为它们的性质非常不同,它无法学习如何解决它们的具体规则。
讨论
CRT不只是衡量数学能力,语义错觉也不只是衡量详尽的语言理解能力。在人类中,这两种测试都是用来衡量覆盖和监控潜在错误直觉的能力,换句话说,就是第一系统思维。此外,这两种测试都是个体进行无偏见、反思和理性决策能力的预测指标。然而,在实践中,大量使用这两种测试的研究证明,人类很可能是认知的吝啬鬼。在我们的实验中,我们表明同样的结论适用于LLM,即GPT-3.5。起初,这一发现可能与人们的预期相反。GPT-3.5能够解决正确响应CRT任务所需的基本数学问题,它也有足够的知识来发现语义幻象中的不真实假设。尽管如此,该模型具有强烈的机器直觉倾向,通过发展词汇的概率分布来反映人类的认知轻松现象,尽管实际的认知轻松或直觉显然从未作为一种机制出现在其潜在空间中。但是,如何解释这些结果呢?
LLM结合了符号序列可能性的知识,这是由于它们的人为训练刺激。因此,它们代表了从模型架构中出现的人类行为模式,并影响模型如何处理推理问题。这种动态的一个影响是LLM很可能是不正确的推理者,因为它们在语言上再现了人类认知推理偏见的现象。但这种考虑只能部分解释结果,特别是因为机器直觉似乎是一种系统效应,当用我们数据集中新的、以前未见过的任务来提示模型时,这种系统效应正在出现。
GPT-3.5,再次类似于人类,似乎在响应CRT任务时利用了语法启发式。对于第一类CRT任务,人们倾向于用一个更简单的问题来代替实际的问题。这是由任务中引发错误的“more than”短语触发的。对于GPT3.5,情况可能也是如此,而该模型为对应于简单减法结果的标记生成概率分布,而不是表示问题的正确代数结构的计算。类似的解释可以用于Type 2 CRT任务。人类使用一种简单的启发式方法来完成数字三重序列。我们可以假设GPT-3.5同样检测到这种模式,并输出相应的类似直觉的响应。在Type 3 CRT任务中,像“一半”或“三分之一”这样的短语在疑问句从句中会触发人类(可能也是GPT-3.5)简单地将给定的数字除以2或3,而不是正确地考虑指数增长。
在语义幻象中,句法启发式无法解释GPT-3.5中机器直觉的表现。该模型屈服于许多既定幻想的原因可能更为复杂。如果提示包含特定的术语,模型的激活意味着与这些术语相关的单词的概率增加。无缝但不正确和模糊地回答语义错觉的回答比质疑语义错觉的回答具有更丰富的语义关系。通过对问题本身提出问题来回答问题,就像人们在检测语义错觉时所做的那样,在口头和书面交流中都不常见。因此,可以假设GPT-3.5是在出现这种模式的相对较少的文本示例上进行训练的。因此,在向模型提示7种语义幻象时,大多数情况下似乎倾向于流利地继续对话,而不是通过反问来回答问题。但值得注意的是,GPT-3.5的模型“textdavinci-002”在正确回答语义错觉方面明显不如最新版本“text-davinci-003”(正确回答26%)(只有不到10%的正确回答)。总的来说,最新的模型大大减少了不真实的反应,这在屈从于语义错觉时是必要的。这是通过从人类反馈中使用强化学习实现的。
即使以多项选择的形式呈现任务,或者提供GPT-3.5易于引起反思反应的后缀,机器直觉的程度也只是降低了。提供不同任务的训练示例是使GPT-3.5不太倾向于表现出机器直觉的最成功的方法。此外,Type 1 CRT任务显著受益于多项选择重构。Type 2 CRT任务和语义幻想受益于提供后缀。总之,机器直觉的倾向是非常强大的。这种持久性可能是因为GPT-3.5完全依赖于语言,这使得它比人类更容易被语言欺骗,人类可以通过调用常识、逻辑或通过与环境互动获得的经验来响应任务。
结论
在过去的几年中,语言模型(包括GPT模型)变得越来越强大,具有越来越多的新兴功能。机器学习模型,尤其是y transformers能力的增加,也导致了技术不透明度的增加。这篇论文表明,在这种情况下,从认知科学中借鉴方法是有希望的,这些方法旨在研究另一种有能力和不透明的结构,即人类思维。因此,人们可以通过实证研究机器行为,而不是通过仔细检查其模型结构和超参数来推导人工神经网络的特性。因此,关于人工神经网络如何根据不同的输入表现出行为的机制的知识可以提供可解释性。
使用这种方法可以让我们在最先进的语言模型中发现迄今为止未知的机器直觉现象。CRT任务和语义幻觉被故意设计成主要诱导直觉和错误的反应。然而,机器直觉也会出现在这种“敌对”测试环境之外的环境中。总的来说,我们的研究结果表明LLM可能会产生难以察觉的微妙错误,因为它们能够流畅地融入对话,并且乍一看不会造成语义或逻辑上的不一致。当LLM被用于司法系统、医疗领域或警务等高风险领域时,这尤其是个问题。最终,LLM被允许对信息领域做出重大贡献的越多,人们就必须调整他们对模型行为的期望。迄今为止,直觉行为只与人类有关,而与机器无关。如果机器直觉在技术上可以减少或根除,这种观点就可以得到支持。然而,当假设这行不通时,人们应该开始期待人工代理也能凭直觉行事。