摘要
Web3旨在创建一个与支持当今互联网的现代云基础设施相竞争的去中心化平台。然而,Web3仍然有限,仅支持内容创建和共享、去中心化融资和去中心化通信领域的应用程序。这主要是由于支持Web3的技术:区块链、IPFS和libp2p,这些技术虽然为开发Web3应用程序提供了大量工具,但在设计和性能方面仍然有限。这促使人们需要更好地理解这些技术,以实现能够将Web3发挥到最大潜力的新颖优化。不幸的是,了解一个完全去中心化的大规模分布式系统的当前行为是一项艰巨的任务,因为没有一个集中的权威机构完全了解系统的运行情况。
为此,在本文中,我们描述了Web3的关键推动者IPFS的工作负载。为了实现这一点,我们收集了两周内用户对北美最流行的IPFS网关之一的访问记录。通过对这些痕迹的精细分析,我们收集了对系统的请求量,并找到了请求内容的提供者。利用这些数据,我们可以描述请求和提供内容的流行程度,以及它们的地理位置(通过将IP地址与MaxMind数据库匹配)。我们的结果表明,IPFS中的大多数请求都只针对少数不同的内容,这些内容由系统中的大部分对等方提供。此外,我们的分析还表明,大多数请求是由系统中最大的两个提供商提供的,这两个提供商位于北美和欧洲。根据这些见解,我们得出结论,当前的IPFS架构是次优的,并提出了未来的研究议程。
1 简介
今天的互联网由包括谷歌、亚马逊和微软在内的大型云提供商提供支持。这些提供商支持各种各样的网络服务,这些服务大规模地为分散在世界各地的大量用户提供服务。然而,这种范式迫使应用程序提供商完全依赖和信任易受攻击的集中式云基础设施[10,14],并在几乎没有竞争的情况下规定服务条款。此外,在大多数应用场景中,用户数据的控制以某种方式被放弃给这些运营商,这是不可取的(并且是欧洲GDPR等立法的目标)。为了解决这一问题,并通过区块链技术所带来的日益普及和使用案例[21,29],Web3[13]的概念应运而生。Web3旨在通过使用现有的新型对等协议来分散web技术,以提高用户安全性和隐私,并提供内容的所有权保障[16,25]。
然而,Web3仍处于早期阶段,在灵活性、应用程序开发、安全性和隐私性以及性能方面尚未与现代云基础设施竞争。这是由于当前Web3的主要技术支持因素:区块链,它维护和复制系统状态;libp2p[24],用于开发去中心化应用程序(dApp)及其支持;以及IPFS[2,27],它被用作大多数dApp的入口点,这些dApp仍然限于内容创建和共享[8,22]、去中心化融资[28]和去中心化通信[3,6]等领域。这是因为,区块链虽然对去中心化很重要,但也限制了应用程序可以进行的交互,因为这些交互大多是通过区块链进行的。此外,IPFS仍有很大的性能改进空间,因为最近的研究表明,在IPFS中搜索内容可能需要2.5小时[4]。
这些技术中的大多数依赖于点对点协议,这在过去是大量研究的主题。然而,大多数Web3技术要么没有意识到这项研究(这是大多数区块链采用洪水传播[7]而不是更有效的八卦传播[17]来传播挖掘的区块的情况),要么使用研究中描述的类似配置来利用它,有时会遇到性能问题(IPFS中的DHT就是这样)。然而,了解性能问题的原因以及如何在去中心化的大规模分布式系统上减轻这些问题是一项非常重要的任务,因为没有一个节点可以对系统状态进行全局查看。因此,至关重要的是设计技术并分析从这些系统获得的数据,以了解当前环境、工作负载和系统分布,然后指导Web3支持的研究和优化[20]。
在本文中,我们深入分析了IPFS的工作负载。我们收集了北美最受欢迎的IPFS网关之一的两周日志。这些日志包含世界各地IPFS用户对IPFS中存储的大量内容的(访问)请求。我们分析了这些日志,并执行了日志中观察到的相同(有效)请求,以获取有关所请求内容的提供者的信息。这允许两件事:第一,关联哪些和多少提供商提供了哪些和多少请求的内容。其次,通过使用将IP地址与地理位置信息相匹配的MaxMind[18]数据库,找到请求源位置和内容提供商位置与这些请求的关系。利用这些数据,我们分析了IPFS工作负载,发现大多数内容仅由位于北美和欧洲的少数提供商提供。
本文的其余部分结构如下:在第2节中,我们简要描述了IPFS网络及其运行方式。在第3节中,我们详细介绍了收集和分析数据的方法。在第4节中,我们描述了我们的结果,提供了有关IPFS网络工作负载的见解。在第5节中,我们将讨论相关工作。最后,第6节总结了本文,并提出了最后的意见和未来工作的方向。
2 IPFS
IPFS是一个大规模的点对点分布式系统,旨在通过共享文件系统连接计算设备。为了实现这一点,IPFS依赖libp2p[24]来处理网络方面的问题。为了连接网络中的对等点,libp2p依赖于分布式哈希表(DHT),作为Kademlia协议的变体实现[19]。IPFS利用该DHT来分发和搜索系统中的内容和对等点。IPFS中的内容是不可变的,每个内容都关联一个标识符(cId),该标识符是内容的多哈希1。类似地,IPFS中的每个对等体也有一个标识符(peerId),它是对等体公钥的多哈希。对等方根据其对等方ID的SHA-256哈希在DHT中组织自己,并根据cId的SHA-25哈希存储内容指针。此外,每个对等体都有一个多地址列表,这些地址描述了对等体的互联网地址(可以是ipv4、ipv6、dns或其他类型的地址)。
注意,对等体不存储内容本身,而仅存储指向提供内容的对等体的指针。因此,对于在IPFS上发布内容的对等方,该对等方有效执行的操作是宣布它通过在IPFS发布提供者记录来提供内容。提供程序记录包含cId到peerId的映射,即其提供程序。根据Kademlia操作,此提供程序记录将存储在DHT上与cId哈希值最近的k个对等方中。在IPFS中,k的值为20。注意,相同的内容可以由多个对等方提供。
为了获取内容,IPFS使用一个名为Bitswap[5]的协议,该协议同时执行数据恢复和数据传输。为了让Bitswap发现内容,它开始对cId执行本地一跳洪泛请求。这将向所有相邻对等体发送一条消息,询问它们是否在本地拥有cId。如果答案是肯定的,Bitswap开始使用类似于BitTorrent[9]的过程传输内容。如果响应是否定的,并且在相邻对等体上找不到内容,则它会求助于DHT来查找cId的提供者记录。一旦Bitswap获得一条提供商记录,它将开始尝试从该记录上的提供商传输内容。
IPFS有两种操作模式:作为服务器或作为客户端节点。服务器节点(通常)可在互联网上公开访问,并保存在DHT中,以实现对等体之间的路由并向网络提供内容。客户端节点连接到DHT,但不维护DHT,这意味着客户端节点只能执行对DHT的请求,而不能在路由过程中提供帮助。此外,IPFS对等体还可以充当网关,其中IPFS节点还运行web服务器,该服务器通过浏览器界面向用户授予对IPFS的访问权限。更详细地说,网关节点能够将HTTP请求转换为有效的IPFS请求,这将触发Bitswap和/或DHT操作。
此外,并非所有IPFS节点都可以公开访问。NAT后面的节点就是这种情况。在这种情况下,IPFS节点可以请求公共可访问的IPFS节点为该节点中继流量。
3 方法
在本节中,我们详细描述了研究和表征IPFS工作量的方法。总之,我们从位于北美的最受欢迎的IPFS网关之一IPFS.io收集了两周(2022年3月7日至3月21日)的日志。这些日志是由nginx HTTP服务器生成的,该服务器记录每个HTTP请求。因此,日志中的每个条目都包含用户向IPFS网关发出的HTTP请求。
为了处理这些日志,我们过滤了所有无效的HTTP请求(例如POST操作、格式错误条目),并提取了每个有效HTTP请求中的cId。由此,我们从IPFS获取每个cId的所有可用提供程序记录。为了从请求方和提供商处获取地理位置信息,我们将找到的IP地址与MaxMind GeoLite2免费地理位置数据库进行了匹配[18]。
最后,我们对请求的和提供的cId上的两个数据集进行了匹配,以生成一个全局视图,该视图显示请求内容的位置和提供内容的位置。在下文中,我们将更详细地描述此过程。
3.1 处理请求
分析IPFS工作负载的第一步是提取请求的cId。为此,我们将网关日志解析为易于处理的结构化数据格式。网关日志由nginx服务器生成,它有效地充当充当IPFS网关的IPFS服务器节点的反向代理。每个日志条目包含有关IPFS网关接收的HTTP请求的信息。特别是,我们对HTTP请求的以下信息感兴趣:请求者的IP地址,以提取地理位置信息;HTTP操作和HTTP状态,以过滤用于我们研究的不需要的HTTP请求(例如POST操作和400 GET操作状态);以及有效地包含请求的cId的HTTP目标和HTTP主机。
我们首先过滤不合格式的日志。这相当于所有请求的0.001%,包括具有不可解析的HTTP目标的请求,该字段中包含十六进制十进制代码。接下来,我们删除所有不是GET HTTP请求的请求,因为这些请求是唯一真正向IPFS发出请求的请求。这将过滤日志中包含的所有请求的大约19%,几乎81%的日志条目只有GET操作。
然而,并非所有GET操作都对处理工作负载感兴趣。对于未成功的GET操作(即,回复的HTTP状态代码为400)或请求中不包含cId的GET操作就是这样。我们过滤未成功的GET操作,因为这些操作很可能是内容无效(即,它从未在IPFS中)或内容在请求时不再可用。至于请求中的cId,它们出现在通过将HTTP主机字段与HTTP目标字段连接而获得的请求的完整url中。注意,这种情况下的HTTP主机可以是ipfs.io(即网关主机),在这种情况下,cId将出现在HTTP目标上;或者可以采用<cId>.ipfs.dweb.link的形式,在这种情况下,cId位于HTTP主机部分。还要注意,这些url包含指向请求内容的文件系统路径,但是cId可能表示该路径或文件中的文件夹。在url包含多个cId的情况下,我们只考虑根cId(即位于文件系统路径开头的cId),实际上,在根cId下找到的所有cId也很可能由同一个提供程序对等方提供。这还将根cId下的cId请求分组到根cId,这不会改变对cId的请求频率,因为根cId始终包含剩余的cId。
使用这个过滤器,我们过滤掉了41%的GET操作,其中17%的GET操作没有成功,24%的请求没有包含cId。因此,47%的请求仍然是有效的GET操作,这是我们研究中考虑的操作。表1总结了我们为研究处理的请求。
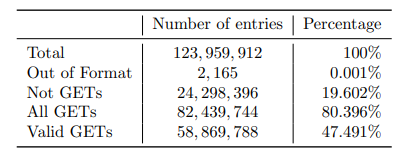
表1:处理的请求摘要。
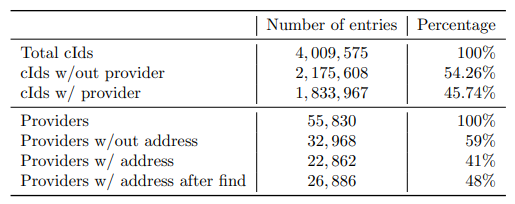
表2:提供商处理的摘要。
3.2 查找内容提供商
研究和表征IPFS工作负载的第二步是收集所请求内容的提供商的信息,以了解服务内容的位置和数量。为了实现这一点,我们开发了一个简单的libp2p程序,它连接到IPFS并请求给定cId的所有提供者。我们的程序利用了这样一个事实,即IPFS使用libp2p提供的相同网络软件堆栈和DHT(默认情况下连接到IPFS网络)来对libp2p的DHT执行FindProviders API调用,以获取cID的提供者。
在5869788个有效GET操作中,总共请求了4009575个不同的cID。我们通过libp2p程序请求了所有这些cID的提供者。我们发现我们无法找到54%的cID的提供者。这可能是由于内容在网络上不再可用(请注意,这项研究是在网关记录请求数月后进行的)。从与提供商的cID中,我们发现了55830个不同的提供商,但其中59%的提供商没有任何与之相关的地址信息。这意味着存储提供者记录的对等方在30分钟的窗口内没有接收到关于提供者的任何更新(来自任何类型的流量),因此,存储提供者纪录的对等方假设提供者可能已经移动并且具有不同的地址,从而忘记了提供者的多地址。在这些情况下,为了获取多地址,我们再次向DHT查询提供者的多地址,并设法找到了另外4024个提供者(我们最初发现的提供者增加了7%)的多地址。表2总结了已处理的cID和找到的提供程序的数量。
3.3 分析数据
研究和描述IPFS工作负载的最后一步是将请求和提供者数据结合起来,从世界上的何处执行请求,以及提供/可用的内容。这需要我们从收集的数据中提取地理位置数据。为此,我们使用MaxMind GeoLite2免费地理位置数据库[18],该数据库提供大量公共IP地址的地理位置。但是,此数据库不完整,可能具有地理位置未知的IP地址。幸运的是,对于请求数据,所有IP地址都具有地理位置信息。另一方面,只有88%的地址提供商拥有地理位置信息。
请注意,提供者由peerId标识,并且具有多个多地址。为了获得提供的地理位置信息,我们必须提取多地址的(公共)IP地址。对于包含协议ip4和ip6的多地址,此过程很简单。这相当于98%的所有观察到的多地址(不包括本地地址,例如127.0.0.1和::1);0.6%的多地址是DNS地址,我们用本地DNS解析器解析;而其余1.4%的多地址是中继多地址,因此提供商没有公共可访问IP地址,我们在本研究中忽略了这一点。对于显示有多个位置的提供商(可能是由于VPN服务),我们考虑了最后观察到的位置。这些只是一些不影响我们研究的病例。
为了便于分析,我们将两个数据集都插入到PostgreSQL数据库中。该数据库有两个表,一个包含请求,另一个包含提供程序。请求表存储请求标识符(reqId)、最初向网关发出请求的时间戳、请求的cId和请求者的位置信息。请求表的键是reqId,这是请求日志条目的哈希,以避免处理日志中的重复请求条目。providers表存储:提供的cId、提供程序的peerId和提供程序的位置信息。提供程序表的密钥为cId和peerId。这唯一地标识了每个提供程序条目,因为每个cId可以有多个提供程序,并且一个提供程序可以提供多个cId。还要注意,providers表中的cId是requests表中cId的外键。
通过对请求和提供者表执行联接,我们可以计算从执行请求的位置到提供请求的位置的映射。在下一节介绍结果之前,我们将提供一些实现细节来处理和查找提供者数据。
3.4 实施细节
用于处理本研究数据的代码和脚本可在https://github.com/pedroAkos/IPFS-location-requested-content.数据处理需要对IPFS查询的并行化进行微调,以使其变得及时。这是必需的,因为IPFS可能需要一些时间才能从DHT检索提供者记录;根据我们的研究,平均潜伏期约为6秒,最大潜伏期可达1.5小时;我们对IPFS进行并行查询以获取提供者记录。然而,libp2p可能会对网络造成极大的负担,因为一个libp2p节点可以维护数百个连接并执行数千个请求。为了说明这一点,一个并行执行100个查询以查找提供者的过程每分钟将产生近10000个数据包。解决所有4009575个不同的cID的过程花费了大约40个小时。
4 结果
在本节中,我们分析了我们的研究结果,以描述IPFS工作负载。特别是,我们有兴趣回答以下问题:
1.平均每天向IPFS发出多少请求?
2.请求频率如何分布在系统中的不同cID上?
3.提供商在系统中的地理分布如何?
4.如何在系统中跨提供商分发所提供的内容?
5.所请求内容的位置与所请求内容提供商的位置如何关联?
为了回答这些问题,我们首先从请求的角度分析数据,通过分析从网关日志中提取的请求数据(第4.1节)。然后,我们使用直接从IPFS中提取的数据从提供商的角度分析该数据(第4.2节)。最后,我们分析请求和提供者数据,以产生请求源位置和内容提供者之间的相关性(第4.3节)。
4.1 请求
在本节中,我们将从内容获取器的角度分析结果。因此,我们旨在回答分析的前两个问题。平均每天向IPFS发出多少请求?以及请求频率如何分布在系统中的不同cID上?我们首先回答第一个问题。
图1表示网关每小时处理的客户端请求。请注意,图1a捕捉了两周内(x轴)发出的所有请求,图1b捕捉了相同的请求,但以大洲为特征,图1c只关注分析期前3天以大洲为特点的请求,夜间时间在网关的时区(GMT-7)上加上阴影。
图1a显示,平均每小时向IPFS网关发出超过15万个请求,达到每小时最多275000个请求。请注意,在2022-03-14这天,请求突然下降。我们验证了这一点,事实上,我们从那天开始的日志在几个小时后(就在5小时标记之前)突然停止。最有可能的是,这是由于当天网关出现问题,导致它在大约9个小时内无法访问,之后网关会定期恢复处理请求。
从图1b中我们可以看到,大多数网关流量来自北美(NA)和亚洲(AS),每个地区的平均每小时请求数超过75000个。每小时请求最多的第三个地区是大洋洲(OC),平均每小时约有2500个请求。其次是欧洲(EU),平均每小时约85个请求,非洲(AF),平均每个小时约57个请求,南美洲(SA),平均只有3个请求。根据这些结果,我们得出结论,该IPFS网关主要处理来自北美和亚洲的大量请求。请注意,其他地区也有其他公共网关,尽管最受欢迎的网关中,大多数位于北美,一些位于欧洲。
为了了解这种高流量是否具有昼夜模式,在图1c中,我们绘制了分析前3天每天的请求,并对表示夜间周期的绘图区域进行了阴影处理。注意,x轴上的时间表示网关的时间(北美GMT-7时区)。从这些结果来看,北美交通的昼夜模式并不明显。然而,夜间交通量略有增加的趋势,尽管很小。另一方面,我们也注意到,如果我们改变时区,亚洲交通也不会清晰地遵循昼夜模式。很明显,随着时间的推移,亚洲和北美的流量呈现出某种对称的模式,其变化相互抵消,从而始终保持网关上的高流量和几乎恒定的流量负载。这有效地表明,IPFS网络从不空闲。
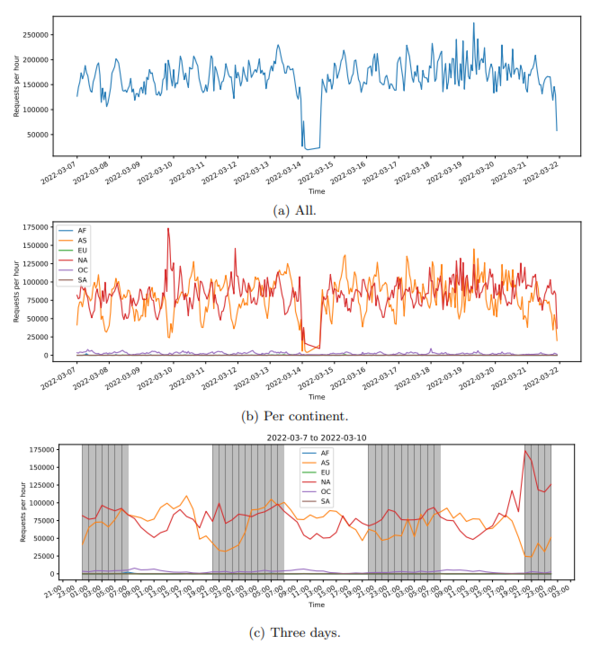
图1:随时间变化的请求。
图2和图3表示了对cId执行请求的频率(即用户从网关请求cId的次数)。这些结果有助于回答问题#2:请求频率如何分布在系统中的不同cID上?
图2a显示了所有请求的cID的ECDF。注意,x轴(表示请求的频率)是对数刻度。y轴捕获最多访问该数量的请求cId的比例。我们注意到,几乎一半的cID只请求一次。之后,频率随着cID比例的增加而增加,其中,大约90%的所有cID被请求最多10次,大约99%的所有cId被请求最多100次。图2b补充了ECDF,显示了请求频率(在y轴上显示)在cID数量(在x轴上显示的)上的分布。此分布中的每个点表示请求的次数。请注意,此图的两个轴均为对数刻度。从这个图中,我们可以看到请求频率随cID数量的变化趋势,这类似于典型的Zipf分布。表3总结了前10个请求的cID的频率。我们可以进一步补充,前10个请求最多的cID中的大多数是与非真菌令牌(NFT)相关的数据,这表明这是IPFS的主要用例。
图3显示了相同的信息,但以以下地区为特征:非洲(AF)、亚洲(AS)、欧洲(SA)、北美(NA)、大洋洲(OC)和南美洲(SA)。图3a显示了按区域区分的请求cId频率(在对数尺度的x轴上)与请求比例(在y轴上)的ECDF。我们注意到,几乎60%来自亚洲的请求最多请求三次相同的cId,而60%来自北美的请求只请求一次相同的c ID。这表明,与其他地区相比,从亚洲请求的内容更受欢迎(即,相同的cID被请求的频率更高)。图3b补充了ECDF中请求频率(以对数比例显示在y轴上)在cID数量上的分布(以对数形式显示在x轴上)。然而,它表明,所有地区似乎都呈现出类似的Zipf分布,尽管比例不同,这与每个地区的请求率成正比。
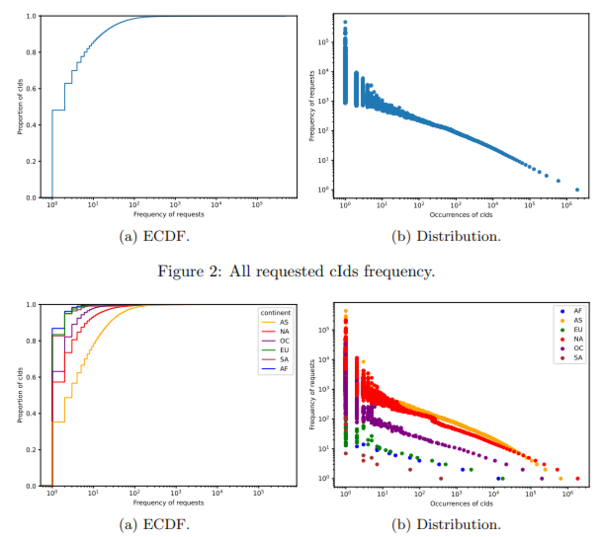
图3:每个大陆请求的cIds频率。
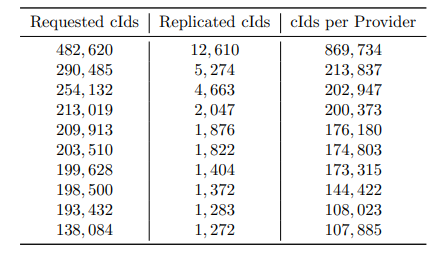
表3:按降序排列的前10位数据汇总。第一列表示对每个cId的请求量。第二列表示每个cId的副本数量。第三列表示每个提供程序节点提供的不同cId的数量。每一列都是独立的,对不同的cId和提供程序进行编码。
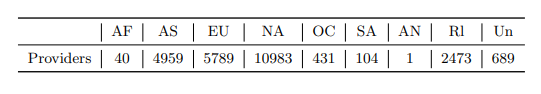
表4:供应商地理分布。
4.2 供应商
在本节中,我们从提供者的角度分析结果。因此,我们的目标是回答分析中的问题#3和#4。提供者在系统中的地理分布如何?以及如何在系统中跨提供商分发所提供的内容?
表4中的结果回答了第一个问题。其显示了每个大陆的提供商数量。请注意,北美(NA)的供应商数量几乎与欧洲(EU)和亚洲(as)的数量相同。这表明,北美是IPFS系统中内容提供商的最大部分(这与先前的研究[1,11]相印证)。此外,请注意表中的最后两列,它们表示只有中继地址(标记为Rl)的提供商,这意味着它们位于NAT之后,没有公共地址;以及位置信息未知的提供商(标记为Un),这意味着MaxMind数据库中没有这些提供商公共IP地址的条目。由于Rl节点的位置也是未知的,因此从这一点起,所有Rl节点都被视为属于Un类别。
回答问题4:所提供的内容是如何在系统中跨提供商分发的?我们分析了系统中的内容复制量(图4)和系统中每个单独提供者节点提供的(不同)内容量(图5)。
图4分析了不同提供商上复制内容的数量。图4a显示了一个ECDF,它捕获了系统中cID比例(在y轴上)的副本数量(在对数尺度的x轴上)。我们注意到,系统中几乎70%的cID最多复制两次(即,由系统中最多两个不同的提供程序节点提供)。只有很小比例的cID被大量的提供者复制。表3总结了前10个复制的cID的副本数量,在查看这些cID后,我们发现其中大多数是IPFS手册页。我们验证了这些高度复制的cID是否也是请求最多的cID,并发现事实并非如此。事实上,前10个请求的cID在系统中没有很好的复制,只有几个提供者(这些cID中只有3个提供者超过10个,最多的提供者是29个和28个同行)。图4b按区域划分了cId副本。在这里,我们注意到非洲拥有最多的cID复制品,尽管这并不代表大量,因为该地区只有少数供应商。虽然在图中看不到,但有一小部分cID在北美高度复制。这并不奇怪,因为北美拥有最多的内容提供商。然而,这些结果表明,通过系统中的复制,所提供内容的高可用性非常有限。这主要可以通过复制内容的方式来解释,其中用户在从其他提供商获取内容副本后需要进行显式(重新)提供操作。
图5显示了每个提供者提供的不同cID的数量。图5a显示了提供不同数量的cId(在对数尺度的x轴上)的提供者比例(在y轴上),这里我们可以看到60%的提供者只提供一个cId。我们还注意到,不到10%的提供商提供至少10个cID,只有极少数提供商提供至少1000个cID。提供更多cID的提供者占提供cID的最大部分,这意味着大多数cID由同一小部分提供者提供。这并不奇怪,因为存在针对IPFS内容的钉扎服务(在服务提供商收费控制的服务器中为IPFS上的用户托管内容的服务)。表3总结了cID最多的前10个提供商。其中一些提供商具有DNS多地址,我们验证了这些提供商的DNS记录,表明这些提供商属于nft.storage,这是IPFS中nft内容的流行存储服务。图5b分析了按大陆分类的提供不同数量cID(在对数尺度的x轴上)的提供商的比例(在y轴上),这表明大型提供商主要位于北美(NA)、欧洲(EU)和大洋洲(OC)。cID的大部分仅由一小部分提供商提供,这一事实表明,尽管IPFS是一个去中心化的内容网络系统,但存储在IPFS中的内容在这一小部分的提供商对等体中呈现出高度集中。
4.3 请求的内容与提供的内容
最后,在本节中,我们将从请求和提供者收集的数据结合起来,以获得工作负载的全局视图,并回答最后一个问题:请求内容的位置与请求内容的提供者的位置如何关联?
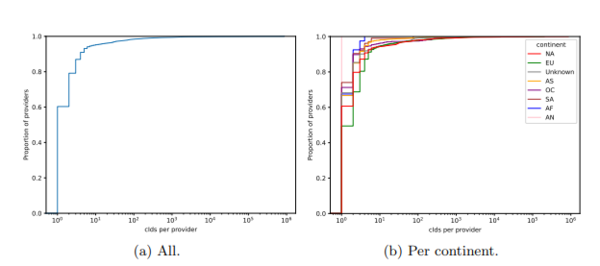
图5:每个提供者的cId。
为此,我们将请求的源位置与提供者位置相匹配,生成一个热图(如图6所示),该热图将每个请求发出的位置与具有请求内容的提供者的位置相匹配。在图6中,行表示请求源的位置,而列表示提供程序的位置。注意,根据前面讨论的cId复制因素,单个请求可以由多个位置提供服务。我们将每个区域的请求标准化,以消除请求数量的差异,在热图上显示从一个区域到任何其他区域(包括其本身)的所有请求的百分比。
通过分析热图,我们注意到来自所有地区的绝大多数请求都是由北美或欧洲的提供商提供的。这并不奇怪,因为绝大多数内容都位于这些地区。此外,从这张热图中,我们可以得出结论,北美地区包含最受欢迎的cID,根据之前的观察,请求遵循Zipf分布,我们也可以得出结论:Zipf不是每个地区独立的。最后,可以从中得出的一个重要结论是,IPFS确实是一个全球范围的分布式服务,用户使用它来共享大部分不是本地的内容,否则我们应该观察到用户访问的大部分内容将由同一地区的提供商提供服务(即,热量将主要集中在热图的对角线上)
5 相关工作
测量和理解大规模和分散系统的行为一直是一项重要任务,在20世纪初,大量研究都是针对对等系统进行的。我们特别强调了两个对等系统的研究,一个研究还分析了大规模系统的流量,另一个研究描述了BitTorrent的工作负载。第一个[26]从单个ISP的角度分析了FastTrack、Gnutella和DirectConnect等大型网络上的对等流量。他们的发现与我们的发现相似,因为他们也观察到大部分流量是由极少数主机产生的。第二项研究[23]分析了流行的BitTorrent对等文件共享系统。在这项研究中,作者在系统中进行主动测量,以获得与上传和下载速度相关的数据。另一方面,我们的研究侧重于系统的其他方面,例如通过系统发布和访问的内容的分布和流行程度以及对该内容的访问模式。
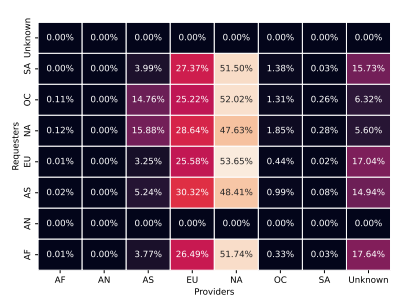
图6:请求位置。
最近对点对点系统的研究包括比特币和以太坊等区块链系统。在这里,我们重点介绍了两项研究[12,15],重点是比特币和以太坊区块链内的交易。这些研究描述了区块链系统的性能,但未能提供有关系统网络属性的见解,例如每个区域的对等点数量或对等点的工作负载分布。我们的研究通过关注IPFS来补充这些,IPFS是Web3生态系统日益相关的解决方案。
最后,我们强调了IPFS上的另外两项研究[23,26],这些研究与我们自己的研究是互补的。第一项研究[26]旨在绘制IPFS图,以了解区域内对等体的分布。我们自己的研究证实了这项工作的发现,并对提供商提供的内容的流行程度进行了描述。第二项研究[23]侧重于系统内Bitswap流量的表征,以及它如何影响隐私。我们的研究重点是通过主要公共IPFS网关在系统外部生成的流量。然而,用从Bitswap流量中提取的观察结果补充我们的研究是未来工作的目标。
6 结论
在本文中,我们对最流行的IPFS网关之一处理的流量进行了研究,以帮助指导未来Web3系统的优化设计。流量显示了世界各地对IPFS内容的请求量,尽管主要来自北美和亚洲。我们收集请求并在IPFS系统上执行搜索,以查找每个请求内容的提供者及其位置。我们分析了两个数据集,发现请求遵循Zipf分布,其中最受欢迎的请求内容仅由少数提供商提供。这意味着IPFS没有得到很好的平衡,这可能会导致这些流行的提供程序节点对请求过度饱和。根据我们的观察,我们提出了一项研究议程,以改进IPFS,其中包括以下几点:
- IPFS需要减轻高度流行的提供商的负担。为了实现这一点,需要新的激励机制来激励获取内容的对等方也复制内容。
- 由于IPFS在DHT上发布提供商记录,因此DHT上的负载将无法通过复制内容的提供商数量的增加来平衡。这是因为记录仍将存储在DHT的同一对等节点中,这表明DHT为负载平衡IPFS工作负载提供了次优设计。
- 监控大规模系统是一项重要任务,需要持续进行,因为用户和应用程序模式可能会发生变化。有必要补充这些类型的研究,从野外运行的系统中进行更多的观察。然而,为了实现这一点,需要在这些Web3系统中集成强大的遥测协议。
