2022年12月,旧金山公司OpenAI发布了一款网络应用程序ChatGPT,这款聊天机器人几乎在一夜之间成为主流。据估计,它是有史以来增长最快的互联网服务,在推出仅两个月后的1月份就达到了1亿用户。通过OpenAI与微软的100亿美元交易,这项技术现在被内置到Office软件和Bing搜索引擎中。谷歌在搜索领域的竞争对手的刺激下,迅速推出了自己的聊天机器人LaMDA,现在就连WhatsApp也带有ChatGPT聊天功能。
但OpenAI的突破并非凭空而来,聊天机器人是多年来一系列大型语言模型中迄今为止最完善的迭代,就是这样走到今天的。
20世纪80 - 90年代:循环神经网络
ChatGPT是GPT-3的一个版本,GPT-3也是OpenAI开发的一个大型语言模型,语言模型是一种经过大量文本训练的神经网络。(神经网络是一种软件,灵感来自动物大脑中神经元相互传递信号的方式。)因为文本是由不同长度的字母和单词序列组成的,语言模型需要一种能够理解这类数据的神经网络。发明于20世纪80年代的循环神经网络可以处理单词序列,但它们的训练速度很慢,可能会忘记序列中之前的单词。
1997年,计算机科学家Sepp Hochreiter和Jürgen Schmidhuber通过发明LTSM(长短期记忆)网络解决了这个问题,这是一种具有特殊组件的循环神经网络,可以让输入序列中的过去数据保留更长时间。ltsm可以处理几百字长的文本字符串,但他们的语言技能有限。
2017年:Transformers
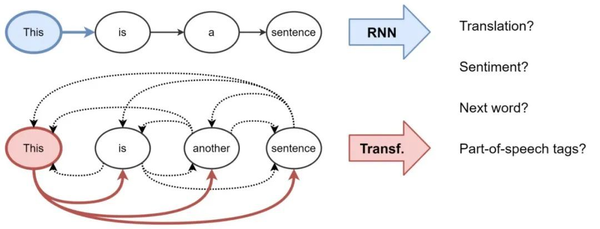
谷歌的一个研究团队发明了transformer,这是一种神经网络,可以跟踪每个单词或短语在序列中的出现位置,这是今天这一代大型语言模型背后的突破。单词的意思通常取决于前面或后面其他单词的意思,通过跟踪这些上下文信息,转换器可以处理较长的文本字符串,并更准确地捕捉单词的含义。例如,“hot dog”在“hot dogs should be given plenty of water”和“hot dogs should be eat with mustard”这两个句子中的意思是非常不同的。
2018-2019: GPT和GPT-2
OpenAI的前两个大型语言模型仅仅相隔几个月,该公司希望开发多技能、通用的人工智能,并认为大型语言模型是实现这一目标的关键一步。GPT(生成式预训练transformer的缩写)插上了一面旗帜,击败了当时最先进的自然语言处理基准。
GPT将transformer与无监督学习结合起来,无监督学习是一种训练机器学习模型的方法,它使用的数据(在这种情况下,是大量的文本)事先没有标注,这使得软件可以自己找出数据中的模式,而不需要被告知它在看什么。以前机器学习的许多成功都依赖于监督学习和注释数据,但手工标记数据是一项缓慢的工作,因此限制了可供训练的数据集的大小。
但是GPT-2却引起了更大的轰动。OpenAI声称,他们非常担心人们会使用GPT-2“产生欺骗性的、有偏见的或辱骂性的语言”,因此不会发布完整的模型。
2020:GPT-3
GPT-2令人印象深刻,但OpenAI的后续GPT-3更让人大吃一惊。GPT-3生成类似人类文本的能力是一个巨大的飞跃,GPT-3可以回答问题、总结文档、生成不同风格的故事、在英语、法语、西班牙语和日语之间进行翻译等等,它的模仿能力是不可思议的。
最显著的收获之一是GPT-3的收益来自于现有技术的超大规模,而不是发明新技术。GPT-3有1750亿个参数(在训练过程中被调整的网络值),而GPT-2只有15亿,它还接受了更多的数据训练。
但是对从互联网上获取的文本进行训练会带来新的问题,GPT-3吸收了它在网上发现的许多虚假信息和偏见,并按需转载,正如OpenAI所承认的那样:“经过互联网训练的模型具有互联网规模的偏见。”
2020年12月:有毒文本和其他问题
当OpenAI在努力克服GPT-3的偏见时,科技界的其他公司正面临着一场高调的清算,因为它们未能遏制人工智能的有害倾向。大型语言模型会吐出错误甚至是有害的文本,这已经不是什么秘密了,但研究人员发现,解决这个问题并不是大多数大型科技公司的待办事项。谷歌的人工智能伦理团队联合主管Timnit Gebru与人合著了一篇论文,强调了与大型语言模型相关的潜在危害(包括高昂的计算成本),但该论文不受公司内部高级经理的欢迎,2020年12月,Gebru被解雇。
2022年1月:InstructGPT
OpenAI试图减少GPT-3产生的错误信息和攻击性文本的数量,方法是使用强化学习来根据人类测试人员的偏好训练模型的一个版本。结果,InstructGPT在遵循使用它的人的指示方面更好——在人工智能术语中称为“对齐”——并且产生了更少的攻击性语言、更少的错误信息和更少的整体错误。简而言之,InstructGPT不是一个混蛋——除非它被要求成为一个混蛋。
2022年5月至7月:OPT, BLOOM
对大型语言模型的一个常见批评是,训练它们的成本使得除了最富有的实验室之外的所有人都很难建立一个,这引发了人们的担忧,即如此强大的人工智能是由小型企业团队关起门来开发的,没有适当的审查,也没有更广泛的研究团体的投入。作为回应,一些合作项目开发了大型语言模型,并免费发布给任何想要学习和改进技术的研究人员。Meta建造并赠送了GPT-3的重建版OPT,Hugging Face 领导了一个由大约1000名志愿研究人员组成的联盟,建立并发布了BLOOM。
2022年12月:ChatGPT
即使是OpenAI也被ChatGPT的接受程度所震撼,在ChatGPT上线前一天,该公司的一个演示,它被定位为InstructGPT的增量更新。与该模型一样,ChatGPT使用强化学习来训练来自人类测试人员的反馈,这些测试人员将其表现为流畅、准确和不冒犯的对话者。实际上,OpenAI训练GPT-3掌握对话游戏,并邀请所有人来玩。从那以后,数百万人一直在玩游戏,现在已突破上亿用户了。
参考链接:https://www.technologyreview.com/2023/02/08/1068068/chatgpt-is-everywhere-heres-where-it-came-from/
