本文对支持ChatGPT的机器学习模型的进行介绍,将从介绍大型语言模型开始,深入研究革命性的自我注意机制,使GPT-3能够被训练,然后深入研究从人类反馈中强化学习,这是使ChatGPT出类拔萃的新技术。
大型语言模型
ChatGPT 是一类被称为大型语言模型 (LLM) 的机器学习自然语言处理模型的外推。LLM可以消化大量的文本数据,并推断文本中单词之间的关系。这些模型在过去几年里不断发展,因为我们看到了计算能力的进步。LLM的能力随着输入数据集和参数空间的增加而增加。
语言模型最基本的训练包括预测单词序列中的一个单词。最常见的是,观察到这是下一个标记预测和掩码语言建模。
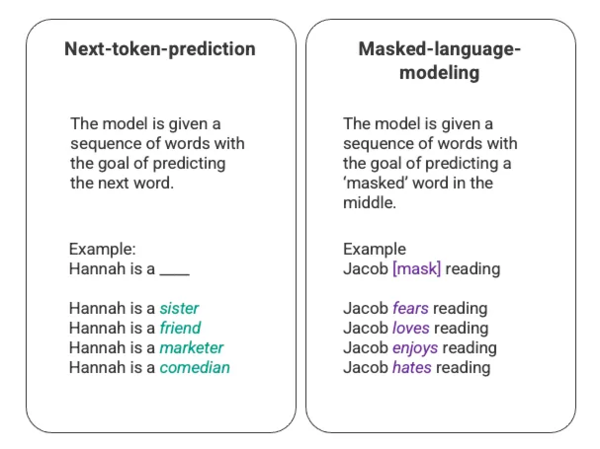
作者生成的下一个标记预测和屏蔽语言建模的任意示例
在这种基本的排序技术中,通常通过长期-短期-记忆(LSTM)模型部署,该模型在给定周围上下文的情况下,用统计上最可能的单词填充空白,这种顺序建模结构有两个主要的限制。
- 该模型无法对周围的某些单词进行更大的评价。在上面的例子中,虽然“阅读”可能最常与“讨厌”联系在一起,但在数据库中“雅各布”可能是一个狂热的读者,因此模型应该给予“雅各布”比“阅读”更多的权重,并选择“爱”而不是“讨厌”。
- 输入数据是单独和顺序处理的,而不是作为一个完整的语料库。这意味着在训练LSTM时,上下文窗口是固定的,仅扩展到序列中几个步骤的单个输入之外,这限制了词语之间的关系和可以推导的含义的复杂性。
针对这个问题,谷歌Brain的一个团队在2017年推出了transformer。与LSTM不同,transformer可以同时处理所有输入数据。使用自注意机制,该模型可以根据语言序列的任何位置,为输入数据的不同部分赋予不同的权重。这一特性极大地改善了LLM的含义,并能够处理更大的数据集。
GPT和自注意力
生成式预训练转换器(Generative Pre-training Transformer,GPT)模型于2018年由openAI首次推出,名为GPT-1。这些模型在2019年继续发展GPT-2, 2020年发展GPT-3,最近在2022年发展InstructGPT和ChatGPT。在将人类反馈整合到系统中之前,GPT模型进化的最大进步是由计算效率方面的成就驱动的,这使得GPT-3能够比GPT-2在更多的数据上进行训练,使其拥有更多样化的知识库和执行更广泛任务的能力。
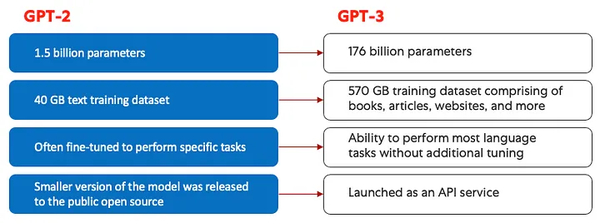
GPT-2(左)和 GPT-3(右)的比较
所有GPT模型都利用 transformer体系结构,这意味着它们有一个编码器来处理输入序列,有一个解码器来生成输出序列。编码器和解码器都有一个多头自注意机制,允许模型对序列的部分进行不同的权重来推断意义和上下文。此外,编码器利用掩码语言建模来理解单词之间的关系,并产生更容易理解的响应。
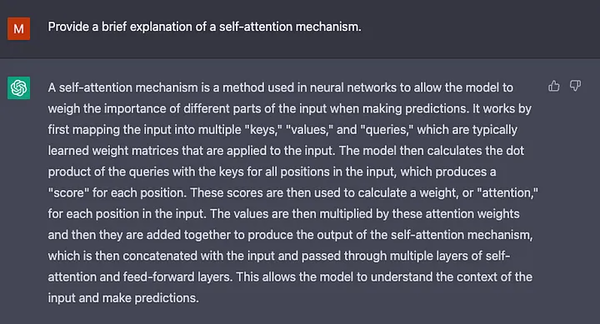
驱动GPT的自我注意机制通过将标记(文本片段,可以是单词、句子或其他文本分组)转换为表示输入序列中标记的重要性的向量来工作。为了做到这一点,这个模型:
1,为输入序列中的每个令牌创建查询、键和值向量。
2,通过取两个向量的点积来计算第一步的查询向量和每个其他令牌的键向量之间的相似性。
3,通过将第2步的输出输入softmax函数来生成规范化的权重。
4,通过将步骤3中生成的权重乘以每个令牌的值向量,生成一个最终向量,表示序列中令牌的重要性。
GPT使用的“多头”注意机制是自我注意的进化。该模型不是一次执行步骤1-4,而是多次迭代该机制,每次生成查询、键和值向量的新的线性投影。通过这种方式扩展自我注意,该模型能够抓住输入数据中的子含义和更复杂的关系。
尽管GPT-3在自然语言处理方面取得了显著的进步,但它与用户意图一致的能力有限。例如,GPT-3可能产生
- 缺乏帮助意味着他们不遵循用户的明确指示。
- 包含反映不存在或不正确事实的幻觉。
- 缺乏可解释性,使人类难以理解模型是如何做出特定决策或预测的。
- 包含有毒或有偏见的有害或冒犯性的内容,并传播错误信息。
ChatGPT引入了创新的培训方法,以抵消标准LLM的一些固有问题。
ChatGPT
ChatGPT是InstructGPT的衍生产品,InstructGPT引入了一种新的方法,将人类反馈整合到训练过程中,以更好地使模型输出与用户意图保持一致。OpenAI 2022年的论文《训练语言模型以遵循人类反馈的指令》中深入描述了从人类反馈中强化学习(RLHF),并在下面进行了简化。
第一步:监督微调(SFT)模型
第一个开发涉及对GPT-3模型进行微调,雇佣40个承包商来创建一个有监督的训练数据集,其中输入有一个已知的输出,供模型学习。输入或提示是从Open API的实际用户输入中收集的。然后标注人员对提示符编写适当的响应,从而为每个输入创建一个已知的输出。GPT-3模型随后使用这个新的监督数据集进行微调,以创建GPT-3.5,也称为SFT模型。
为了最大限度地提高提示数据集的多样性,任何给定的用户ID只能提供200个提示,并且将删除所有共享较长的公共前缀的提示。最后,所有包含个人身份信息(PII)的提示都被删除。
在聚合来自OpenAI API的提示后,标签商还被要求创建示例提示,以填写只有极少实际示例数据的类别。兴趣的类别包括:
- 简单的提示:任意的提问。
- 小样本提示:包含多个查询/响应对的指令。
- 基于用户的提示:对应于OpenAI API请求的特定用例。
在生成响应时,标注者被要求尽最大努力推断用户的指令是什么。本文描述了提示请求信息的三种主要方式:
- 直接:“告诉我关于……”
- 小样本提示:给出这两个故事的例子,再写一个相同主题的故事。
- 延续:给定故事的开头,完成它。
来自OpenAI API的提示的编译和标注者手写的结果是用于监督模型的13000个输入/输出示例。
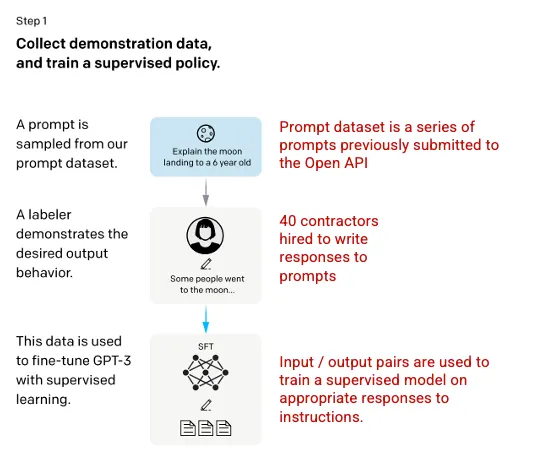
图片(左)从训练语言模型插入以遵循人类反馈的指令
第二步:奖励模式
在步骤1中训练SFT模型后,模型对用户提示产生更好的一致响应。下一个改进以训练奖励模型的形式出现,其中模型输入是一系列提示和响应,输出是一个称为奖励的标量值。奖励模型是利用强化学习所必需的,在强化学习中,模型学习产生输出以最大化其奖励(参见步骤3)。
为了训练奖励模型,标签者为单个输入提示提供4到9个SFT模型输出,他们被要求对这些输出进行从最好到最差的排名,创建如下的输出排名组合。
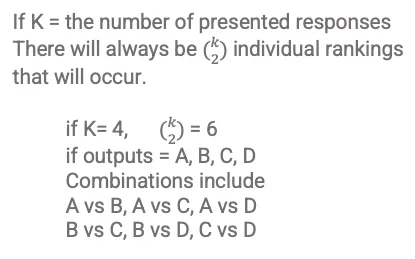
响应排名组合示例
将模型中的每个组合作为一个单独的数据点会导致过拟合(无法推断可见数据之外的数据)。为了解决这个问题,该模型是利用每组排名作为单个批数据点构建的。
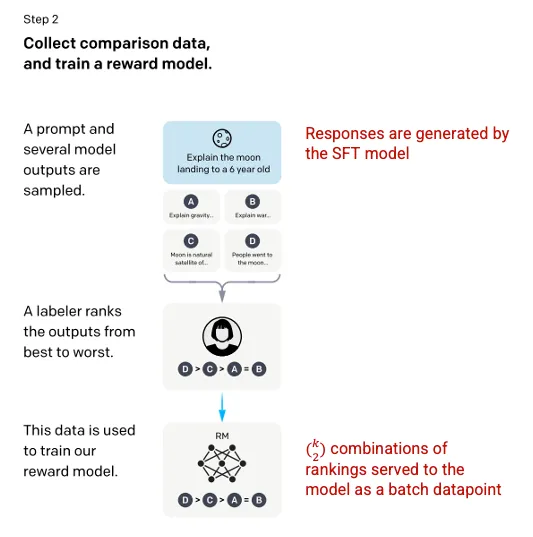
图片(左)从训练语言模型插入以遵循人类反馈的指令
第三步:强化学习模型
在最后一个阶段,模型会显示一个随机提示,并返回一个响应。响应是使用模型在步骤2中学习到的“策略”生成的。策略代表一种策略,机器已经学会使用它来实现它的目标;在这种情况下,最大化奖励基于步骤2中开发的奖励模型,然后为提示和响应对确定一个标量奖励值。然后奖励反馈到模型中以发展策略。
2017年,Schulman等人引入了近端策略优化(PPO),该方法用于在生成每个响应时更新模型的策略。PPO从SFT模型中合并了每个令牌的Kullback-Leibler (KL)惩罚。KL散度度量两个分布函数的相似性,并惩罚极端距离。在这种情况下,使用KL惩罚减少了响应与步骤1中训练的SFT模型输出之间的距离,以避免过度优化奖励模型,并严重偏离人类意图数据集。
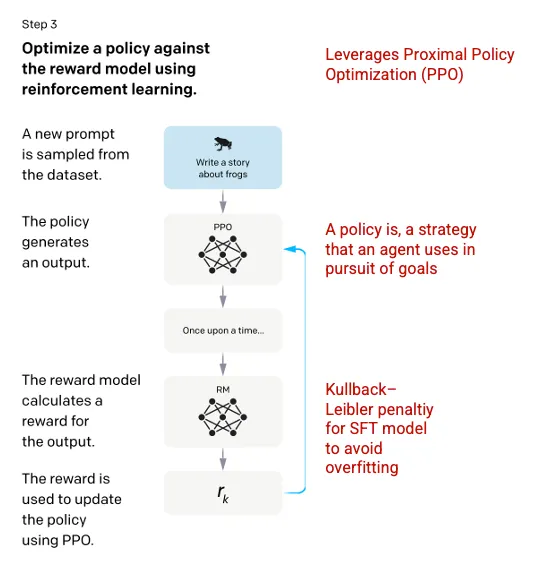
图片(左)从训练语言模型插入以遵循人类反馈的指令
该过程的第 2 步和第 3 步可以重复进行,但在实践中并没有广泛这样做。
模型评估
对模型的评估是通过在训练期间留出一个模型没有见过的测试集来执行的。在测试集上,进行了一系列评估,以确定该模型是否比其前身GPT-3更好地对齐。
帮助性:模型推断和遵循用户指令的能力。在85%±3%的情况下,标签师更喜欢InstructGPT而不是GPT-3的输出。
真实性:模型产生幻觉的倾向。当使用TruthfulQA数据集进行评估时,PPO模型产生的输出显示真实性和信息量略有增加。
无害性:模型避免不适当的、贬损的和诋毁性内容的能力。使用realtoxicityprompt数据集进行无害性测试。试验在三种条件下进行:
- 指示提供尊重的反应:导致毒性反应显著降低。
- 指示提供反应,没有任何设置为尊重:没有显著变化的毒性。
- 指示提供毒性反应:反应实际上明显比GPT-3模型毒性更大。
有关创建ChatGPT和InstructGPT所使用的方法的更多信息,请阅读OpenAI Training语言模型发布的原始论文,以遵循人类反馈的说明022 https://arxiv.org/pdf/2203.02155.pdf
参考链接:https://towardsdatascience.com/how-chatgpt-works-the-models-behind-the-bot-1ce5fca96286
