随着量子计算的最新进展,利用量子特性实现加速计算的更多应用已经出现。量子机器学习就是这样一个正在发展的理论领域。在本文中,我们将讨论一些有用的算法,这些算法可以显著加快监督学习和无监督学习的速度。
首先,我们需要了解为什么量子计算比其他经典方法更具优势。由于量子比特是量子计算的基本单位,它们根据量子物理学原理相互作用,因此量子纠缠和量子叠加等特性使这些系统能够更快地处理复杂数据。例如,Shor算法可用于在多项式时间内分解数字,而不是在指数时间内运行的经典方法。
此外,将量子比特表示为状态向量(其中它们可以处于叠加状态-即状态的线性组合)还允许更多的数学应用。就机器学习而言,线性代数有效地充当了大多数算法的基础,这与量子希尔伯特空间密切相关。希尔伯特空间类似于普通向量空间,除了它们支持内积运算(对量子计算至关重要)。
使用经典计算,在多维空间中处理大量向量的线性代数问题可能需要多项式时间甚至更长的时间。然而,量子计算方法大大降低了运行时间成本,因为计算可以在线性时间内发生,而不是通过经典计算方法的多项式时间。Harrow、Hassidim 和 Lloyd (HHL) 算法就是这样一个应用示例。在这里,该算法使用量子相位估计作为子程序,以指数级速度估计函数(求解线性方程组)。
监督学习
在机器学习领域,监督学习是三种最常见的机器学习算法之一。监督学习需要使用数据和标签来模拟输入输出对之间的相关性。因此,监督学习最常见的两个应用是分类和回归。分类模型使用训练数据来学习期望的输出,并将该函数应用于新的测试数据(将输入映射到预测的标签),回归模型可以预测连续的结果。
在尝试执行监督学习任务时,通常需要多层神经网络。这些神经网络包含代表建模对象的权重和步骤的数字。通常,神经网络的层可以简单地以矩阵的形式表示。这给了我们一个很好的指示,表明在用量子计算训练监督学习模型时,我们可能可以代替经典计算来加速这个过程。训练监督学习模型的过程相对容易。首先,我们需要大量的分类数据,我们将使用这些数据来训练模型。然后,我们需要将所有训练数据放入创建神经网络层的算法中。使用这些神经网络,程序可以预测不同于训练集的另一个数据点的值。
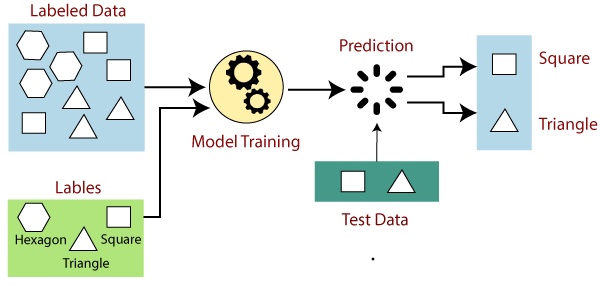
图 1:监督学习如何工作的演示
您可能已经注意到,如果我们有大量训练数据,这样的训练算法将需要很长时间来计算。通常,模型是通过许多矩阵运算和数据的非线性变换来训练的。根据我们训练模型的方式,完成训练可能需要指数时间。因此,量子计算可能是我们加快整个过程的一种非常有用的方法。
量子计算的监督学习
如前所述,监督学习需要大量的矩阵运算和非线性变换。为了在量子计算中实施监督学习,我们需要将非线性数据映射到量子态。量子核函数的使用实现了这一点。
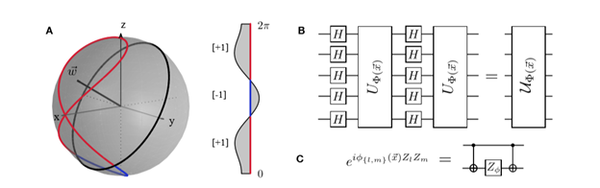
图 2:量子核函数图
在图 2-A 中,布洛赫球体表示单个状态量子位的特征图。让我们假设我们在经典世界中有二进制数据,可以用 0 到 2π 的区间表示。我们可以使用图 2-B 中描述的门非线性地沿着球体上的红线和蓝线映射此类数据。图 2-B 表示一种抽象方式,我们可以在其中以量子电路的形式非线性转换数据。通常,当我们创建不同的机器学习模型时,我们用于非线性转换训练数据的方程式也会发生变化以匹配训练过程。当我们执行学习过程时,我们的机器最终将达到训练集的最佳方程。
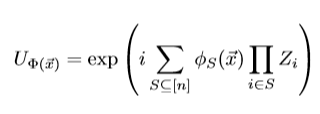
方程式 1:非线性变换的一般方程式,其中 φs(x) 是常数,Z 是 Pauli-Z 函数
将经典数据转换为量子态后,我们可以使用分类器来训练模型。一种可能的量子分类器是量子变分分类。要使用量子变分分类,有四个主要步骤:
1.我们需要将经典数据映射到量子态(如上所述)。
2.我们需要将量子电路应用于给定状态(见图 3)。该电路为 l 层电路,由变量 ϴ 参数化。稍后当我们进行实际训练时,我们将优化 ϴ 使其与我们的训练数据相匹配。
3.如果我们的数据是一个二分类问题,我们需要对我们的状态应用二进制测量,以便我们可以计算我们的正确概率。
4.最后,我们对输出状态重复我们的过程多次,以便我们可以获得分布模型和 ϴ 的优化。
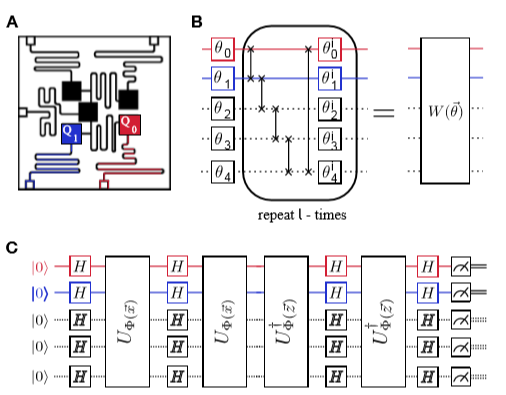
图 3:量子变分分类电路(如步骤 2 中所述)
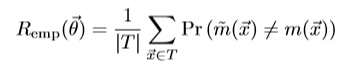
等式 2:上面是我们试图优化的 ϴ
为了实现量子变分分类,我们可以计算多维问题。对于经典计算机来说,最常见的缺点之一是在大于3的维度上操作时效率低下。然而,通过量子变分分类,我们甚至可以在超平面中轻松地进行计算。因此,通过实现机器学习的量子变分分类,可以减少运行时间和计算成本。
无监督学习
无监督学习是三种最常见的机器学习算法中的另一种,它允许从一组未标记的数据中学习模式。当您不确定要查找的内容时,这对于确定数据模式非常有用,这种情况经常发生,因为很多在线数据都没有标记。由于黑客攻击网络的方法不断变化,因此对未标记数据进行有效分类对于网络安全极为重要。通过使用无监督学习,任何在已知/常规活动之外分组的活动都可以标记为有害或可疑,并且网络可以阻止它。
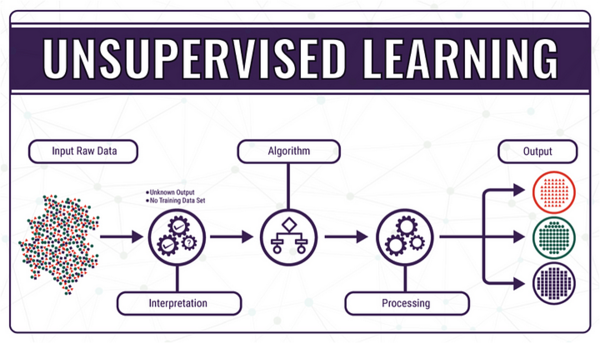
图 4:无监督学习如何工作的可视化示例
一种非常常用的无监督机器学习算法是k均值聚类算法,它将n个点的数据集分为k 个不同的组,其中每个数据点属于一个单独的集群。标准算法的工作原理是在两个主要步骤之间交替进行:分配步骤和更新步骤。首先,通常通过选择k来初始化算法随机点并将它们用作初始方法。然后将每个观察值分配给在分配步骤中具有最接近均值的集群。在更新步骤中,每个集群的中心根据作为集群成员的当前点重新分配。由于该算法的运行时间与数据点的数量、要聚类的数据点的维数、聚类的数量和迭代次数成比例,其最坏情况的时间复杂度是超多项式的(不受多项式限制)。然而,随着数据集变得越来越大,对更快替代方案的需求预计会增加。
量子计算的无监督学习
由于量子计算内置的同时执行任务的能力,量子计算本身是一种为无监督机器学习提供加速的好方法。替代流行的k-均值算法的q-均值量子替代方案利用同步处理来实现显著的加速。对于q-均值算法,数据集中的所有向量都从量子叠加开始,同时计算到所有质心的距离。然后通过选择最接近的质心来同时标记所有向量。向量的标签也处于叠加状态。然后测量标记的量子位,并且根据量子力学定律随机返回一个经典标签。剩下的量子态只是与测量标签匹配的向量的叠加。接下来,通过使用量子矩阵乘法,获得描述新质心的量子态,并记录量子态的经典表示。最后,重复该过程,直到创建了 k 个质心。并行执行计算而不是顺序执行会导致运行速度更快,q-means算法每次迭代的运行时间为:
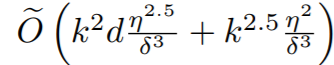
等式 3:q-means 算法的运行时间
对于容易聚类的数据集,k为质心数,d为特征数,nu为最大平方范数,delta为误差参数。总的来说,该算法在数据点的数量上是多对数的,这比经典算法的超多项式运行时间要快得多。然而,由于量子计算机仍处于早期阶段,我们还需要一段时间才能可靠地将量子算法用于无监督学习。
结论
正如我们所见,量子计算在机器学习中的应用在减少运行时间和计算成本方面提供了显着优势。在监督和无监督学习方面,利用这些状态的量子属性和数学开发,可以处理更大的数据集。
虽然这一切都非常令人兴奋,但量子机器学习仍然是一个相对较新的领域。随着越来越多的发现不断涌现,对量子算法和经典算法的改进也在不断发展。事实上,2018年,18岁的Ewin Tang发现,量子计算领域的一些方法实际上可以应用于经典算法,从而推翻了其他研究人员此前认为(并错过)的量子计算优势。尽管如此,量子计算和机器学习的交叉仍然被证明是一个非常独特和值得探索的领域。
