Jonathan Ross是下一代芯片的制造商——Groq公司的CEO和创始人,该公司专注于推理处理和加速具有实时人工智能(AI)和高性能计算(HPC)系统。
Ross之前就发明了驱动谷歌机器学习(ML)软件的张量处理单元(TPU)。他在2017年创立了Groq,随着AI发展对传统计算架构提出的计算挑战,他感觉到这是一个机会。
用传统设计解决AI推理只是权宜之计
AI训练使用训练数据集创建神经网络或ML算法,而AI推理是使用经过训练的神经网络模型进行预测的过程。
在这个过程中,是最佳的解决方案是不使用单独的处理器,无论是CPU、GPU、现场可编程门阵列(FPGA),还是张量处理单元(TPU)。因为,一种尺寸的箱子不适合所有人。
这并没有阻止人们的尝试,例如4,000核CPU、可重新配置的FPGAs或具有更强大内核或可独立编程内核的GPU。这些经过调整的现有设计带来了微小的改进,但依然无法满足ML对计算的渴望。
Groq决定做一些完全不同的事情——与传统的半导体行业智慧相反的创新。考虑到当今市场上的产品,Ross扩展了Groq的使命。“我们决定我们的使命是将计算成本降至零。虽然每个人都讨厌它,但是你看看计算的历史,就知道发生了什么。当我们说“将计算成本降至零”时,我们仍在将我们的解决方案作为具有竞争力的行业价位进行销售。但是,当我们提供数量级的性能提升时——200倍、600倍、1000倍——我们的性价比是200倍、600倍、1000倍。所以,它正在接近免费。”
AI推理遭遇瓶颈
使用现有架构并连接多个CPU解决了AI训练挑战。但AI推理要困难得多,因为它是实时的,对延迟敏感的,需要高性能和高效率。
随着时间的推移,CPU变得越来越大,越来越复杂,具有多核、多线程、片上网络和控制电路。承担加速软件性能和输出任务的开发人员必须处理复杂的编程模型、安全问题,以及由于处理抽象层而导致的编译器控制的不可见性。简而言之,标准计算架构具有无法提供推理性能优势的硬件特性和元素。
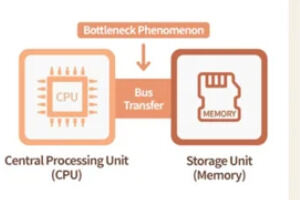
GPU架构专为DRAM带宽而设计,构建于多数据或多任务固定结构处理引擎之上。GPU执行大规模并行处理任务,但存在内存访问延迟,ML已经触及外部内存带宽的极限。
不太复杂的芯片设计
Groq设计了一种芯片,可在整个系统中提供可预测和可重复的性能,具有低延迟和高吞吐量,称为张量流处理器(TSP)。这些更简单的新处理架构专为机器学习应用和其他计算密集型工作负载的性能要求而设计。
在解释芯片设计方法时,Ross评论道,“这要从软件开始。今天制造的每一个芯片都是由硬件工程师制造的。这就像让汽车机械师设计汽车一样——一切都是为了优化引擎。在理想的情况下,你会让一个司机设计一辆车,让机械师帮忙制造。我是一名软件工程师,我们团队的许多成员都是软件工程师,所以我们作为芯片的用户从头开始构建GroqChip,而不是为构建芯片而优化的人。这导致了一个非常不同的架构,非常容易编程。”
这种软件定义的硬件方法是Groq与众不同的地方。在前六个月,编译器是团队的唯一焦点,只有在那之后,团队才开始着手芯片架构的工作。
结果是在软件中执行计划,用Groq编译器控制硬件操作,并将释放宝贵的硅空间用于更多的处理。这种架构提供的控制带来了可预测的性能以及更好、更快的模型部署。
“客户通常有一些代码,他们一直试图在GPU、FPGA或CPU上工作,但他们无法获得所需的性能。如果使用Groq,我们能够让它快速运行和执行,这就是Groq编译器的力量,”Ross分享道。
Groq也提供GroqWare套件,一系列旨在简化开发人员体验的工具。开发人员通常会开发、编译一个程序,并将其部署到硬件上,多次运行该程序并对其进行分析,然后返回进行优化和重新编译,这通常会进行多次。有了Groq,就不需要把它部署到硬件上。相反,开发者可以使用GroqView Profiler对计算和内存使用进行可视化,缩短开发周期。还有GroqFlow,只需添加一行代码,这个简单接口就能获得模型在GroqNode服务器上运行情况。
因为Groq Compiler协调了一切,数据在正确的时间和地点流入,确保计算立即发生,没有延迟。
编译器了解每条指令的速度,并准确地指示硬件何时做什么,编译器和GroqChip之间没有抽象。在传统架构中,将数据从DRAM移动到处理器需要耗费大量的时间和精力,而且对同一工作负载执行的处理是可变的。
Groq编译器控制流向硬件的指令,使处理变得快速和可预测,让开发人员可以在GroqChip上多次运行相同的模型,每次都能收到完全相同的结果。
Ross评论道,“当开发人员在GroqChip上编译时,我们共享精确的性能,每次运行都没有变化。”这种确定性性能对于越来越多的应用来说至关重要。
解决“批大小 1”的挑战
对于诸如自然语言处理应用中的实时响应,推理处理期间必须在单个图像上运行一个批量大小或多个计算。“批大小1”(batch size 1)为机器学习应用程序引入了性能和响应复杂性,尤其是基于GPU的传统推理平台。
Groq架构在批量为1时不会出现延迟。TSP中的单线程、单核架构可在任何批量下提供最佳性能。在大批量时,TSP比基于GPU的平台快近2.5倍,在批量为1时快17.6倍。
超级计算即服务
如今,在云中运行模型需要请求一段时间。由于大多数客户不知道运行这些模型需要多长时间,因此基于良好的猜测来购买时间块。
确定性性能将使超级计算即服务(Supercomputing-as-a-service)成为可能,因为Groq编译器可以确定完成建模任务所需的确切时间。未来潜力是通过提供精确计费所需时间的能力而不是冗余来颠覆市场,从而全面节省客户的总体拥有成本和资源。
有了这个远大的愿景,Ross分享道,“我总是说——不舒服也要舒服。恐惧是你在做重要事情的标志。”
原文链接:
https://www.forbes.com/sites/moorinsights/2022/11/10/groq--reimagining-high-performance-computing/