人工智能(AI)被视为“史上最重大的范式转变”,从自动驾驶汽车、AI助手到模仿人脑的神经形态半导体,AI早已超过了人类的智能和学习速度,现在正通过影响我们生活的许多方面,迅速应用于各个领域。
云计算与边缘计算
一个与云服务截然相反的AI应用是边缘计算。需要处理大量输入数据的应用必须使用边缘计算来处理数据,或者通过有线或无线通信(最好是通过减少数据量)将数据传输到云。为此专门为边缘计算设计的加速器占据了AI芯片设计的很大一部分。自动驾驶中使用的AI芯片就是一个很好的例子。这些芯片通过使用CNN2和一系列神经操作处理包含大量数据的图像来执行图像分类和对象检测。
AI与隐私问题
AI应用的另一个领域是像亚马逊的Alexa或SK电讯的NUGU这样的对话服务。然而,如果不保护隐私,这种服务就不能广泛使用。对话式AI服务正在进行许多努力来解决这些隐私问题。
解决隐私问题的最新研究趋势是同态加密3。同态加密不会按原样传输用户的语音或其他敏感信息,如医疗数据。这是一种加密形式,允许对密文形式的加密数据进行乘法和加法计算,只有用户可以在云服务上解密,而无需首先解密。结果以加密的形式再次发送给用户,只有用户可以解密以查看结果。因此,除了个人用户之外,包括服务器在内的任何人都不能看到原始数据。同态服务需要比普通明文dnn 4服务多几千或几万倍的巨大计算量。未来研究的关键领域是通过专门设计的同态加速器显著提高计算性能,从而减少服务时间。
AI芯片和存储器
在大规模DNN中,权重的数量太多,无法将它们全部包含在一个处理器中。因此,每当需要存储外部大容量DRAM中的权重时,必须进行读取访问,并将其带给处理器。如果权重只使用一次,并且在访问后不能重用,那么耗费大量精力和时间提取的数据将会浪费。这是一种非常低效的方法,因为与在处理器中存储和利用所有权重相比,它消耗了额外的时间和能量。在这种结构中,处理器之间的高速连接是必不可少的,这比让所有处理器通过一条路径访问更有效。
AI芯片互联
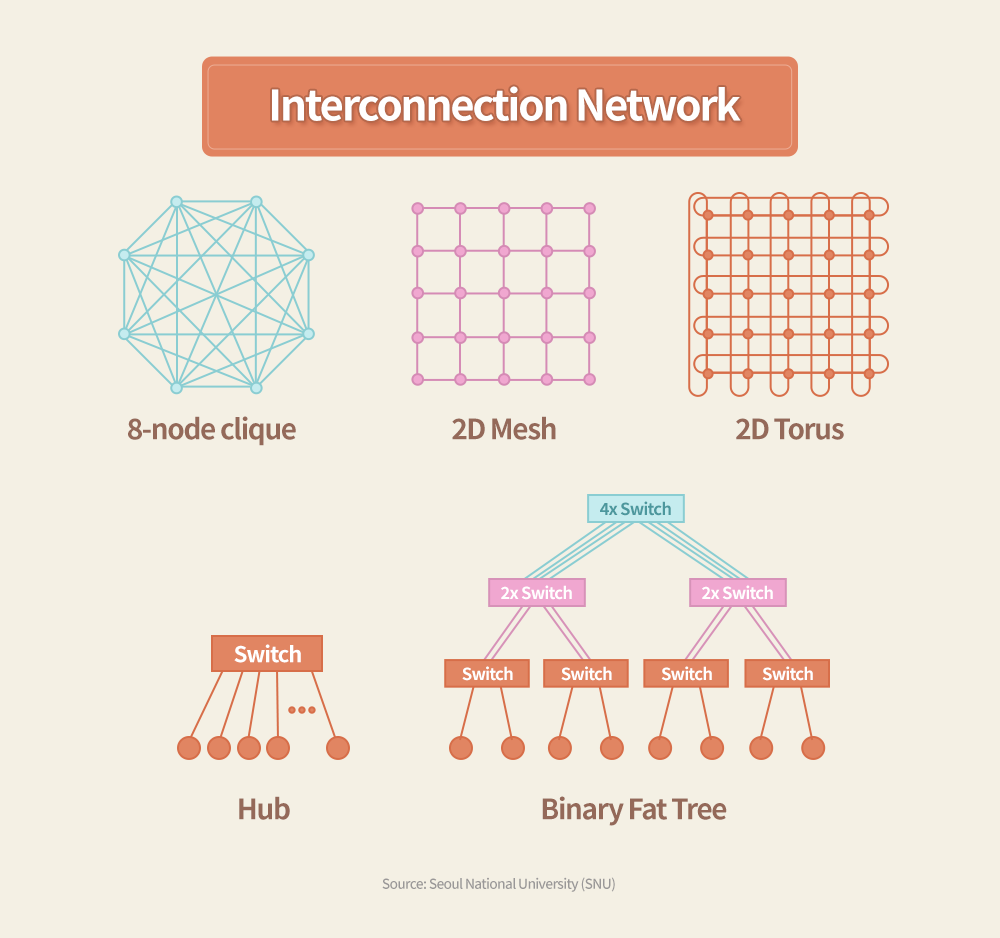
AI芯片互连网络
连接多个处理器时出现的性能瓶颈取决于所提供的带宽、延迟以及互连形式。这些元素定义了DNN的大小和性能。换句话说,如果要通过并行连接“N”个加速器来提供“N倍”的高性能,则在互连所提供的延迟和带宽中会出现瓶颈,并且将无法提供所期望的性能。
因此,一个处理器和另一个处理器之间的互连结构对于有效地提供性能的可伸缩性是至关重要的。在NVIDIA A100 GPU情况下,NVLink 3.0扮演了这个角色。该GPU中有12个NVLink通道,每个通道提供50 GBps带宽。将4个GPU连接在一起可以通过使用4个通道以团的形式直接连接完成。但是要连接16个GPU,就需要一个NVSwitch,这是一个专门用于互联的外部芯片。在谷歌TPU v2情况下,它被设计成使用具有496GBps的总带宽的核心间互连(ICI)来实现2D环形结构的连接。
处理器互连方式对整个系统有着巨大影响。例如,如果它们以网状或环面结构互连,由于芯片之间的物理连接简单,该结构易于构成。但是延迟随着距离成比例地增加,因为它需要在几个处理器之间跳跃,在远离的节点之间互连。最极端的方法是以小团的形式,将所有处理器一对一地互连,但这将导致芯片引脚数显著增加N!,导致PCB拥塞超出允许范围,因此在实际设计中,最多只能连接四个处理器。
通常,使用类似NVSwitch纵横制交换机是另一个有吸引力的选择,但这种方法也会将所有连接聚合到交换机上。因此,要互连的处理器数量越多,PCB布局就越困难,因为传输线会集中在开关周围。最好的方法是将整个网络构建成二叉树,在底端连接处理器,并将最大的带宽分配给二叉树的顶端。因此,创建一个二叉胖树将是最理想的,并且能够提供最大的性能和可伸缩性。
神经形态AI芯片
最近,对神经形态AI芯片的研究有所增加,与以前的模拟方法不同,该芯片直接模拟活生物体的神经网络及其信号,并映射到模拟电子电路,并以相同的方式执行。这种方法在实际应用中以模拟的形式表示原始数据。这意味着一个节点代表一个信号,互连是通过硬连线实现的,不是由软件定义的,而权重是以模拟形式存储的。
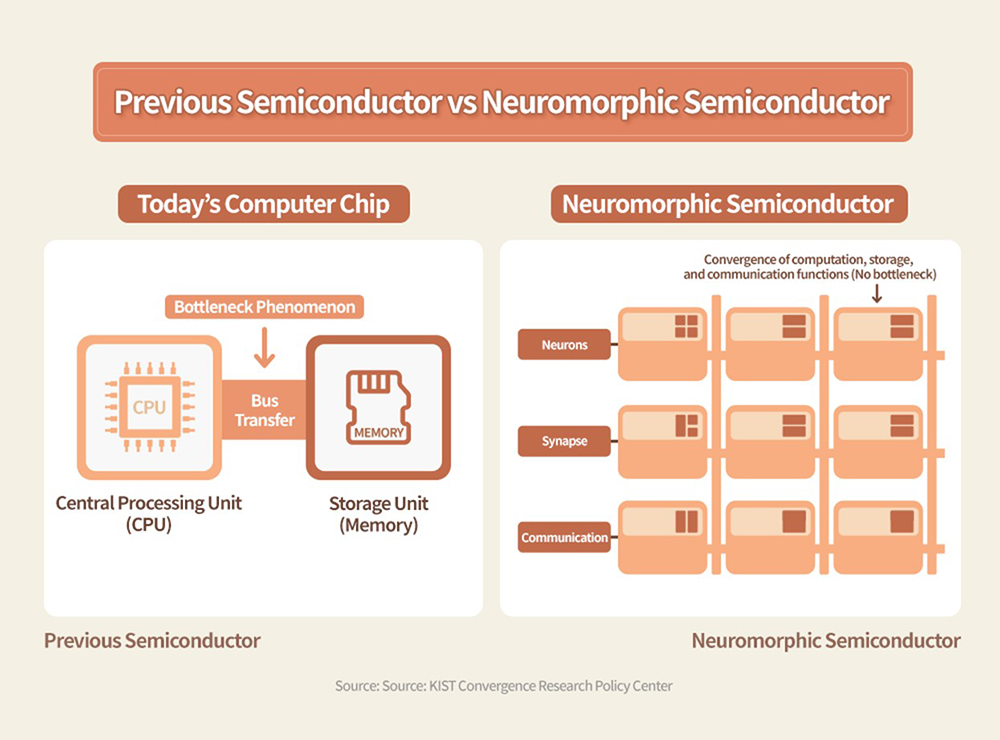
以前的半导体与神经形态半导体
这种结构的优点是最大并行性,以最小的能量执行,并且神经形态芯片可以在某些应用中获得很大优势。因为该结构是固定的,缺乏可编程性。事实上,神经形态处理器在一些应用中具有重要意义,例如通过提供高能效来处理物联网中传感器的AI信号,或者需要使用固定权重的CNN处理大量视频数据的图像分类。
然而,因为权重是固定的,很难在需要持续学习的应用领域使用。此外,当涉及大规模计算时,由于结构限制,很难利用将几个芯片并行互连的并行性,使其实际应用领域局限于边缘计算。也可以用数字形式实现神经形态结构,IBM的TrueNorth就是一个例子。然而,众所周知,可扩展性是有限的,这使得很难找到广泛的实际应用。
AI芯片发展现状
为了创造一个可以与人类对话的智能数字助理,需要处理大量用户数据的Meta(原名脸书)正在设计一个专门拥有世界基本知识的AI芯片。该公司还在内部开发AI芯片,这些芯片将进行审核,以决定是否发布上传到脸书的实时视频。
亚马逊是一家主要专注于电子商务和云计算的科技公司,它已经开发了自己的AI加速器,名为AWS推理加速器,为其数字助理Alexa提供动力,并使用它来识别音频信号。云服务提供商AWS开发了一种使用Inferentia芯片的基础设施,并为云服务用户提供服务,可以加速深度学习工作负载,如谷歌的TPU。
另一方面,微软在其数据中心使用现场可编程门阵列(FPGA),并引入了一种根据应用算法重新配置精度和DNN结构来确保最佳性能的方法,以便创建不仅在当前应用中,而且在未来应用中优化的AI芯片。然而,这种方法产生了大量的重新配置结构和逻辑电路开销,即使已经确定了最佳结构。因此,不清楚它是否会有实际好处,因为与专门为某些目的设计的ASIC芯片相比,它在能源和性能方面不可避免地处于不利地位。
许多无厂创业公司正在通过开发通用可编程加速器来与英伟达竞争,这些加速器不是专门针对某些应用领域的。包括Cerebras Systems、Graphcore和Groq在内的许多公司都加入了激烈的竞争。在韩国,SK电讯与SK海力士合作开发了SAPEON,并将很快用作数据中心的AI芯片。Furiosa AI也准备将其硅芯片Warboy商业化。
编译器的重要性
这种AI硬件的性能在很大程度上取决于软件的优化程度。通过脉动阵列同时操作数千或数万个计算电路并有效地收集结果需要高度先进的协调。只有通过专门的库才能设置输入数据的顺序,以馈入AI芯片中的众多计算电路,并使它们以锁定的步伐连续工作,然后将输出传输到下一阶段。这意味着开发一个高效的库和使用它们的编译器与设计硬件一样重要。
NVIDIA GPU一开始是一个图形引擎。但是NVIDIA提供了一个开发环境CUDA,使用户能够轻松地编写程序,并使他们能够在GPU上高效地运行,这使得它在整个AI社区中得到广泛和普遍的使用。谷歌还提供了自己的开发环境TensorFlow,帮助使用TPUs开发软件。因此,它支持用户轻松利用TPU。未来必须提供越来越多样化的开发环境,这将增加AI芯片的适用性。
AI半导体的未来
未来AI服务的方向必须完全集中在提高服务质量和降低所需的能耗上。因此,预计工作将集中在降低AI芯片的功耗和加速开发节能DNN结构上。
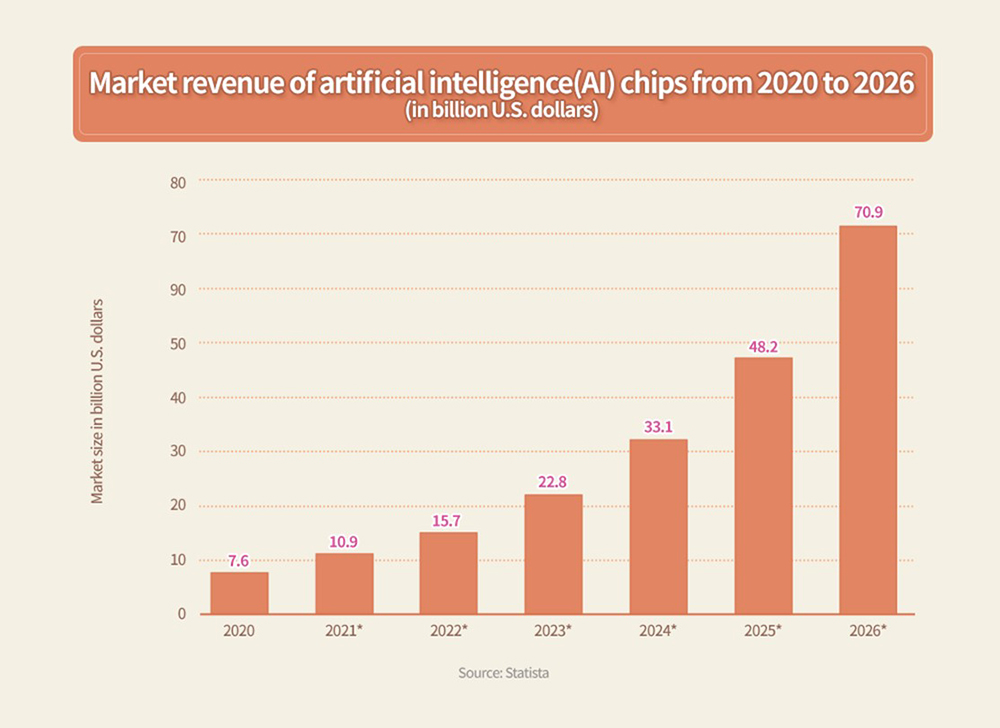
AI芯片市场展望
在AI领域取得的成功将扩大应用范围,引发惊人的市场增长。应用系统将进一步推动更广泛的AI市场,并不断创造新的领域,实现基于神经网络结构的推理质量支持的差异化服务质量。
AI半导体是AI系统的支柱,将根据它们使用低能量进行推理和训练任务的速度和精度来区分,但最新研究表明能效非常差。因此,越来越需要研究新的神经网络结构,不仅关注功能,还关注能效。
就硬件而言,定义能效的核心要素在于改进内存访问方法。因此,在内存中处理(PIM)和神经形态计算将成为重要的研究领域,前者在内存中处理,而不是单独访问内存,后者通过在模拟内存中存储突触权重来模拟神经网络。
原文链接:
https://news.skhynix.com/various-applications-of-ai-technology/
