HBM3为实现内存和处理器之间显著加快的数据移动打开了大门,降低了发送和接收信号所需的功耗,并提高了需要高数据吞吐量的系统的性能。但是使用这种内存既昂贵又复杂,而且短期内可能会继续如此。
高带宽存储器(HBM3)是由JEDEC开发的HBM规范的最新补充,用于在单个模块内堆叠DRAM层。它于2022年1月推出,被视为2.5D封装的一项重大改进。但是HBM3仍然很昂贵,部分是因为存储器本身的价格,部分是因为其他组件的成本,例如硅插入物和开发2.5D设计所需的工程。这限制了它在高容量设计或对价格不敏感的应用(如数据中心的服务器)中的使用,在这些应用中,由于数据通道更多、更宽,以及在处理元件和DRAM之间来回驱动信号所需的功率更低,内存的成本可以通过提高性能来抵消。
这有助于解释为什么HBM3首先出现在NVIDIA的“Hopper”H100企业GPU中,英特尔和AMD的产品紧随其后。与HBM2E相比,HBM3提供了几项增强功能,最显著的是带宽从HBM2E的3.6Gbps增加到了HBM3的6.4Gbps,即每个设备的带宽达819GBps。
“带宽是支持更大计算引擎所需要的,”AMD客户PC业务高级副总裁兼首席技术官Joe Macri说。“如果你看看我们正在解决的许多问题,它们都非常占用带宽,无论是机器学习还是HPC类型的解决方案。因此,即使我们只适度增加引擎大小,仍然会从带宽增加中受益匪浅。”
除了提高容量和速度,能效方面的改进也值得注意。HBM3的核心电压为1.1V,而HBM2E的核心电压为1.2V。HBM3还将I/O信号降至400mV,而HBM2E为1.2V。在未来几代中也会有进一步的改进。
三星半导体(Samsung Semiconductor)负责内存产品的执行副总裁Jim Elliot在最近的一次演讲中表示,“一旦进入10纳米时代,你就必须考虑不同的缩小尺寸技术,例如高K金属栅极等技术,我们必须不断增加内存带宽。“对于低电阻材料,我们必须突破DRAM元件单元尺寸的极限。对于宽带隙材料,我们正在寻求10倍的漏电改善,以及用于DRAM的FinFETs,这将允许我们继续将功率扩展到0.9V以上。”
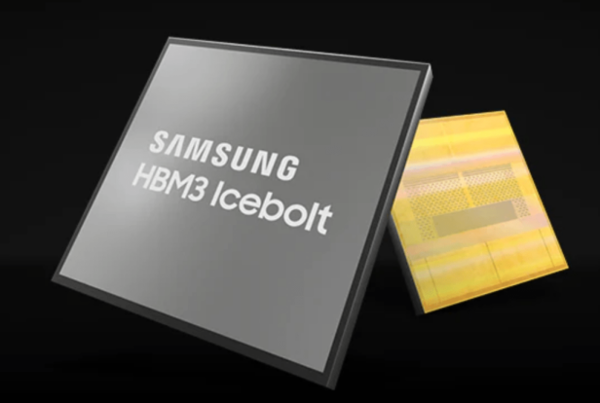
图1:三星新款HBM3。(来源:三星)
然而,这一切都不容易。这项技术的制造和充分利用都将面临巨大的挑战。与过去不同,当时一个先进的架构可以用于数十亿个单元,许多这些设计都是定制的。例如,在AI领域,几乎每个人都在构建自己的定制AI训练芯片,并专注于HBM。它有两种用途——要么作为系统中唯一的内存,要么与DRAM一起使用。
富士通基于Arm的A64fx就是前者的一个例子。用于Fugaku的A64fx一度是世界上最快的超级计算机,在CPU旁边的芯片上有32GB的HBM2,但没有其他系统内存。其他产品,如AMD Instinct,Nvidia的H100 GPU,以及英特尔的CPU Max和GPU Max,都配有标准DRAM的HBM,其中HBM就像DRAM的大规模缓存。
头号敌人:发热
使用HBM的最大挑战是热量。众所周知,内存和热量不能共存,但HBM3将与世界上最热门的芯片和系统一起使用。例如,Nvidia的H100有700瓦的热设计功率(TDP)限制;橡树岭国家实验室的超级计算机Epyc CPUs和Instinct GPUs(使用HBM2E)的混合——需要AMD进行一些创造性的负载平衡,以将温度保持在限制范围内。
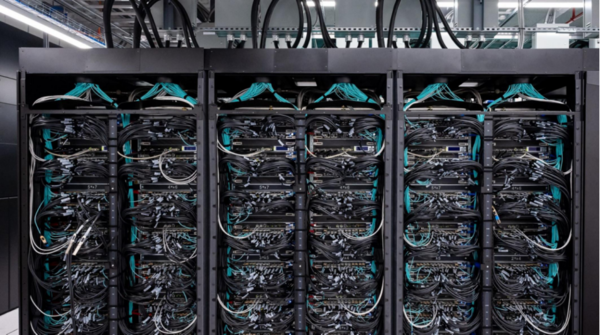
图2:前沿超级计算机。(来源:橡树岭国家实验室)
Frontier上的一些工作负载是内存密集型的,一些是CPU密集型的,平衡工作负载以避免过热是在芯片中完成,而不是软件中。Macri说,“有些微处理器的全部工作就是管理这些控制回路,使系统保持在最佳状态。”
Frontier由HPE的Cray部门与AMD合作构建,管理热量的负载平衡是在系统设计级别处理的。“我们共同设计了这个解决方案,”他说,“根据正在完成的工作,我们可以对它进行动态操作,以获得最佳性能。”
Rambus产品管理高级主管Frank Ferro说,HBM和控制器中都有硬件功能,允许调节内存,将其置于不同的性能状态,甚至转换到更低的频率。“如果它开始成为一个热点,而你想降低频率或功耗,并将内存置于空闲模式,这些基本上都是在IP层和DRAM层。DRAM层已经具备了这种能力,但如何使用它取决于系统架构师。”
密度极限
HBM3面临的第二个热挑战来自存储器本身。与HBM2E的12层限制相比,HBM3标准允许多达16层。但Macri认为,由于高温,它将停在12层。尽管如此,对于定制设计来说,这可能会因供应商和用例的不同而不同。
堆叠中底部的DRAM具有最高热阻,这是堆叠的主要限制因素。HBM使用微凸块来连接不同的DRAM芯片,微凸块有缺点。由于内存会产生热量,热量可以在每一层累积,而微凸点不能有效地将热量传递出去。这反过来限制了DRAM的实际层数。因此,即使HBM3可以支持16层,在大多数情况下也只会使用更少的层。
DRAM的每一层都需要自己的功率传输,这足以获得足够的性能。推动电力输送会增加每一层的热量。
2.5D设计
HBM内插器保持在2.5D也不是因为热挑战。2.5D设计是内存位于处理器旁边的原因。在真正的3D设计中,内存将位于CPU/GPU之上,并直接与芯片通信。CPU最高300瓦,GPU达到700瓦,热量太多了。
“挑战在于,如果你产生大量热量,你会踩在微凸起上,这些微凸起并不能很好地将热量转移出去。这就是为什么几乎每个人都做了2.5D,因为微点技术真的限制了你可以放入它下面的芯片的功率量,”Macri说。
其中一些将会改变整个3D-IC的实现。“如果真是3D,这个物理层会变得不那么复杂,所以有很多优势,”Ferro说。“你把转接板去掉,芯片之间的物理接口变得不那么复杂,因为你不需要通过另一种媒介来连接。所以有很多优势,但也有很多挑战。”
例如,使用现有技术冷却3D-IC是困难的,因为位于芯片顶部的存储器实际上隔离了其下方ASIC或GPU。在平面SoC中,热量由硅本身散发。但在3D-IC中,需要使用更复杂的方法,部分原因是热量可能会被困在层间,部分原因是这些设备中使用的薄芯片无法散热。
“在您将内存芯片堆叠放在GPU顶部的那一刻,GPU热量需要在散发之前或撞击冷板之前通过内存。所以你现在突然面临一个不同的挑战,”美光科技公司HPM产品管理高级主管Girish Cherussery说。“我不认为我会看到将现有的HBM直接堆叠在消耗400,500瓦功率的GPU或ASIC上的东西。但是未来会发生吗?这是一个可以开花结果的解决方案。”
沉浸式芯片冷却
这是如何保持这些数据中心冷却和节能的更大问题和挑战的一部分,散热解决方案是保持环境可持续发展的瓶颈之一。
Cherussery指出,沉浸式冷却似乎是行业正在寻找的解决方案之一,因为它不像空气和液体冷却那样使用冷板。它包括将带有CPU和内存的主板浸入不导电的绝缘液体(通常是矿物油)中,只有网卡、USB和其他端口伸出液体。
这在数据中心尤其重要,因为服务器的冷却机架每年要花费数百万美元。美国数据中心的平均能源使用效率(PUE)评级约为1.5。分数越低,数据中心效率越高,但不能低于1.0。高于1.0的每个点都是用于冷却数据中心的电力,因此在PUE为1.5时,数据中心在冷却上花费的电力是总电力的一半。
沉浸式效率极高。香港数据中心的PUE评级为1.01。液冷数据中心已经降至1.1的范围,但1.01是闻所未闻的。该数据中心仅将1%的电力用于冷却。
浸没冷却长期以来一直处于冷却技术的边缘,只在极端情况下使用,但它正在慢慢成为主流。香港数据中心的支持公司LiquidStack已经获得了一些风险投资,微软已经记录了其在一个数据中心使用LiquidStack产品的实验。微软获得了能源使用效率,但它发现可以在不损坏芯片的情况下超频。因此,未来HBM真正的3D叠加路径很有可能是通过一个装满矿物油的油箱。
供应商之间的差异
Macri指出,DRAM厂商正在相互竞争,就像SoC厂商一样,这意味着一些HBM的功耗较低,一些则较高。“到处都有激烈的竞争。这很重要,因为它推动了创新,”他说。
这种回旋余地也可能导致问题。他说,在规定权力方面没有标准。每个DRAM制造商都在想出设计存储器的最佳方法,以实现最佳的最终结果,功率和价格是关键变量。
“较好的东西比不太好的东西价格更高,这也很重要,因为根据公司和他们使用目的,有不同的系统目标,”Macri说。
然而,DRAM本身符合JEDEC标准。从理论上讲,你可以从一个供应商那里得到一个DRAM,然后用另一个替换它,这就限制了这种差异。
“我们的工作有很多重叠和相似之处吗?”Ferro说。“它们完全一样吗?也许有一点不同,但不是本质上的不同。你必须与每个供应商一起完成这个过程,因为可能会有一点点变化。”
自HBM2E以来,可测试性和RAS(可靠性、可用性、可伸缩性)能力得到了显著提高。HBM3还处理DRAM内片上ECC的需求,以使DRAM非常可靠。“这非常重要,因为产生的任何错误都需要你返回或修复,这增加了延迟,”他说。
其他挑战
因为HBM暂时是2.5D,这增加了内存的大小限制。SoC的大小,加上HBM芯片的数量,增加了更大的冷却面积。
“这是我们面临的另一个挑战,”Ferro说。“你不能变得更大,因为东西会从包装上掉下来。所以我们必须非常注意确保我们的长宽比是正确的,并且我们不会超过这些大小限制中的任何一个。”
在使用HBM的时候,你要利用它最大的属性,就是带宽。但是设计利用这种带宽并不容易。“你想要非常密集的浮点单元,这是具有挑战性的,”Macri说。“DRAM不爱随机存取。因此,您需要设计一个对HBM非常友好的参考焊盘。你从中获取最大的效率,这非常困难。”
结论
HBM3对HBM2E标准进行了多项改进。有些是意料之中的(带宽提升),有些是意料之外的(RAS改进、更新的时钟方法)。总的来说,新标准为用户提供了针对下一代SOC的HBM存储器的重大改进。但到目前为止,至少,它不是一个即插即用的解决方案。
原文链接:
https://semiengineering.com/improving-performance-and-power-with-hbm3/
