众所周知,摩尔定律即将终结。随着越来越多的晶体管被集成到每个硅片上,我们不能再指望处理器的能力每两年翻一番。
这对传统IT来说很不利,因为传统IT一直享受着摩尔定律带来的持续红利。对于人工智能(AI)来说,这可能是一场灾难,AI正处于大扩张前沿……但这种扩张非常依赖于快速处理。
一家初创公司认为,答案是将传统硅与光控光子处理器结合起来。
AI爆炸
Lightmatter首席执行官尼克·哈里斯(Nick Harris)表示,AI目前正处于高速增长阶段,“人们已经发现了永不满足的用例。谷歌、微软、亚马逊和脸书会为AI付出任何代价。”
在20世纪60年代和80年代的热潮之后,AI研究进展缓慢。2012年,由Alex Krizhevsky创建的一个名为AlexNet的神经网络赢得了在低成本GPU硬件上运行图像识别的竞赛。
这显示了商业上的可能性,谷歌收购了Krizhevsky公司,投资从此开始了。
Harris说,“扩展这些东西时投入了大量资金。过去十年里,AI模型复杂性经历了3.6个月的倍增期。”
问题是,即使廉价的通用硅也赶不上这个速度。此外,尽管实验室对AI投入额外时间和资源是可能的,但当它部署到真实的应用中时,就需要快速的性能。
“AI挑战在于,你可以训练非常大的模型,但如果你想部署它们并让人们与它们互动,用户进行查询和获得结果之间的时间非常重要,”Harris说。“你需要实时反馈。该领域最大挑战是建造能够运行这些巨大神经网络的机器,这样你就可以在几毫秒内得到答案。”
硅落伍了
自1965年,英特尔公司的戈登·摩尔(Gordon Moore)注意到这一趋势以来,处理器性能几十年来每两年翻一番。
Harris说,这很好,但这种进展速度不足以跟上本世纪出现的AI,“即使你有电子产品的最佳案例,你也没有真正推动这一点。”更糟糕的是,就在更聪明的AI到来时,硅加速的速度变慢了。
摩尔定律之所以成立,是因为芯片制造商可以每两年将一块硅片上的晶体管数量增加一倍,现在,虽然处理器仍在封装更多的晶体管,但它们的运行温度却更高了。
“发热问题的原因是丹纳德缩放(Dennard Scaling),”Harris解释说。Dennard发明了DRAM,并观察到较小的晶体管消耗较少的能量,并随着面积增加而增加,但大约到2005年,这种情况发生了变化。
今天的快速处理器使用300W或更高功率,并向1kW芯片方向发展。
“我们仍在获得更多的单位面积晶体管。但是你不能真的使用它们,因为散热方案不支持你使用。芯片会烧毁,你需要能够开发每瓦特执行更多操作的芯片。”
引入光子技术
让芯片变热的是电阻。当电子在电流中流动时,电信号会遇到阻力。相比之下,光信号不会面临同样的阻力,也不会产生热量,而且光子的传播速度也比其他任何东西都快。
几年来,先进计算机设计试图引入光子学,用HPE科学家John Sontag的话说,就是“电子用于处理,光子用于通信”。
长距离通信使用光纤,这些光纤现在已经深入到数据中心的机架中。“有些公司销售100可插拔光纤,而他们刚刚部署了400可插拔光纤。他们通过光纤发送每秒400千兆比特的数据,将空间上分离的机架和东西连接在一起。”
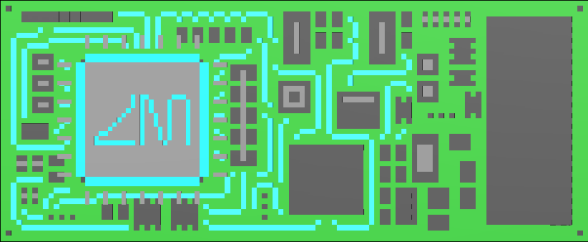
最近已经允许晶体管和光子在同一个晶片上融合,形成“共同封装光学”。
最近的发展已经允许晶体管和光子在同一个晶片上融合,这就是所谓的“共同封装光学”。最初,这被视为一种减少光学插头的尺寸和功耗的方法,将信号作为光引入芯片,而不是在CMOS芯片的边界将光信号转换为电信号。
根据路线图,“光学组件越来越接近硅,直到最终,光学组件与处理器和网络芯片进行3D堆叠和共同封装,以低能耗提供非常高的数据速率。”
英特尔已经展示了共同封装光学器件,Broadcom展示了共同封装光学开关,Marvell在2021年以100亿美元收购了光子公司Inphi,但业界对它能否迅速发挥作用持怀疑态度。
Dell'Oro Group分析师Sameh Boujelbene在对SDxCentral的一次评论中表示,“要在未来几年内推出可用于大规模部署和批量生产的联合封装光学解决方案还为时过早。”
Harris评论说,共同封装的光学器件可能有助于制造用于训练AI的高度互联的GPU系统,但这仍然需要具有大量交错光纤的计算集群。“他们计划使用光学器件将服务器内部的处理器连接在一起。当每个芯片都使用光纤连接到其他芯片时,性能会有所提高,但很难维护这些东西。”
Lightmatter的方法是将光学元件进一步推入芯片内部,因此所有这些互连都由硅中的可切换光子网络处理,这种网络不会产生热量,并且占用极小的体积。
“这些光纤是肉眼可见的,大约1毫米,”他说。“我们的器件只有两微米。”
这可能会大大减少所需的硬件,有效地将复杂的AI训练系统集成到单个芯片上,“如果你打开我们的服务器,那里有一个芯片,包含了用于服务器的所有处理器。它们在芯片内部是光学互连的,也可以通过光学与其他平台通信。”
他继续说道,“最终,这个东西所做的是极端集成,通过光学互连实现一切,并允许真正荒谬的带宽。”这是在商业硅晶圆厂提供的标准流程中完成的,“我们与GlobalFoundries一起制造晶圆,”Harris说。“我们的晶体管是非常接近的邻居,距离光子元件不到100纳米,它们是一个整体。”
他说,用同样的蚀刻工具制造CMOS和光子连接,光子与晶体管具有相同的纳米尺度。
“我们使用所有相同的蚀刻工具,采用完全标准的CMOS。我们使用‘绝缘体上硅晶片’,这种晶片用于许多电子芯片的生产。”
Harris和他的同事在麻省理工学院开发了这个想法,并从2018年开始将其商业化,获得了1100万美元的启动资金。
在硅中融合光
该公司有两种产品。Passage是一种互连,它采用传统处理器阵列,并使用可编程片上光网络将它们连接起来。
“激光器与调制器和晶体管一起被集成到平台中,”他说。“如果用扫描电子显微镜观察这个东西,你可以看到波导——它们的间距约为2微米,宽度约为100纳米。”
另一个产品是Envise,一个通用云推理加速器,它将计算元素与光子计算核心结合在一起。
这是为了解决AI处理速度的问题,“我们的延迟提高了大约42倍,因为处理是以光速进行的。当光线穿过芯片时,你在做乘法和加法。”
如果用扫描电子显微镜观察,可以看到引入光的CMOS芯片平台种的波导。
这项技术仍处于早期阶段,但Lightmatter已经有“大约五个客户”,他们都是大型企业。“在Passage案例中,我们正在研究芯片之间的通信,而在Envise方面,光学处理核心有助于发挥通信力量,也可以分担计算机操作负载,”Harris说。
Harris说,这些产品是“大芯片”。就像另一家AI芯片初创公司Cerebras一样,Lightmatter发现,集成多个内核和一个网络可以在单个晶片上完成。
Cerebras在商业上更先进,爱丁堡大学的EPCC超级计算中心和生物制药公司艾伯维等都采用了它的产品。然而,它不得不创建自己的液体冷却系统来处理芯片网络中产生的热量。
Lightmatter的光学网络用光子发送信号,运行温度更低。它外形也小了一些,但仍然是“英寸尺度”,Passage要安装在一个8x8英寸的芯片插座上,“这是我一生中见过的最大的芯片插座。”
然而,它确实提供了“荒谬的”带宽——768Tbps。
晶圆大小的芯片听起来像是一种负担,因为所有的硅晶片都会有少许“点缺陷”,大晶片有更高的失败几率。“我们在良率工程方面做了很多工作,”Harris说。"但是芯片上没有很多晶体管."
晶体管越少,点缺陷可能性越小,“我们的密度非常低,所以在制造过程中出现点缺陷从而导致晶体管死亡的可能性非常低。良率最终会很高,因为它不是一个非常密集集成的晶体管电路。”
Harris说,这项技术的第一批应用将是对实时视频进行分析的公司。这些公司可能包括保安公司,也可能包括监控生产线的公司,这些公司使用摄像机来发现零件是否有缺陷。另外,它还可能对语音分析和其他AI应用有用。
原文链接:
https://www.datacenterdynamics.com/en/analysis/building-light-into-chips/
